Все остальные роботы
User-agent: *
Эту группу читает любой робот, у которого нет своей группы.
- Открывает весь сайт.
Google эту директиву игнорирует, Bing — читает.
Тема
Сгенерируйте robots.txt, которому можно доверять: каждое правило объясняется, пока вы его вводите, файл перечитывает наша проверка robots.txt по RFC 9309 и по правилам самого Google, а вердикт для любого робота и любого пути виден ещё до публикации.
Один файл на хост и протокол: для www.example.com и example.com нужны отдельные файлы.
Источник: RFC 9309, по состоянию на 26 октября 2026 г..
Эту группу читает любой робот, у которого нет своей группы.
Выберите, что получает каждый известный робот. Робот со своей группой читает только её.
Сканируют сайты, чтобы построить поисковый индекс. Закрытые страницы всё равно могут попасть в выдачу по ссылкам с других сайтов, но их содержимое прочитано не будет.
Собирают страницы для обучения моделей. Отдельный токен позволяет отказаться от обучения, не выпадая из поиска.
Загружают страницы, чтобы отвечать на вопросы со ссылкой на ваш сайт.
Загружают одну страницу, потому что о ней попросил человек, поэтому некоторые операторы предупреждают, что такие роботы могут игнорировать robots.txt.
Запрещая их, вы отказываете человеку, а не сканированию: когда кто-то просит ИИ-ассистента открыть вашу страницу, ассистент, который соблюдает файл, не прочитает её для него. Если вы против обучения, запретите роботов для обучения выше.
Превью ссылок, инструменты владельца сайта, проверка рекламы, архивы и роботы, чьи операторы называют другую задачу или не называют никакой.
Ваш robots.txt/robots.txt
User-agent: *Allow: /ОшибкаПредупреждениеЗаметка23 B из 500 KiB
1 предупреждение
Что делать Это самая дешёвая строка в файле, и её читает любой робот. Добавьте Sitemap: с полным адресом вашего sitemap.
Выберите робота и путь: вердикт, решающее правило и группу, которую читает робот, определяет тот же алгоритм сопоставления, что работает в проверке robots.txt.
Этому роботу можно запрашивать этот URL.
User-agent: *начинается в строке 1
Ни одна группа не называет этого робота, поэтому действует группа *.
Allow: /строка 2
/any-page
/
Сравниваются только путь и строка запроса, байт за байтом после процентного кодирования. Хост, протокол и фрагмент в правило никогда не входят.
Напишите правила, сохраните их как простой текстовый файл с именем robots.txt в кодировке UTF-8 и загрузите его в корень сайта, чтобы он открывался по адресу https://example.com/robots.txt. Отправлять ничего не нужно: роботы сами запрашивают этот адрес.
Google укладывает это в три предложения: «Файл должен называться robots.txt. На сайте должен быть только один такой файл. Файл robots.txt нужно разместить в корневом каталоге того хоста сайта, к которому он относится». Это должен быть «текстовый файл в кодировке UTF-8», и «поисковые роботы Google автоматически найдут его и начнут применять».
Генератор выше начинает с пресета, объясняет каждое правило по ходу ввода и перечитывает результат парсером и алгоритмом сопоставления нашей проверки robots.txt, прежде чем вы его скопируете. Скачанный файл называется robots.txt: UTF-8 без метки порядка байтов, только переводы строки LF и никаких дат или комментариев, о которых вы не просили.
https://example.com/robots.txtОтправлять файл не нужно: роботы Google находят его сами.
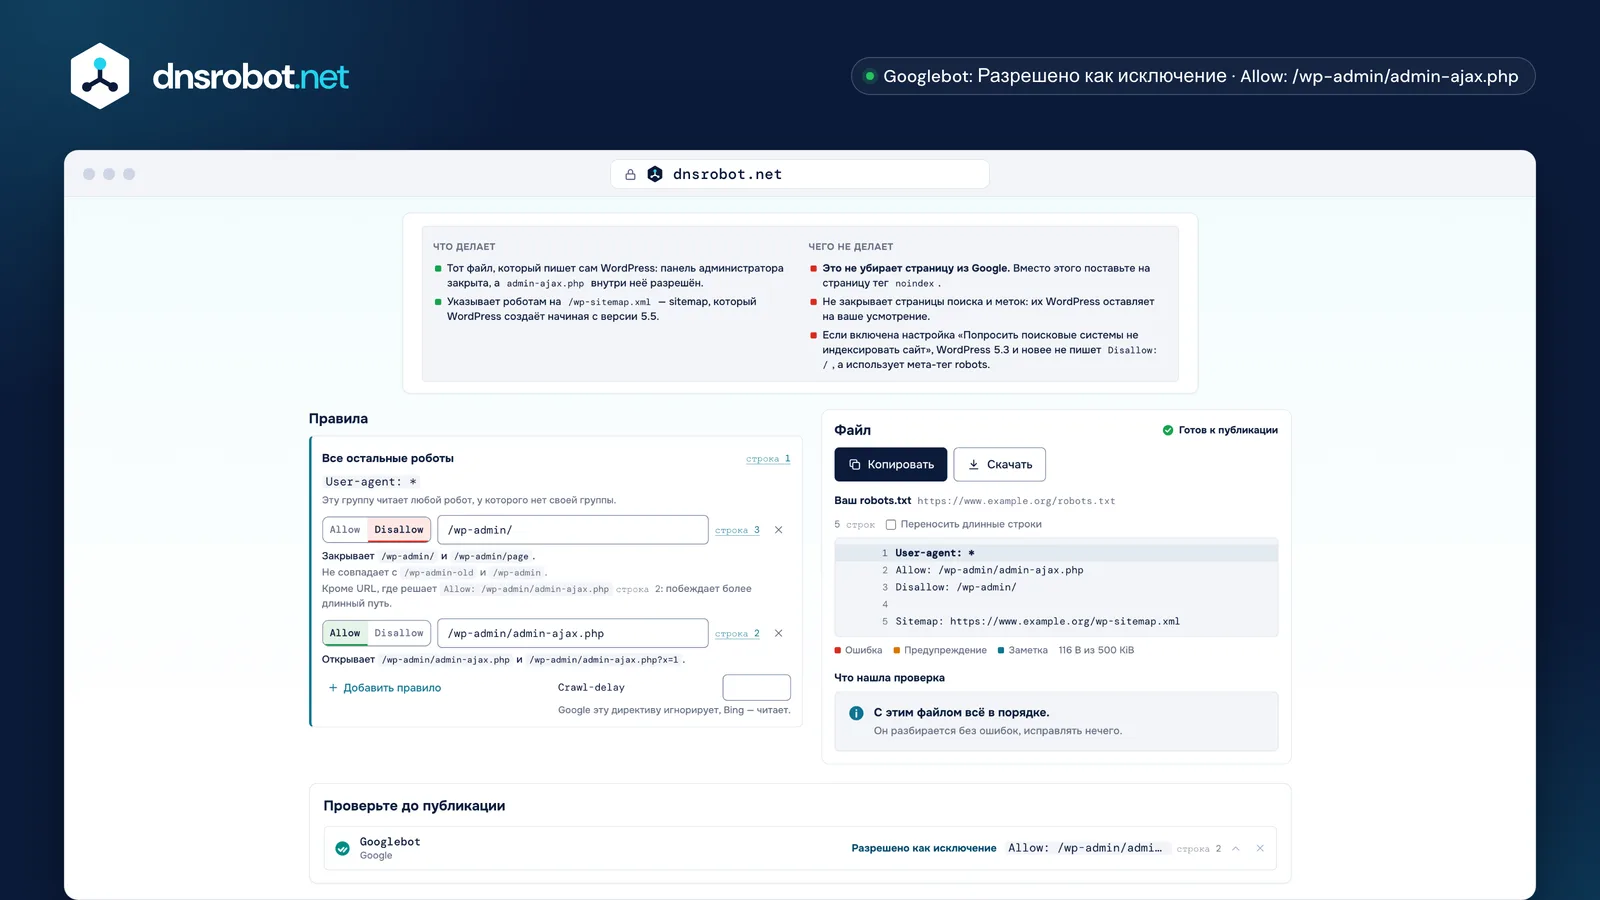
 Что делает пресетИ чего не делает: ни один из этих пресетов не убирает страницу из Google, и каждый прямо об этом говорит.Каждое правило объясненоПути, которые правило закрывает, и те, которые оно пропускает, — по тому же алгоритму сопоставления, что выносит каждый вердикт, — и более длинное правило, которое делает исключение.Файл и находкиФайл с номерами строк, который тот же аудит, что и в проверке robots.txt, перечитывает до того, как вы его скопируете.ВердиктВыберите робота и путь: разрешено или запрещено, какое правило это решило и в какой строке, и какую группу читает робот.
Группы и строки Sitemap. Группа начинается с одной или нескольких строк User-agent, которые называют роботов, а за ними идут правила Allow и Disallow, которые эти роботы соблюдают; строка Sitemap стоит отдельно, вне всех групп.
RFC 9309 определяет группу как «одну или несколько строк user-agent, за которыми следуют одно или несколько правил», а робот соблюдает ровно одну группу: ту, где указан его собственный токен продукта, или группу *, если такой нет. Google читает четыре поля и никаких других: user-agent, allow, disallow и sitemap.
Имена полей не чувствительны к регистру, а пути — чувствительны: в собственном примере Google disallow: /file.asp распространяется на /file.asp, «но не на» /FILE.asp. Строка Sitemap: должна содержать полный адрес с протоколом и хостом; любой другой вариант этот генератор отклоняет и объясняет почему.
User-agent: *Начинает группу для каждого робота без своей группыDisallow: /cart/Путь, который этим роботам загружать нельзяAllow: /cart/helpИсключение: длиннее, чем Disallow, поэтому побеждает User-agent: GPTBotНачинает группу, которая называет двух роботовUser-agent: ClaudeBotDisallow: /Обоим закрыт весь сайт Sitemap: https://www.example.org/sitemap.xmlВне всех групп: полный адрес* и $: как срабатывает правилоКогда под URL подходят несколько правил, побеждает правило с самым длинным путём, какого бы типа оно ни было, а при равенстве побеждает Allow. * означает любую последовательность символов, а $ отмечает конец URL; больше ничего особого в пути нет.
RFC 9309: «ДОЛЖНО использоваться самое специфичное совпадение. Самое специфичное совпадение — то, в котором больше всего октетов», и «если правило allow и правило disallow равнозначны, СЛЕДУЕТ использовать правило allow». Так работает и собственный файл WordPress: Disallow: /wp-admin/ закрывает папку, а более длинное Allow: /wp-admin/admin-ajax.php открывает в ней один файл.
Правило без $ — это префикс, поэтому Disallow: /admin закрывает и /administrator; добавьте слеш (/admin/), если имеете в виду папку. Под каждым правилом редактор выше показывает пути, которые оно захватывает, и некоторые из тех, что нет, — по тому же алгоритму сопоставления, что выносит каждый вердикт, — и отмечает правило, которое всегда проигрывает другому.
* и $ — и что на самом деле захватывает каждый шаблон/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ и + — обычные символы. Регулярных выражений в robots.txt нет.
/admin/report.pdfПобеждает Allow: это правило совпадает с большей частью пути.
Disallow: /files/7 символовAllow: /files/7 символовДлина одинаковая, поэтому побеждает Allow. «Наименее строгое правило», как говорит Google.
Все три уже отдают свой файл, а пресеты выше пишут то, что описывает документация каждой платформы: WordPress закрывает свою панель администратора, но разрешает admin-ajax.php, Shopify закрывает корзины, оформление заказа и коллекции с фильтрами или сортировкой, а Next.js отдаёт файл, который вы положили в app/robots.txt.
WordPress пишет свой файл в коде, в функции do_robots(): User-agent: *, Disallow для пути панели администратора и Allow для admin-ajax.php, а на публичном сайте начиная с WordPress 5.5 ещё и строку Sitemap: для /wp-sitemap.xml. Если включена настройка «Попросить поисковые системы не индексировать сайт», WordPress 5.3 и новее больше не пишет Disallow: /, а использует мета-тег robots.
Shopify говорит, что его стандартный файл «подходит большинству магазинов». Загрузить свой файл нельзя: чтобы что-то изменить, нужно править шаблон темы robots.txt.liquid, а Shopify называет это «неподдерживаемой настройкой». Next.js отдаёт app/robots.txt как есть или собирает файл из app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlПишет сам WordPress. Изменить можно плагином или фильтром robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlСтандартный файл Shopify. Меняется в шаблоне темы robots.txt.liquid.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlВаш собственный файл в app/robots.txt или app/robots.ts, который отдаётся по адресу /robots.txt.
Группа с именем робота и Disallow: / под ней работает для каждого робота, чей оператор говорит, что соблюдает robots.txt, и только для них. Это просьба, которую робот выполняет, а не замок: робот, который игнорирует файл, всё равно может загрузить любую страницу.
У большинства ИИ-компаний несколько роботов, поэтому решайте отдельно для каждой задачи. Запрещая робота для обучения, например GPTBot или ClaudeBot, вы закрываете того, кто собирает страницы для моделей; запрещая робота для ответов, например OAI-SearchBot или PerplexityBot, вы ещё и выпадаете из ссылок, которые показывают эти ассистенты. Токен Google для обучения — это не Googlebot: «Google-Extended никак не влияет на показ сайта в Google Поиске и не используется в качестве фактора ранжирования в этом сервисе».
Третий вид устроен иначе. ChatGPT-User, Claude-User, Perplexity-User и Amzn-User загружают одну страницу, потому что человек попросил ассистента её открыть, так что, запрещая их, вы отказываете этому человеку, а некоторые их операторы говорят, что такие загрузчики всё равно могут игнорировать robots.txt. Поэтому в списке роботов выше они вынесены в отдельный раздел.
GPTBotСоблюдаетOAI-SearchBotСоблюдаетChatGPT-UserМожет игнорироватьClaudeBotСоблюдаетClaude-SearchBotСоблюдаетClaude-UserСоблюдаетPerplexityBotСоблюдаетPerplexity-UserМожет игнорироватьGoogle-ExtendedТолько токенТакого робота нетТакого робота нетApplebot-ExtendedТолько токенТакого робота нетТакого робота нетmeta-externalagentСоблюдаетmeta-webindexerСоблюдаетmeta-externalfetcherМожет игнорироватьAmazonbotСоблюдаетТакого робота нетAmzn-UserМожет игнорироватьОн просит роботов не загружать страницу, но не просит поисковую систему её не показывать. Google «может индексировать URL и показывать его в результатах поиска без фрагмента», если на него ссылаются другие страницы. Чтобы страницы не было в выдаче, используйте noindex и оставьте страницу открытой для сканирования, чтобы тег можно было прочитать.
Search Console называет это «Проиндексировано, несмотря на блокировку в файле robots.txt». И Google прямо говорит, что «чтобы правило noindex сработало, страница или ресурс не должны быть заблокированы файлом robots.txt»: собственный noindex запрещённой страницы никто не увидит, потому что робот эту страницу не загружает.
Поэтому каждый пресет выше говорит, чего он не делает. Disallow: / в пресете для тестового сайта не пускает вежливых роботов, но URL тестового сайта, на который где-то есть ссылка, всё равно может попасть в выдачу: закройте тестовый сайт паролем и никогда не переносите эту строку на рабочий сайт.
<meta name="robots" content="noindex">Никогда не читаетсяЧтобы страницы не было в выдаче: впустите робота и поставьте noindex либо пускайте только после входа в аккаунт.
В корне того хоста, к которому он относится, по адресу /robots.txt, по одному файлу на хост и протокол. https://example.com/robots.txt ничего не говорит о https://www.example.com или https://shop.example.com: каждому нужен свой файл, а robots.txt внутри папки не читается никогда.
Google: «Файл robots.txt должен находиться в каталоге верхнего уровня и передаваться по поддерживаемому протоколу». Отчёт о файлах robots.txt в Search Console показывает файлы 20 главных хостов ресурса по отдельности, причём HTTP и HTTPS учитываются раздельно.
Введите свой сайт вверху генератора, и он покажет точный адрес, по которому должен открываться файл, заполнит строку Sitemap: для этого хоста и даст ссылку на проверку robots.txt, которая прочитает опубликованный файл, как только он появится.
https://example.com/robots.txtВсе URL на https://example.comhttps://www.example.com/robots.txtТолько www.example.com: это отдельный хостhttp://example.com/robots.txtТолько сайт на http://: это отдельный протоколhttps://shop.example.com/robots.txtТолько shop.example.comhttps://example.com/blog/robots.txtНичего: robots.txt в папке не читается никогдаGoogle не читает ни одну из них. Crawl-delay читает Bing, Clean-param — Yandex, Host нет ни в стандарте, ни в списке Google, а Content-Signal от Cloudflare говорит о том, для чего можно использовать ваш контент, а не о том, что можно сканировать.
Google перечисляет свои четыре поля и добавляет, что «другие поля, например crawl-delay, не поддерживаются». В блоге самого Bing сказано, что «директива crawl-delay принимает в качестве значений только положительные целые числа», поэтому редактор отклоняет дробное значение, а не записывает его. Текущую справку Bing не удалось прочитать, чтобы подтвердить диапазон или единицу измерения, поэтому эта страница не называет ни того, ни другого.
Ни одна из них не ломает файл: RFC 9309 устанавливает, что разбор других записей «НЕ ДОЛЖЕН мешать разбору явно определённых записей». Из этих четырёх генератор пишет только Crawl-delay — с пометкой, кто его читает.
User-agentЧитаетЧитаетЧитаетAllowЧитаетЧитаетЧитаетDisallowЧитаетЧитаетЧитаетSitemapЧитаетЧитаетЧитаетCrawl-delayИгнорируетЧитаетНе подтвержденоClean-paramИгнорируетИгнорируетЧитаетHostИгнорируетИгнорируетНе подтвержденоnoindexИгнорируетНе подтвержденоНе подтвержденоContent-SignalИгнорируетНе подтвержденоНе подтвержденоДважды. До публикации — в блоке «Проверьте до публикации» выше: выберите робота и путь и посмотрите, какое правило решает. После загрузки — проверкой robots.txt по опубликованному файлу, потому что ответ сервера значит не меньше, чем содержимое файла.
Файл, который отвечает 404, считается отсутствующим, поэтому любой робот может брать всё; ответ 500 или 503 означает, что робот, который следует стандарту, не должен брать ничего. RFC 9309 §2.3.1.4: робот «ДОЛЖЕН считать, что запрещено всё». Google смягчает это собственной лестницей, показанной на схеме.
Собственного инструмента проверки robots.txt у Google больше нет: Search Central объявил о его отключении 15 ноября 2023 года, а пришедший ему на смену отчёт о файлах robots.txt показывает файл, который загрузил Google, но не проверяет URL по правилу. Эту проверку выполняют блок «Проверьте до публикации» в генераторе выше и проверка robots.txt.
200Следует правилам из файла.301, 302Проходит не меньше пяти переходов, затем останавливается. Тогда Google считает файл ответом 404.403, 404Сканирует всё, как будто файла нет.429Не сканирует ничего. Google относит этот ответ к 5xx, а не к 4xx.500, 503По стандарту не сканирует вообще ничего.Имени нет в DNSЧитать нечего: сайта нет, а значит, нет и вердикта.Каждая из дорогих ошибок — одна короткая строка: Disallow: /, оставшийся от тестовой версии, префикс, который заходит дальше задуманного, строка Sitemap:, записанная как путь, путь без начального слеша и строка noindex, которую Google перестал читать в 2019 году.
Каждую из них здесь видно до того, как вы скопируете файл. Аудит проверки robots.txt работает здесь по ходу ввода, и его находки стоят под файлом; строку, которую робот отверг бы, генератор не пишет вовсе, а редактор прямо рядом с ней объясняет, почему она не попала в файл.
Одна ошибка — это пара, а не строка: URL, который здесь запрещён и при этом несёт noindex на странице. Робот никогда не загружает страницу, поэтому никогда не видит noindex, и URL может остаться в результатах поиска. Выберите одно: закройте сканирование или впустите робота и скажите ему не индексировать.
Disallow: /Осталось от тестовой версии: весь рабочий сайт закрыт для всех роботов.Disallow: /adminЗакрывает также /administrator и /admin-tools. Добавьте завершающий слеш.Allow: / под User-agent: *Робот, у которого где-либо в файле есть своя группа, это никогда не читает.Sitemap: /sitemap.xmlСтрока Sitemap должна содержать полный адрес с хостом.Disallow: adminПуть начинается с /. Это правило не совпадает ни с чем.noindex: /private/Не работает с 2019 года. Страница остаётся доступной для сканирования и индексирования.*, где стоит ваш Allow. Редактор выше отмечает правило, которое всегда проигрывает другому, а блок «Проверьте до публикации» называет решающее правило и группу, которую прочитал робот.Загрузка robots.txt любого сайта, проверка, закрыт ли URL для Googlebot или AI-краулеров, и поиск синтаксических ошибок
Сканирование сайта и создание XML карты сайта, HTML карты сайта и наглядного дерева сайта
Поиск и проверка XML sitemap сайта: синтаксис, лимиты URL, даты lastmod, конфликты с robots.txt, битые URL и URL с редиректами
Проверка title, meta description, canonical, hreflang, тегов Open Graph и X card страницы с превью для Google и соцсетей
Анализ HTTP заголовков ответа и оценка заголовков безопасности
Определение браузера, ОС, типа устройства, движка рендеринга и архитектуры CPU по строке user agent