











Проверка robots.txt
Проверка robots.txt, которая показывает ход решения: правило, решившее судьбу вашего URL, с номером строки; группу, которую робот на самом деле читает, и почему остальные пропущены; и что код ответа вашего файла значит для всего сайта.
Введите домен, чтобы прочитать его файл, или полный URL, например example.com/admin/, чтобы заодно проверить этот путь.
- ЗапросGET /robots.txt
- Разборгруппы, правила, sitemap
- Группакакие правила соблюдает робот
- Вердиктчто можно сканировать каждому роботу
Как проверить robots.txt теперь, когда тестера Google больше нет
Введите домен выше и нажмите «Проверить robots.txt». Мы один раз загрузим файл с нашего сервера, а затем проверим по нему любой URL, который вы введёте, прямо в вашем браузере и для любого выбранного робота — то же самое раньше делал инструмент проверки файла robots.txt от Google, пока его не отключили.
Google объявил об изменении 15 ноября 2023 года: «В рамках этого обновления мы прекращаем поддержку инструмента проверки robots.txt». Старый инструмент исчез в декабре 2023 года, а пришедший ему на смену отчёт о файлах robots.txt в Search Console — вещь совсем другого рода.
Этот отчёт перечисляет файлы, которые Google уже загрузил для 20 главных хостов вашего подтверждённого ресурса, с датой проверки, размером в байтах и числом проблем. Проверить URL по правилу, проверить робота не от Google или заглянуть на чужой сайт он не может. Эта страница умеет все три вещи.
- Файл, который Google загрузил последним
- Его размер и дата проверки
- Число ошибок разбора
- Разрешён ли этот URL для этого робота?
- Какое правило решило и в какой строке
- Робот не от Google
- Чужой сайт
Google объявил об изменении 15 ноября 2023 года и убрал инструмент проверки в декабре 2023 года.
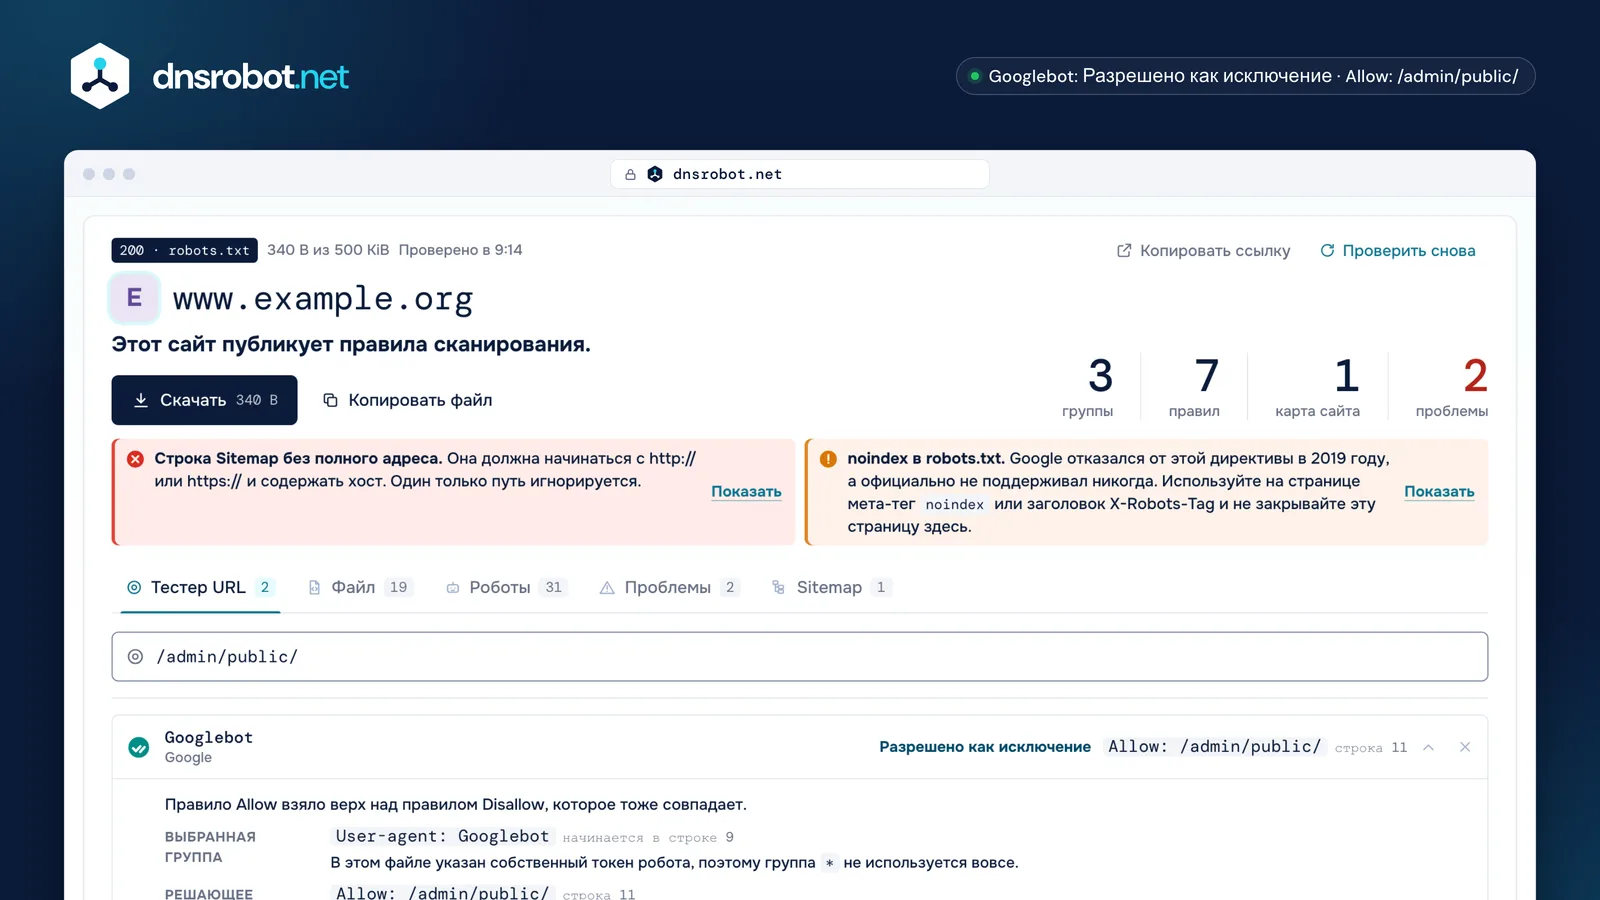
 СледствиеНе просто код ответа, а то, что он значит для всего сайта. 404 здесь позволяет любому роботу брать всё; 503 означает, что робот, который следует стандарту, не берёт ничего.Решающее правилоПравило, которое решило судьбу этого URL для этого робота, с номером строки и правилом, которое оно перевесило. Побеждает самое длинное совпадение, а при равенстве — Allow.Выбранная группаКакую группу робот прочитал на самом деле и почему остальные пропущены. Этот шаг другие инструменты не показывают.НаходкиКаждая проблема на своей строке файла и что с ней делать.
Как Google выбирает, какая группа действует для робота?
Робот соблюдает ровно один набор правил. Он ищет группу, в строке User-agent которой указан его собственный токен продукта, и только если такой нет, переходит к группе *. Группа * — запасной вариант, а не добавка.
RFC 9309 говорит прямо: «Роботы ДОЛЖНЫ искать группу, соответствующую токену продукта, без учёта регистра» и «[если] подходящей группы нет, роботы ДОЛЖНЫ соблюдать группу со строкой user-agent со значением *, если она есть». Google говорит то же своими словами: «Для конкретного робота действительна только одна группа».
Отсюда два следствия, и вместе они дают большую часть путаницы. Несколько групп с одним и тем же токеном сливаются в одну, так что оба блока User-agent: Googlebot учитываются. Но группа с именем робота и группа * не сливаются никогда: Allow: / под * ничего не даёт Googlebot, если есть группа Googlebot. Googlebot-Image и другие роботы Googlebot-* переходят к группе googlebot — это поведение, которое робот добавляет поверх алгоритма сопоставления: в открытом парсере самого Google его нет.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Есть группа с собственным токеном этого робота?Читать эту группу. Группа
*не используется. - 2Таких групп несколько?Читать их как одну группу.
- 3Есть группа
*?Читать группу*. - —Правила не действуют. Сканировать можно всё.
Allow: / под * не читается никогда.
*.Allow или Disallow: побеждает самое длинное совпадение
Когда URL подходит под несколько правил, побеждает правило с самым длинным путём, какого бы типа оно ни было. Если Allow и Disallow одинаковой длины, побеждает Allow.
RFC 9309: «ДОЛЖНО использоваться самое специфичное совпадение. Самое специфичное совпадение — то, в котором больше всего октетов», и «если правило allow и правило disallow равнозначны, СЛЕДУЕТ использовать правило allow». Google описывает то же поведение: при конфликте правил применяется «наименее строгое правило».
Октеты, а не символы: путь с буквами с диакритикой или с %2F сравнивается после процентного кодирования — именно здесь наивные инструменты ошибаются. Сравниваются только путь и строка запроса, начиная с первого символа, и они чувствительны к регистру, хотя имена директив — нет: Disallow: /File.pdf никак не действует на /file.pdf.
/admin/report.pdfПобеждает Allow: это правило совпадает с большей частью пути.
Disallow: /files/7 символовAllow: /files/7 символовДлина одинаковая, поэтому побеждает Allow. «Наименее строгое правило», как говорит Google.
Всего два подстановочных знака: `*` и `$`
* означает любую последовательность символов, а $ отмечает конец URL. Больше ничего нет: ни регулярных выражений, ни особого смысла у ?, ., [ или + — всё это обычные символы.
Правило без $ — это префикс, поэтому Disallow: /admin закрывает также /administrator и /admin-tools. Добавьте завершающий слеш (/admin/), если имеете в виду папку, и $, если имеете в виду ровно этот URL. Disallow: /*.pdf$ закрывает все PDF; Disallow: /*? закрывает все URL со строкой запроса.
«Тестер URL» выше показывает пути, которые правило захватывает заодно, — по тому же алгоритму сопоставления, что дал вердикт, — так что правило, которое заходит дальше задуманного, видно ещё до публикации.
* и $ — и что на самом деле захватывает каждый шаблон/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ и + — обычные символы. Регулярных выражений в robots.txt нет.
Что означает код ответа вашего robots.txt?
4xx и 5xx на один и тот же сломанный файл дают противоположные результаты. 4xx понимается так, будто файла нет, поэтому робот может брать всё. 5xx означает, что файл не определён, поэтому робот, который соблюдает стандарт, не должен брать ничего.
RFC 9309 §2.3.1.3: если код ответа говорит, что файл «недоступен роботу, робот МОЖЕТ обращаться к любым ресурсам на сервере». §2.3.1.4: если он «недостижим из-за ошибок сервера или сети… робот ДОЛЖЕН считать, что запрещено всё». Google обрабатывает «все ошибки 4xx, кроме 429, так, как если бы действительного файла robots.txt не было», а значит, 429 оказывается на стороне 5xx.
Затем Google смягчает случай 5xx собственной лестницей: первые 12 часов он не сканирует сайт, следующие 30 дней пользуется последней удачной копией, а после этого, если остальной сайт доступен, ведёт себя так, будто robots.txt нет вовсе. По редиректам Google проходит не меньше пяти переходов, а затем останавливается и, по его словам, «интерпретирует ситуацию как ошибку 404, относящуюся к файлу robots.txt», то есть сканирует свободно. А имя, которого нет в DNS, — это не сайт, который кого-то закрывает: нет ни файла, ни вердикта.
200Следует правилам из файла.301, 302Проходит не меньше пяти переходов, затем останавливается. Тогда Google считает файл ответом 404.403, 404Сканирует всё, как будто файла нет.429Не сканирует ничего. Google относит этот ответ к 5xx, а не к 4xx.500, 503По стандарту не сканирует вообще ничего.Имени нет в DNSЧитать нечего: сайта нет, а значит, нет и вердикта.- 1Первые 12 часовНе сканирует сайт и повторяет запрос файла
- 2До 30 днейПользуется последней удачной копией robots.txt
- 3После 30 днейЕсли сайт доступен, ведёт себя так, будто robots.txt нет
Убирает ли robots.txt страницу из Google?
Нет. Он просит робота не загружать страницу, но не просит поисковую систему её не показывать. Google не может прочитать запрещённую страницу, но, по его словам, «может индексировать URL и показывать его в результатах поиска без фрагмента», если на него ссылаются другие страницы.
Это статус Search Console «Проиндексировано, несмотря на блокировку в файле robots.txt»: «Google не будет запрашивать и сканировать страницу, но всё равно может проиндексировать её по информации со страницы, которая ссылается на заблокированную». Решение, которое предлагает сам Google: «удалите блокировку в robots.txt и используйте директиву noindex».
Поэтому самая частая ошибка в robots.txt — это пара, а не одна строка: URL, который одновременно запрещён здесь и несёт noindex. Google прямо говорит, что «если страница заблокирована файлом robots.txt… робот никогда не увидит правило noindex, и страница по-прежнему может появляться в результатах поиска». Выберите одно: закройте сканирование или впустите робота и скажите ему не индексировать.
- Робот
- Читает robots.txt
- URL запрещён
- Не загружает страницу
<meta name="robots" content="noindex">Никогда не читаетсяЧтобы страницы не было в выдаче: впустите робота и поставьте noindex либо пускайте только после входа в аккаунт.
Как заблокировать ChatGPT, Claude и других ИИ-роботов?
Обычной группой для каждого. ИИ-компании публикуют токены продуктов точно так же, как поисковые системы, и у большинства их несколько: один для обучения, один для ответа на вопрос со ссылкой на источник и один для загрузки страницы по просьбе человека.
Эти три стоит различать. Закрыв робота для обучения, вы не пускаете свои страницы в модель; закрыв робота для ответов, вы ещё и выпадаете из ссылок, которые показывают эти продукты. На вкладке «Роботы» выше указаны назначение каждого, его токен и то, что говорит о соблюдении правил документация самого оператора, — так вы можете отказаться от обучения, не исчезая из ответов ИИ.
Некоторые операторы прямо говорят, что робот, загружающий страницу по просьбе одного человека, может игнорировать robots.txt, потому что действует от имени пользователя, а не сканирует. В таблице такие роботы отмечены. А строки Content-Signal от Cloudflare, которые публикует всё больше сайтов, — это заявление о том, для чего можно использовать ваш контент, а не правило сканирования: эта страница сохраняет их и объясняет, а не называет ошибкой.
GPTBotСоблюдаетOAI-SearchBotСоблюдаетChatGPT-UserМожет игнорировать
ClaudeBotСоблюдаетClaude-SearchBotСоблюдаетClaude-UserСоблюдает
PerplexityBotСоблюдаетPerplexity-UserМожет игнорироватьGoogle-ExtendedТолько токенТакого робота нетТакого робота нет
Applebot-ExtendedТолько токенТакого робота нетТакого робота нет
meta-externalagentСоблюдаетmeta-webindexerСоблюдаетmeta-externalfetcherМожет игнорировать
AmazonbotСоблюдаетТакого робота нетAmzn-UserМожет игнорировать- ОбучениеСобирает страницы для обучения модели.
- Ответы ИИЗагружает страницы, чтобы ответить на вопрос, обычно со ссылкой на ваш сайт.
- Запрос человекаЗагружает одну страницу, потому что кто-то о ней попросил. Некоторые операторы говорят, что такой робот может игнорировать robots.txt.
Crawl-delay, Clean-param, Host и Content-Signal: кто что читает?
Google читает четыре поля и никаких других: user-agent, allow, disallow и sitemap. Всё остальное в robots.txt читает кто-то другой или никто — и неизвестная строка никогда не считается ошибкой.
Google перечисляет свои четыре поля и добавляет, что «другие поля, например crawl-delay, не поддерживаются». Bing Crawl-delay поддерживает — об этом в блоге самого Bing: «директива crawl-delay принимает в качестве значений только положительные целые числа». Clean-param — директива Yandex, и больше ничья. Host нет ни в стандарте, ни в списке Google.
Ни одна из них файл не ломает. RFC 9309 требует, чтобы разбор других записей «НЕ ДОЛЖЕН мешать разбору явно определённых записей», поэтому робот, не знающий строку, просто её пропускает. По-настоящему мёртвые директивы — это noindex и nofollow внутри robots.txt: в 2019 году Google убрал код, который их обрабатывал, и сегодня в Google они не делают ничего.

User-agentЧитаетЧитаетЧитаетAllowЧитаетЧитаетЧитаетDisallowЧитаетЧитаетЧитаетSitemapЧитаетЧитаетЧитаетCrawl-delayИгнорируетЧитаетНе подтвержденоClean-paramИгнорируетИгнорируетЧитаетHostИгнорируетИгнорируетНе подтвержденоnoindexИгнорируетНе подтвержденоНе подтвержденоContent-SignalИгнорируетНе подтвержденоНе подтверждено- Google поддерживает четыре поля и прямо об этом говорит: user-agent, allow, disallow и sitemap.
- Блог самого Bing подтверждает Crawl-delay. Диапазон и единицу измерения мы не приводим: текущую справку Bing не удалось прочитать, чтобы их проверить.
- Google отказался от неё в 2019 году, а в стандарт она никогда не входила.
- Content Signals Policy от Cloudflare: заявление о том, как можно использовать контент, а не правило сканирования.
Предел в 500 KiB и то, что остаётся за ним
Google читает первые 500 кибибайт robots.txt и игнорирует всё, что дальше, — нигде не сообщая об ошибке. RFC 9309 задаёт 500 KiB как нижнюю границу предела разбора для робота; Google называет это значение верхней границей.
Google: «Google ограничивает размер файла robots.txt 500 кибибайтами (KiB). Содержимое за пределами максимального размера файла игнорируется». Ничто вас не предупредит. Файл в 600 KiB не становится недопустимым — просто его последних 100 KiB для Googlebot не существует, и Disallow там внизу ничего не защищает.
Сайты упираются в него чаще, чем кажется: по правилу на каждый параметр рекламной кампании, на каждый фасетный фильтр, на каждую старую тестовую папку. Проверка выше сверяет файл с этой чертой и сообщает, сколько осталось за ней. Заменяйте длинные списки шаблонами (Disallow: /*?filter=) и ставьте важные правила наверх.
Disallow: /cart/ · Строка 12СоблюдаетсяDisallow: /private/ · Строка 9 412Никогда не читаетсяФайл по-прежнему отвечает 200 и разбирается без ошибок. Ничто и нигде не сообщает вам, что остаток отброшен.
Частые ошибки в robots.txt и как их найти
Большинство сломанных файлов robots.txt ломаются одним из шести способов, и ни один из них не заметен, пока файл чем-нибудь не проверят: он по-прежнему отвечает 200, разбирается без ошибок и выглядит правильно.
Ошибка, которую знают все, — Disallow: /, забытый при переезде сайта с тестовой версии в рабочую. Остальные пять: правило, которое заходит дальше задуманного (например, Disallow: /admin цепляет и /administrator); Allow: / под *, которое группа с именем робота тихо игнорирует; строка Sitemap:, записанная как путь, а не полный адрес; путь без начального слеша, который не совпадает ни с чем; и строка noindex, которую Google перестал читать в 2019 году.
Запустите проверку выше и откройте вкладку «Проблемы»: каждая находка стоит на своей строке файла вместе с тем, что с ней делать. Если вы не проверяете файл, а правите его, генератор robots.txt пишет файл, который этот же инструмент проверки уже прочитал.
Источники
- RFC 9309, Robots Exclusion Protocol: группы, приоритет правил, сопоставление после процентного кодирования, коды ответа и нижняя граница в 500 KiB
- Google Search Central: как Google интерпретирует robots.txt, как создать и отправить файл robots.txt и как запретить индексирование с помощью noindex
- Справка Google Search Console: отчёт о файлах robots.txt и отчёт об индексировании страниц
- Bing: Crawl-delay и робот Bing и Yandex: Clean-param
- Открытый парсер robots.txt от Google — тот самый механизм сопоставления, которым пользуется сам Googlebot
- Токен, назначение и отношение к robots.txt каждого робота взяты из документации его собственного оператора — ссылка стоит рядом с ним на вкладке «Роботы»
Disallow: /Осталось от тестовой версии: весь рабочий сайт закрыт для всех роботов.Disallow: /adminЗакрывает также /administrator и /admin-tools. Добавьте завершающий слеш.Allow: / под User-agent: *Робот, у которого где-либо в файле есть своя группа, это никогда не читает.Sitemap: /sitemap.xmlСтрока Sitemap должна содержать полный адрес с хостом.Disallow: adminПуть начинается с /. Это правило не совпадает ни с чем.noindex: /private/Не работает с 2019 года. Страница остаётся доступной для сканирования и индексирования.Проверка robots.txt: частые вопросы
Что случилось с инструментом проверки файла robots.txt от Google?
Почему игнорируется мой Allow: / под User-agent: *?
* пропускает целиком: это запасной вариант, а не добавка. Группы сливаются, только когда несколько из них называют один и тот же токен. «Тестер URL» выше показывает, какая группа выбрана для каждого робота и почему не выбраны остальные.Запрещает ли robots.txt индексировать страницу?
noindex или заголовок X-Robots-Tag — либо закройте страницу за входом в аккаунт.Почему не работает мой noindex?
noindex, поэтому страница может и дальше появляться в результатах поиска по ссылкам с других сайтов. Google говорит об этом прямо: чтобы noindex сработал, страница «не должна быть заблокирована файлом robots.txt». Удалите строку Disallow и оставьте noindex.Что значит 404 на robots.txt? А 500?
Если подходят и Allow, и Disallow, какое правило побеждает?
Какие подстановочные знаки работают в robots.txt?
* означает любую последовательность символов, а $ отмечает конец URL. Всё остальное понимается буквально: ?, ., [, ] и + совпадают сами с собой, а регулярных выражений нет. Правило без $ — это префикс, поэтому Disallow: /admin захватывает и /administrator. Пути чувствительны к регистру, а имена директив, такие как Disallow, — нет.Поддерживает ли Google Crawl-delay?
Каким может быть размер файла robots.txt?
Как заблокировать ИИ-роботов вроде GPTBot и ClaudeBot?
Disallow: / — точно так же, как поисковой системе. Большинство ИИ-компаний держат несколько роботов с разными задачами: один для обучения, один для ответов на вопросы со ссылкой на ваш сайт и один, который загружает отдельную страницу по просьбе человека. На вкладке «Роботы» выше указаны каждый токен, его назначение и то, что о соблюдении правил говорит оператор, — так вы откажетесь от обучения, не теряя ссылок в ответах ИИ.Проверка robots.txt и валидатор — это одно и то же?
Опасен ли robots.txt для безопасности сайта?
Disallow: /admin-backup/ — указатель ровно на то, что вы хотели спрятать. Ничто в нём не мешает доступу: робот соблюдает его лишь потому, что так решил его оператор. Защищайте закрытые пути аутентификацией или правилом файрвола, а эта проверка укажет на пути в вашем файле, которые выглядят как приглашение.Чего-то не хватает?Предложите функцию или новый инструмент
Ещё инструменты для сканирования и индексирования
Проверка sitemap
Поиск и проверка XML sitemap сайта: синтаксис, лимиты URL, даты lastmod, конфликты с robots.txt, битые URL и URL с редиректами
Генератор карты сайта
Сканирование сайта и создание XML карты сайта, HTML карты сайта и наглядного дерева сайта
Проверка HTTP-заголовков
Анализ HTTP заголовков ответа и оценка заголовков безопасности
Проверка редиректов
Проверка редиректов URL, цепочек перенаправлений и кодов HTTP статуса для SEO
Мой User Agent
Определение браузера, ОС, типа устройства, движка рендеринга и архитектуры CPU по строке user agent
Анализ ссылок
Анализ всех ссылок на странице с определением dofollow/nofollow и проверкой HTTP статуса