











Kiểm tra robots.txt
Công cụ kiểm tra robots.txt cho bạn thấy cách nó đi tới kết luận: quy tắc đã quyết định URL của bạn kèm số dòng, nhóm mà trình thu thập thật sự đọc và vì sao các nhóm khác bị bỏ qua, cùng ý nghĩa của mã trạng thái tệp đối với toàn bộ site. Hãy test robots.txt thay vì đoán.
Nhập một tên miền để đọc tệp của nó, hoặc một URL đầy đủ như example.com/admin/ để test cả đường dẫn đó.
- TảiGET /robots.txt
- Đọcnhóm, quy tắc, sitemap
- Nhómtrình thu thập tuân theo quy tắc nào
- Kết luậnmỗi trình thu thập được thu thập gì
Cách test robots.txt khi công cụ kiểm tra robots.txt của Google đã bị gỡ bỏ
Hãy nhập một tên miền ở trên rồi chọn Kiểm tra robots.txt. Chúng tôi tải tệp một lần từ máy chủ của mình, rồi ngay trong trình duyệt của bạn test bất kỳ URL nào bạn gõ vào với tệp đó, cho bất kỳ trình thu thập nào bạn chọn — đúng những gì công cụ kiểm tra robots.txt của Google từng làm trước khi bị ngừng.
Google đã thông báo thay đổi này ngày 15 tháng 11 năm 2023: “Trong bản cập nhật này, chúng tôi sẽ ngừng cung cấp công cụ kiểm tra robots.txt.” Công cụ cũ biến mất vào tháng 12 năm 2023, và báo cáo robots.txt của Search Console thay thế nó là một thứ hoàn toàn khác.
Báo cáo đó liệt kê các tệp Google đã tải cho 20 host hàng đầu trên một tài sản mà bạn sở hữu và đã xác minh, kèm ngày kiểm tra, kích thước tính bằng byte và số vấn đề. Nó không thể test một URL với một quy tắc, test một trình thu thập không thuộc Google, hay xem một site bạn không sở hữu. Trang này làm được cả ba.
- Tệp mà Google tải gần đây nhất
- Kích thước và ngày kiểm tra
- Số vấn đề khi phân tích cú pháp
- URL này có được phép với trình thu thập này không?
- Quy tắc nào quyết định, và ở dòng nào
- Một trình thu thập không thuộc Google
- Một site bạn không sở hữu
Google thông báo thay đổi ngày 15 tháng 11 năm 2023 và gỡ bỏ công cụ kiểm tra vào tháng 12 năm 2023.
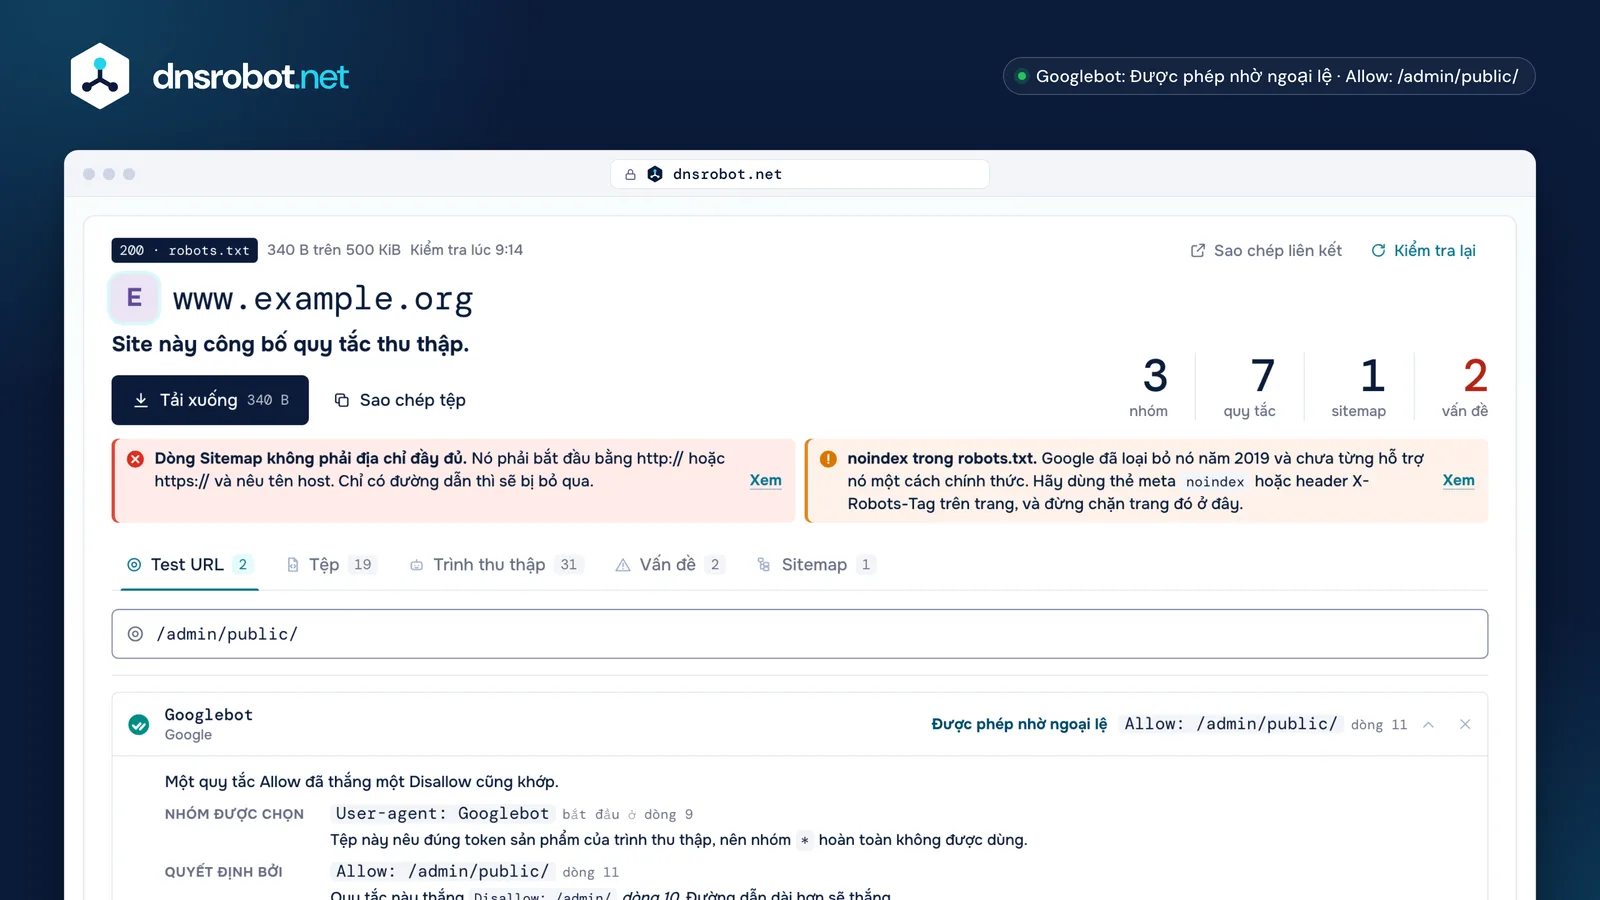
 Hệ quảKhông chỉ mã trạng thái, mà ý nghĩa của nó với toàn bộ site. Ở đây, một 404 cho phép mọi trình thu thập lấy mọi thứ; một 503 nghĩa là trình thu thập tuân theo chuẩn sẽ không lấy gì.Quy tắc quyết địnhQuy tắc đã quyết định URL này với trình thu thập này, kèm số dòng và quy tắc mà nó thắng. Khớp dài nhất sẽ thắng, và Allow thắng khi hòa.Nhóm được chọnNhóm mà trình thu thập thật sự đọc, và vì sao các nhóm khác bị bỏ qua. Đây là bước mà các công cụ khác không hề cho thấy.Các phát hiệnMỗi vấn đề nằm trên đúng dòng của nó trong tệp, kèm việc cần làm.
Google chọn nhóm nào áp dụng cho một trình thu thập như thế nào?
Một trình thu thập tuân theo đúng một bộ quy tắc. Nó tìm nhóm có dòng User-agent nêu đúng token sản phẩm của nó; chỉ khi không có nhóm nào như vậy, nó mới lùi về nhóm mang tên *. Nhóm * là phương án dự phòng, không bao giờ là phần cộng thêm.
RFC 9309 nói rõ: “Trình thu thập PHẢI so khớp không phân biệt chữ hoa chữ thường để tìm nhóm khớp với token sản phẩm”, và “[nếu] không có nhóm nào khớp, trình thu thập PHẢI tuân theo nhóm có dòng user-agent mang giá trị *, nếu có.” Google cũng nói như vậy theo cách của mình: “Chỉ có một nhóm hợp lệ duy nhất đối với mỗi trình thu thập dữ liệu cụ thể.”
Từ đó suy ra hai điều, và chính hai điều này gây ra phần lớn nhầm lẫn. Nhiều nhóm nêu cùng một token được gộp làm một, nên hai khối User-agent: Googlebot đều được tính. Nhưng một nhóm có tên và nhóm * không bao giờ được gộp: một Allow: / dưới * chẳng có tác dụng gì với Googlebot khi đã có nhóm Googlebot. Googlebot-Image và các trình thu thập Googlebot-* khác lùi về nhóm googlebot, đây là hành vi mà trình thu thập thêm vào bên trên bộ so khớp — bộ so khớp mã nguồn mở của chính Google không làm điều này.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Có nhóm nêu token riêng của trình thu thập này?Đọc nhóm đó. Nhóm
*không được dùng. - 2Có nhiều nhóm nêu nó?Đọc chúng như một nhóm.
- 3Có nhóm
*?Đọc nhóm*. - —Không có quy tắc nào áp dụng. Mọi thứ đều được thu thập.
Allow: / dưới * không bao giờ được đọc.
*.Allow hay Disallow: khớp dài nhất sẽ thắng
Khi có nhiều quy tắc cùng khớp một URL, quy tắc có đường dẫn dài nhất sẽ thắng, bất kể nó thuộc loại nào. Nếu một Allow và một Disallow dài bằng nhau, Allow thắng.
RFC 9309: “Kết quả khớp cụ thể nhất PHẢI được sử dụng. Kết quả khớp cụ thể nhất là kết quả có nhiều octet nhất”, và “nếu một quy tắc allow và một quy tắc disallow tương đương nhau, thì NÊN dùng quy tắc allow.” Google mô tả cùng hành vi đó: khi các quy tắc mâu thuẫn, Google dùng “quy tắc có mức hạn chế thấp nhất”.
Octet, không phải ký tự: một đường dẫn có chữ có dấu hay có %2F được so sánh sau khi mã hóa phần trăm, và đó chính là chỗ các công cụ sơ sài hay sai. Chỉ đường dẫn và chuỗi truy vấn được so sánh, tính từ ký tự đầu tiên, và chúng phân biệt chữ hoa chữ thường dù tên lệnh thì không — Disallow: /File.pdf không có tác dụng gì với /file.pdf.
/admin/report.pdfAllow thắng: nó khớp được phần dài hơn của đường dẫn.
Disallow: /files/7 ký tựAllow: /files/7 ký tựDài bằng nhau, nên Allow thắng. “Quy tắc có mức hạn chế thấp nhất”, như cách Google nói.
Chỉ có hai ký tự đại diện: `*` và `$`
* thay cho một chuỗi ký tự bất kỳ, và $ đánh dấu điểm kết thúc của URL. Ngoài ra không có gì khác: không có biểu thức chính quy, và ?, ., [ hay + không mang ý nghĩa đặc biệt nào, tất cả đều là ký tự thường.
Một quy tắc không có $ là một tiền tố, nên Disallow: /admin cũng chặn /administrator và /admin-tools. Hãy thêm dấu gạch chéo ở cuối (/admin/) khi bạn muốn nói tới thư mục, và thêm $ khi bạn muốn nói đúng URL đó. Disallow: /*.pdf$ chặn mọi tệp PDF; Disallow: /*? chặn mọi URL có chuỗi truy vấn.
Khung Test URL ở trên hiển thị những đường dẫn mà một quy tắc cũng bắt được, từ chính bộ so khớp đã đưa ra kết luận, nên một quy tắc vươn xa hơn ý bạn sẽ lộ ra trước khi bạn công bố nó.
* và $, và mỗi mẫu thật sự bắt được gì/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ và + là ký tự thường. robots.txt không có biểu thức chính quy.
Mã trạng thái robots.txt của bạn có nghĩa là gì?
Một 4xx và một 5xx trên cùng một tệp hỏng cho ra hai kết quả trái ngược. 4xx được hiểu như thể không có tệp, nên trình thu thập được lấy mọi thứ. 5xx nghĩa là tệp không xác định, nên một trình thu thập tuân thủ chuẩn không được lấy gì.
RFC 9309 §2.3.1.3: nếu mã trạng thái cho thấy tệp “không khả dụng với trình thu thập, thì trình thu thập CÓ THỂ truy cập mọi tài nguyên trên máy chủ”. §2.3.1.4: nếu tệp “không truy cập được do lỗi máy chủ hoặc lỗi mạng… trình thu thập PHẢI mặc định là bị cấm hoàn toàn.” Google xử lý “tất cả lỗi 4xx, ngoại trừ 429, như thể không có tệp robots.txt hợp lệ”, và điều đó đặt 429 về phía 5xx.
Sau đó Google làm dịu trường hợp 5xx bằng một thang bậc của riêng mình: ngừng thu thập trong 12 giờ đầu, dùng bản tốt gần nhất mà nó có trong 30 ngày tiếp theo, và sau đó, nếu phần còn lại của site vẫn hoạt động, thì xử lý như thể không có robots.txt nào cả. Google đi theo ít nhất năm bước chuyển hướng, rồi dừng lại và “xem đó là một lỗi 404 đối với tệp robots.txt”, nghĩa là được thu thập tự do. Còn một tên không phân giải được thì không phải là một site đang chặn ai cả — không có tệp, và không có kết luận.
200Tuân theo các quy tắc trong tệp.301, 302Đi theo ít nhất năm bước chuyển hướng rồi dừng lại. Khi đó Google coi tệp là 404.403, 404Thu thập mọi thứ, như thể không có tệp.429Không thu thập gì. Google xếp mã này cùng các câu trả lời 5xx, không phải 4xx.500, 503Không thu thập gì cả, theo chuẩn.Không có tên nàyKhông có site nào để đọc, nên không có kết luận.- 112 giờ đầuNgừng thu thập site và tiếp tục thử tải lại tệp
- 2Tối đa 30 ngàyDùng bản robots.txt tốt gần nhất
- 3Sau 30 ngàyNếu site vẫn truy cập được, xử lý như thể không có robots.txt
robots.txt có giữ một trang ở ngoài Google không?
Không. Nó yêu cầu trình thu thập không tải trang; nó không yêu cầu công cụ tìm kiếm không liệt kê trang. Google không đọc được một trang bị chặn thu thập, nhưng Google “vẫn có thể lập chỉ mục URL và hiển thị URL đó trong các kết quả tìm kiếm (không có đoạn trích)” khi các trang khác liên kết tới nó.
Đó là trạng thái “Đã lập chỉ mục, mặc dù bị robots.txt chặn” trong Search Console: “Google sẽ không yêu cầu và thu thập dữ liệu trên trang, nhưng chúng tôi vẫn có thể lập chỉ mục trang đó dựa trên thông tin trên trang liên kết đến trang bị chặn của bạn.” Cách khắc phục của chính Google, theo lời của họ, là “xoá lệnh chặn trong tệp robots.txt và dùng thẻ noindex”.
Vì thế lỗi phổ biến nhất trong robots.txt là một cặp, không phải một dòng: một URL vừa bị chặn ở đây vừa mang noindex. Google nói rõ rằng “nếu bị chặn bởi một tệp robots.txt… thì trình thu thập dữ liệu sẽ không bao giờ thấy quy tắc noindex và trang đó vẫn có thể xuất hiện trong kết quả tìm kiếm”. Hãy chọn một: chặn việc thu thập, hoặc cho trình thu thập vào và bảo nó đừng lập chỉ mục.
- Trình thu thập
- Đọc robots.txt
- URL bị chặn
- Không tải trang
<meta name="robots" content="noindex">Không bao giờ được đọcĐể giữ một trang ở ngoài: cho trình thu thập vào và dùng noindex, hoặc yêu cầu đăng nhập.
Làm sao để chặn ChatGPT, Claude và các trình thu thập AI khác?
Bằng một nhóm thông thường cho mỗi trình thu thập. Các công ty AI công bố token sản phẩm giống hệt như công cụ tìm kiếm, và phần lớn vận hành nhiều trình thu thập: một cái để huấn luyện, một cái để trả lời câu hỏi kèm liên kết dẫn về, và một cái tải trang vì có người yêu cầu.
Ba loại này nên được tách bạch. Chặn trình thu thập huấn luyện giữ các trang của bạn ở ngoài mô hình; chặn trình thu thập trả lời còn đưa bạn ra khỏi phần trích dẫn nguồn mà các sản phẩm đó hiển thị. Khung Trình thu thập ở trên nêu mục đích, token của từng trình thu thập và điều mà tài liệu của chính nhà vận hành nói nó tuân theo, để bạn có thể từ chối việc huấn luyện mà không biến mất khỏi câu trả lời của AI.
Một số nhà vận hành nói thẳng rằng trình thu thập tải trang thay mặt một người có thể bỏ qua robots.txt, vì nó hành động cho một người dùng chứ không phải đang thu thập. Bảng có đánh dấu những trình thu thập đó. Còn các dòng Content-Signal của Cloudflare, ngày càng nhiều site công bố, là một tuyên bố về việc nội dung của bạn được dùng vào mục đích gì chứ không phải quy tắc thu thập: trang này giữ chúng lại và giải thích, thay vì gọi chúng là lỗi.
GPTBotTuân theoOAI-SearchBotTuân theoChatGPT-UserCó thể bỏ qua
ClaudeBotTuân theoClaude-SearchBotTuân theoClaude-UserTuân theo
PerplexityBotTuân theoPerplexity-UserCó thể bỏ quaGoogle-ExtendedChỉ là tokenKhông có trình thu thập nàyKhông có trình thu thập này
Applebot-ExtendedChỉ là tokenKhông có trình thu thập nàyKhông có trình thu thập này
meta-externalagentTuân theometa-webindexerTuân theometa-externalfetcherCó thể bỏ qua
AmazonbotTuân theoKhông có trình thu thập nàyAmzn-UserCó thể bỏ qua- Huấn luyệnThu thập trang để huấn luyện mô hình.
- Câu trả lời AITải trang để trả lời một câu hỏi, thường kèm liên kết dẫn về bạn.
- Yêu cầu của một ngườiTải một trang vì có người yêu cầu. Một số nhà vận hành nói trình thu thập này có thể bỏ qua robots.txt.
Crawl-delay, Clean-param, Host và Content-Signal: ai đọc lệnh nào?
Google đọc bốn trường và không trường nào khác: user-agent, allow, disallow và sitemap. Mọi thứ khác trong robots.txt là do bên khác đọc, hoặc không ai đọc — và một dòng lạ không bao giờ là lỗi.
Google liệt kê bốn trường của mình và nói thêm rằng “các trường khác như crawl-delay không được hỗ trợ”. Bing thì có hỗ trợ Crawl-delay, theo blog của chính Bing: “lệnh crawl-delay chỉ chấp nhận giá trị là số nguyên dương”. Clean-param là của Yandex và không của ai khác. Host không nằm trong chuẩn, cũng không có trong danh sách của Google.
Không lệnh nào trong số đó làm hỏng tệp. RFC 9309 yêu cầu việc phân tích các bản ghi khác “KHÔNG ĐƯỢC ảnh hưởng tới việc phân tích các bản ghi được định nghĩa rõ ràng”, nên trình thu thập không biết một dòng sẽ bỏ qua dòng đó. Hai lệnh thật sự đã chết là noindex và nofollow bên trong robots.txt: Google đã gỡ bỏ phần mã xử lý chúng vào năm 2019, và ngày nay chúng không có tác dụng gì với Google.

User-agentCó đọcCó đọcCó đọcAllowCó đọcCó đọcCó đọcDisallowCó đọcCó đọcCó đọcSitemapCó đọcCó đọcCó đọcCrawl-delayBỏ quaCó đọcChưa xác nhậnClean-paramBỏ quaBỏ quaCó đọcHostBỏ quaBỏ quaChưa xác nhậnnoindexBỏ quaChưa xác nhậnChưa xác nhậnContent-SignalBỏ quaChưa xác nhậnChưa xác nhận- Google hỗ trợ bốn trường và nói rõ điều đó: user-agent, allow, disallow và sitemap.
- Blog của chính Bing xác nhận Crawl-delay. Chúng tôi không nêu phạm vi giá trị hay đơn vị: không đọc được trang trợ giúp hiện tại của Bing để kiểm chứng hai điều đó.
- Bị Google loại bỏ năm 2019, và chưa bao giờ là một phần của chuẩn.
- Content Signals Policy của Cloudflare: một tuyên bố về cách nội dung được phép sử dụng, không phải quy tắc thu thập.
Giới hạn 500 KiB, và phần nằm ngoài giới hạn
Google đọc 500 kibibyte đầu tiên của tệp robots.txt và bỏ qua mọi thứ sau đó, không báo lỗi ở bất cứ đâu. RFC 9309 đặt 500 KiB làm mức sàn cho giới hạn phân tích của trình thu thập; Google nêu nó như mức trần.
Google: “Google áp dụng giới hạn kích thước tệp robots.txt là 500 kibibyte (KiB). Phần nội dung nằm ngoài kích thước tệp tối đa sẽ bị bỏ qua.” Không có gì cảnh báo bạn. Một tệp 600 KiB không hề không hợp lệ — chỉ là 100 KiB cuối của nó không tồn tại với Googlebot, và một Disallow nằm ở dưới đó chẳng bảo vệ được gì.
Các site chạm tới giới hạn này thường xuyên hơn bạn nghĩ: mỗi tham số chiến dịch một quy tắc, mỗi bộ lọc sản phẩm một quy tắc, mỗi thư mục staging cũ một quy tắc. Lượt kiểm tra ở trên đo tệp so với mốc đó và cho bạn biết bao nhiêu nằm ngoài. Hãy thay các danh sách dài bằng mẫu (Disallow: /*?filter=), và đặt những quy tắc quan trọng lên đầu.
Disallow: /cart/ · Dòng 12Được tuân theoDisallow: /private/ · Dòng 9.412Không bao giờ được đọcTệp vẫn trả về 200 và vẫn phân tích được. Không ở đâu báo cho bạn biết phần còn lại đã bị bỏ đi.
Những lỗi robots.txt thường gặp, và cách tìm ra chúng
Phần lớn tệp robots.txt bị hỏng đều hỏng theo một trong sáu cách, và không cách nào lộ ra cho tới khi có thứ gì đó test nó: tệp vẫn trả về 200, vẫn phân tích được, và trông vẫn đúng.
Lỗi ai cũng biết là Disallow: / bị bỏ quên khi một site từ staging lên chạy thật. Năm lỗi còn lại: một quy tắc vươn xa hơn ý bạn, như Disallow: /admin, vốn cũng bắt cả /administrator; một Allow: / dưới * mà một nhóm có tên lặng lẽ bỏ qua; một dòng Sitemap: viết thành đường dẫn thay vì địa chỉ đầy đủ; một đường dẫn không có dấu gạch chéo đầu, nên không khớp gì cả; và một dòng noindex, thứ Google đã thôi đọc từ năm 2019.
Hãy chạy lượt kiểm tra ở trên, rồi đọc khung Vấn đề: mỗi phát hiện nằm trên đúng dòng của nó trong tệp, kèm việc cần làm. Nếu bạn đang sửa tệp thay vì rà soát nó, trình tạo robots.txt sẽ viết ra một tệp mà chính công cụ kiểm tra này đã đọc qua.
Nguồn
- RFC 9309, Robots Exclusion Protocol: nhóm, thứ tự ưu tiên, so khớp sau mã hóa phần trăm, mã trạng thái và mức sàn 500 KiB
- Google Search Central: cách Google diễn giải robots.txt, tạo và gửi tệp robots.txt và dùng noindex để chặn lập chỉ mục
- Trợ giúp Google Search Console: báo cáo robots.txt và báo cáo Lập chỉ mục trang
- Bing: Crawl-delay và trình thu thập của Bing và Yandex: Clean-param
- Trình phân tích robots.txt mã nguồn mở của Google, bộ so khớp mà chính Googlebot sử dụng
- Token, mục đích và cách xử lý robots.txt của từng trình thu thập lấy từ tài liệu của chính nhà vận hành, có liên kết ngay bên cạnh trong khung Trình thu thập
Disallow: /Sót lại từ staging: toàn bộ site đang chạy thật bị đóng với mọi trình thu thập.Disallow: /adminCũng chặn /administrator và /admin-tools. Hãy thêm dấu gạch chéo ở cuối.Allow: / dưới User-agent: *Không bao giờ được đọc bởi trình thu thập có nhóm riêng ở bất kỳ đâu trong tệp.Sitemap: /sitemap.xmlDòng Sitemap phải là địa chỉ đầy đủ kèm host.Disallow: adminĐường dẫn bắt đầu từ /. Quy tắc này không khớp gì cả.noindex: /private/Đã chết từ năm 2019. Trang vẫn có thể được thu thập và lập chỉ mục.Kiểm tra robots.txt: câu hỏi thường gặp
Công cụ kiểm tra robots.txt của Google đã ra sao?
Vì sao Allow: / dưới User-agent: * của tôi bị bỏ qua?
* bị bỏ qua hoàn toàn — đó là phương án dự phòng, không phải phần cộng thêm. Các nhóm chỉ được gộp lại khi nhiều nhóm nêu cùng một token. Khung Test URL ở trên cho thấy nhóm nào được chọn cho từng trình thu thập và vì sao các nhóm khác thì không.robots.txt có ngăn một trang được lập chỉ mục không?
noindex hoặc header X-Robots-Tag, hoặc đặt trang sau lớp đăng nhập.Vì sao noindex của tôi không có tác dụng?
noindex, nên trang vẫn có thể tiếp tục xuất hiện trong kết quả tìm kiếm nhờ liên kết từ nơi khác. Google nói thẳng điều này: “Để quy tắc noindex có hiệu lực, không được dùng tệp robots.txt để chặn trang hay tài nguyên”. Hãy xóa dòng Disallow và giữ lại noindex.404 trên robots.txt nghĩa là gì? Còn 500 thì sao?
Nếu cả Allow và Disallow cùng khớp, quy tắc nào thắng?
Những ký tự đại diện nào dùng được trong robots.txt?
* thay cho một chuỗi ký tự bất kỳ và $ đánh dấu điểm kết thúc của URL. Mọi thứ khác đều mang nghĩa đen: ?, ., [, ] và + chỉ khớp với chính chúng, và không có biểu thức chính quy. Một quy tắc không có $ là một tiền tố, nên Disallow: /admin cũng bắt cả /administrator. Đường dẫn phân biệt chữ hoa chữ thường, còn tên lệnh như Disallow thì không.Google có hỗ trợ Crawl-delay không?
Tệp robots.txt được phép lớn tới mức nào?
Làm sao để chặn các trình thu thập AI như GPTBot và ClaudeBot?
Disallow: /, đúng như với một công cụ tìm kiếm. Phần lớn công ty AI chạy nhiều trình thu thập cho các việc khác nhau: một cái để huấn luyện, một cái trả lời câu hỏi kèm liên kết dẫn về bạn, và một cái tải một trang thay mặt một người. Khung Trình thu thập ở trên nêu từng token, mục đích và điều nhà vận hành nói nó tuân theo, để bạn từ chối việc huấn luyện mà không mất trích dẫn trong AI.Công cụ test robots.txt có giống trình xác thực (validator) không?
robots.txt có phải là một rủi ro bảo mật không?
Disallow: /admin-backup/ chính là tấm biển chỉ thẳng tới thứ bạn muốn giấu. Không gì trong tệp ngăn được việc truy cập; trình thu thập tuân theo nó chỉ vì nhà vận hành chọn vậy. Hãy bảo vệ đường dẫn riêng tư bằng xác thực hoặc quy tắc tường lửa; công cụ kiểm tra này sẽ chỉ ra những đường dẫn trong tệp của bạn trông như một lời mời.Còn thiếu điều gì?Đề xuất tính năng hoặc công cụ mới
Thêm công cụ thu thập dữ liệu và lập chỉ mục
Kiểm Tra Sitemap
Tìm và xác thực XML sitemap của website: cú pháp, giới hạn URL, ngày lastmod, xung đột với robots.txt và URL lỗi hoặc chuyển hướng
Tạo Sitemap
Thu thập dữ liệu website và nhận sitemap XML, sitemap HTML và cây cấu trúc site
Kiểm tra HTTP Header
Phân tích header phản hồi HTTP và chấm điểm header bảo mật
Kiểm tra Redirect
Kiểm tra chuyển hướng URL, chuỗi chuyển hướng và mã trạng thái HTTP cho SEO
User Agent Của Tôi Là Gì
Phát hiện trình duyệt, hệ điều hành, loại thiết bị, engine dựng hình và kiến trúc CPU từ chuỗi User Agent
Phân Tích Liên Kết
Phân tích tất cả liên kết trên trang web với phát hiện dofollow/nofollow và kiểm tra trạng thái HTTP