











Trình tạo Sitemap XML
Trình tạo sitemap miễn phí giúp bạn tạo sitemap XML: nó thu thập dữ liệu website của bạn đúng như cách một công cụ tìm kiếm làm, chỉ giữ lại những trang xứng đáng có mặt trong kết quả tìm kiếm, và cho bạn biết vì sao mọi URL còn lại bị để ngoài.
Một tên miền cũng được: example.org sẽ bắt đầu từ trang chủ.
- robots.txtĐọc trước, tuân thủ
- Sitemap của bạnTìm ra và so sánh
- Đã thu thậpTối đa 500 trang, 3 trang một lúc
- Đã quyết địnhnoindex, canonical, chuyển hướng
Cách tạo sitemap XML, từng bước một
Hãy nhập trang chủ của bạn ở trên rồi chọn Tạo sitemap. Trình thu thập sitemap sẽ đọc robots.txt, đi theo các link của bạn đúng như một công cụ tìm kiếm, chỉ giữ lại những trang xứng đáng, và đưa cho bạn một sitemap.xml để tải lên thư mục gốc của site.
Một trang xứng đáng khi nó trả về 200, là HTML, không có noindex, tự khai mình là canonical và không bị robots.txt chặn. Mọi URL khác rơi vào Không đưa vào kèm lý do, để bạn phân biệt được đâu là lỗi và đâu là chủ ý.
Hãy tải tệp lên thư mục gốc, https://www.example.org/sitemap.xml: một sitemap chỉ được liệt kê các URL trong chính thư mục của nó và các thư mục con, nên đặt ở gốc là bao phủ cả site (Google). Rồi thêm một dòng Sitemap: vào robots.txt và khai báo nó trong Google Search Console cùng Bing Webmaster Tools.
1Nhập trang chủ của bạn
example.orghoặc dán một danh sách URL2Chúng tôi thu thập và quyết định
robots.txt 200499/500412 trong sitemap · 87 để ngoài3Tải tệp xuống
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML hay CSV4Tải lên và khai báo
/sitemap.xmlSitemap: https://www.example.org/…thư mục gốc · robots.txt · Search Console



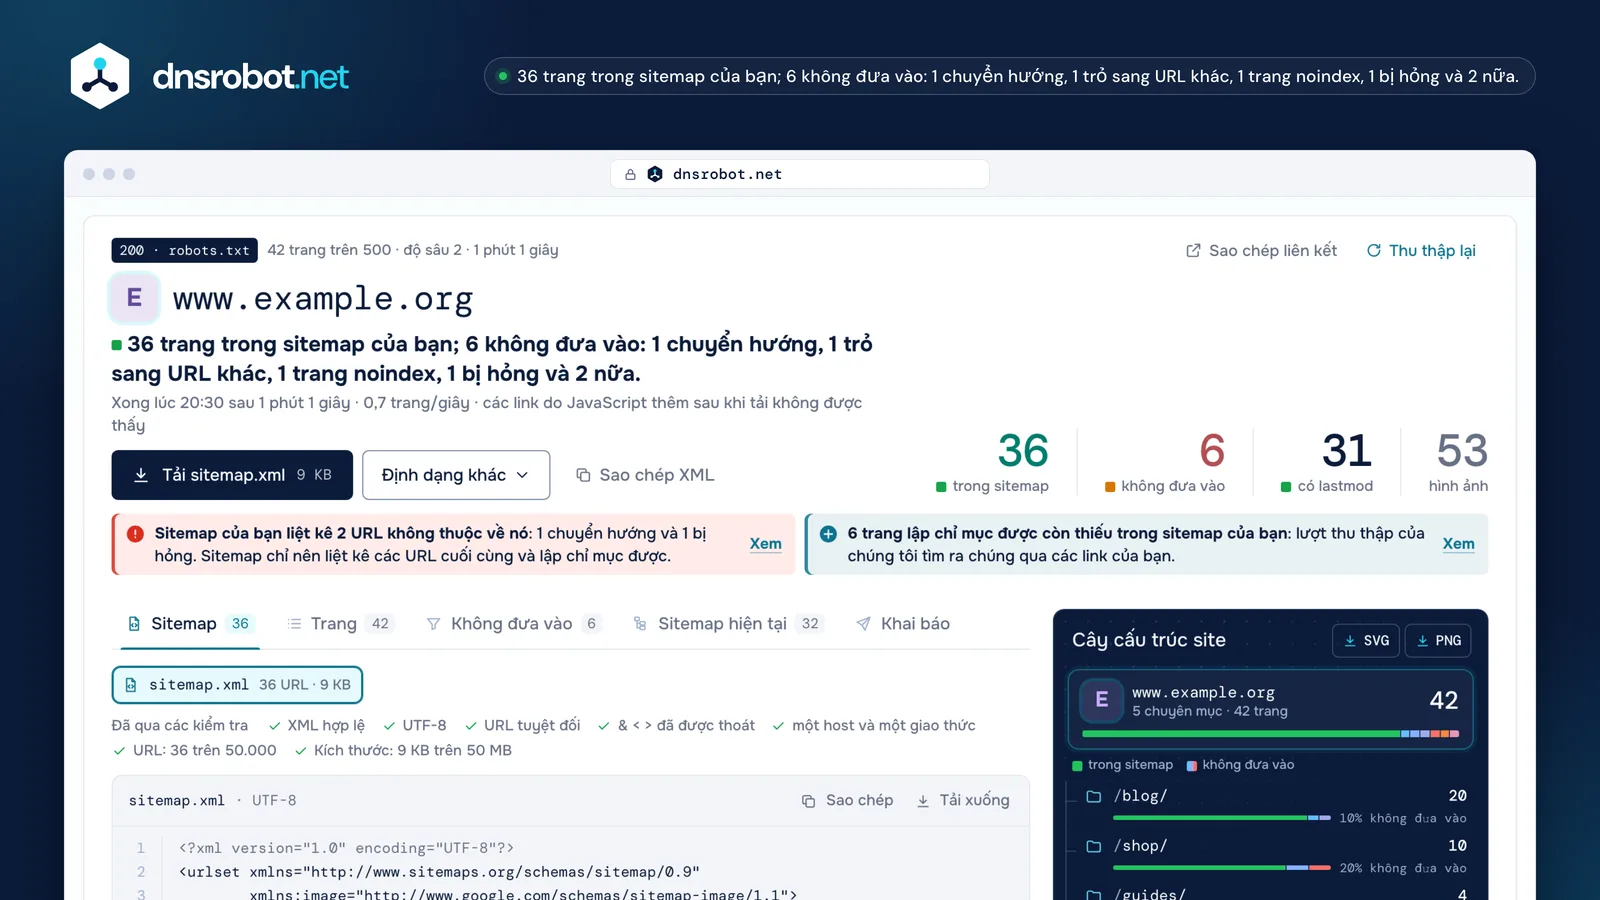
 Kết luậnBao nhiêu trang được vào, bao nhiêu bị để ngoài và vì sao, gói trong một câu. Các con số lớn nhắc lại điều đó.Tải xuốngsitemap.xml, hoặc một ZIP gồm mọi tệp và cả chỉ mục khi tệp bị chia; ngoài ra còn .xml.gz, TXT, một sơ đồ trang HTML và một CSV liệt kê mọi trang đã thu thập.Ghi chúNhững mục đã cũ trong sitemap hiện tại của bạn, những trang nó bỏ sót, và từng ngày lastmod đến từ đâu.Cây cấu trúc siteMỗi chuyên mục kèm số trang của nó và tỷ lệ bị để ngoài. Chọn một nhánh để lọc các trang; tải về dưới dạng SVG hoặc PNG.
Sitemap XML trông như thế nào? Một ví dụ sitemap
Một sitemap XML là tệp UTF-8 với mỗi trang một mục <url>. Chỉ <urlset>, <url> và <loc> là bắt buộc; mọi thứ khác đều tùy chọn. Dưới đây là một ví dụ sitemap, chú thích từng dòng.
Mỗi <loc> là một URL tuyệt đối đầy đủ, bắt đầu bằng giao thức và ngắn hơn 2.048 ký tự, trong đó & được viết thành & (sitemaps.org). <lastmod> là ngày trang thay đổi lần cuối, theo định dạng W3C như 2026-09-14; phần giờ là tùy chọn nhưng cần có múi giờ.
Namespace vẫn giữ http://, kể cả trên một site https: đó là một cái tên dành cho trình phân tích, không phải địa chỉ để ai đó tải về. <changefreq> và <priority> được phép dùng, nhưng Google và Bing đều bỏ qua chúng.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1UTF-8, khai ngay ở dòng đầu
- 2Namespace: http://, không phải https://
- 3URL tuyệt đối, với & được thoát thành &
- 4Ngày thay đổi thật, hoặc không có lastmod
- 5Google và Bing bỏ qua
- 6Không có lastmod: trang chủ chỉ tập hợp các trang khác
Những trang nào thuộc về sitemap, và vì sao một số bị để ngoài?
Những URL canonical bạn muốn thấy trong kết quả tìm kiếm, mỗi trang một URL: các URL cuối cùng trả về 200, lập chỉ mục được và không bị robots.txt chặn. Mọi thứ khác đều bị để ngoài, kèm lý do ghi ngay bên cạnh.
Một chuyển hướng, một trang noindex hay một URL có canonical trỏ nơi khác đều gửi cho công cụ tìm kiếm một thông điệp mâu thuẫn: sitemap nói “hãy lập chỉ mục trang này”, còn bản thân trang lại nói ngược lại. Đừng nêu URL này trong sitemap rồi nêu URL khác trong rel=canonical (Google), và Search Console có báo cáo những sitemap liệt kê URL bị robots.txt chặn.
Mọi URL trong sitemap chỉ là một đề xuất; Google vẫn tự quyết định trang nào là bản trùng lặp. Vì thế công cụ này cho bạn thấy lý do của từng trang bị để ngoài: một noindex bạn cố ý đặt thì không sao, còn một noindex trên trang sản phẩm tốt nhất của bạn thì có.
lastmod, changefreq và priority: công cụ tìm kiếm đọc những gì?
Google và Bing bỏ qua changefreq và priority. Cả hai đều dùng lastmod, nhưng chỉ khi nó chính xác: một ngày tháng cứ mỗi lượt thu thập lại đổi sẽ dạy chúng thôi tin vào nó.
Google dùng lastmod “nếu nó luôn chính xác và có thể kiểm chứng”, và nó phải đánh dấu lần thay đổi đáng kể gần nhất — nội dung chính, dữ liệu có cấu trúc hay các link — chứ không phải một năm bản quyền mới (Google). Một lastmod cứ khăng khăng rằng các trang cũ vừa thay đổi sẽ không còn được tin nữa. Bing lên lịch thu thập theo lastmod và có thể bỏ qua những ngày lúc nào cũng là hôm nay. Yandex thì vẫn đọc cả ba thẻ.
Vì vậy công cụ này không bao giờ ghi ngày hôm nay. Nó lấy lastmod từ chính dữ liệu của trang, theo thứ tự dưới đây, và bỏ trống khi không có: bỏ trống là chuyện bình thường với một trang chủ hay một trang chuyên mục chỉ tập hợp các trang khác.
| Thẻ | Bing | Yandex | |
|---|---|---|---|
| lastmod | dùng khi nó chính xác | dùng khi nó chính xác | có đọc |
| changefreq | bỏ qua | bỏ qua | có đọc |
| priority | bỏ qua | bỏ qua | có đọc |
“Hôm nay” cho mọi trang trông như thế nào
412 mục, một ngày duy nhất: ngày tạo tệp, không phải ngày thay đổi.
50.000 URL, 50 MB và chỉ mục sitemap
Một sitemap chứa tối đa 50.000 URL và 50 MB khi chưa nén. Khi vượt quá giới hạn nào đến trước, hãy chia các URL thành nhiều tệp và liệt kê chúng trong một chỉ mục sitemap; rồi khai báo chỉ mục đó.
Giới hạn tính trên tệp chưa nén, kể cả khi bạn phục vụ nó dưới dạng .xml.gz — gzip, không phải ZIP (sitemaps.org). Một chỉ mục có thể liệt kê tối đa 50.000 sitemap, chỉ gồm các tệp trên chính site của nó, trong chính thư mục của nó hoặc sâu hơn, và không bao giờ là một chỉ mục khác. Naver Search Advisor từ chối tệp lớn hơn 10 MB, nên với một site tiếng Hàn hãy chọn giới hạn 10 MB ở Thêm tùy chọn.
Các bản thay thế ngôn ngữ (xhtml:link) không tính vào 50.000. Công cụ này tự chia tệp và, nếu bạn muốn, chia theo chuyên mục: một tệp cho blog, một tệp cho sản phẩm.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
Mục hình ảnh và mục hreflang
Sitemap cũng có thể liệt kê hình ảnh của từng trang và các phiên bản ngôn ngữ khác của nó, ngay bên trong mục <url> của chính trang đó.
Hình ảnh dùng namespace hình ảnh của Google, tối đa 1.000 ảnh mỗi trang; chỉ còn <image:image> và <image:loc> là có giá trị, còn caption, title, license và geo_location đã bị loại bỏ năm 2022.
Với ngôn ngữ, mỗi mục liệt kê mọi phiên bản của trang, kể cả chính nó, bằng xhtml:link kèm một mã hreflang: một ngôn ngữ ISO 639-1 với vùng ISO 3166-1 tùy chọn, không bao giờ chỉ có vùng. Các link phải đi theo cả hai chiều, nếu không Google sẽ bỏ qua chúng, nên công cụ này chỉ ghi một cụm khi mọi phiên bản đều liên kết ngược lại, và hiển thị phần còn lại kèm lỗi. x-default là tùy chọn, dành cho khách truy cập dùng ngôn ngữ bạn không có.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja liên kết tới de, de không liên kết ngược: cụm này không được ghimục hình ảnh tối đa 1.000 mỗi trang
Khai báo sitemap với Google và Bing như thế nào?
Hãy thêm một dòng Sitemap: vào robots.txt, thứ mà mọi trình thu thập đều đọc, rồi khai báo tệp trong Google Search Console và Bing Webmaster Tools. Với trang mới và trang vừa thay đổi, IndexNow báo cho Bing, Yandex, Naver và những bên khác cùng một lúc.
Chỉ chủ sở hữu đã xác minh của một site mới khai báo được trong Search Console; còn dòng trong robots.txt thì của ai cũng dùng được. Với một sitemap đã gửi, Search Console không đi theo chuyển hướng, nên hãy khai báo địa chỉ cuối cùng của nó. Bing đọc một sitemap ngay khi tìm thấy, rồi khoảng mỗi ngày một lần.
Các lượt ping ẩn danh ngày trước đã biến mất: Bing tắt bing.com/ping ngày 13 tháng 5 năm 2022, còn Google thông báo ngày 26 tháng 6 năm 2023 rằng lượt ping của họ sẽ ngừng hoạt động; giờ nó trả về 404. Công cụ nào vẫn hứa “ping Google” thì thực ra chẳng làm gì cả.


Sitemap XML và sơ đồ trang HTML (cùng sơ đồ trực quan)
Sitemap XML dành cho trình thu thập, sơ đồ trang HTML là một trang liên kết dành cho khách truy cập, còn sơ đồ trực quan là bức tranh cấu trúc site để lên kế hoạch. Chỉ sitemap XML, hoặc một danh sách TXT, mới khai báo được với công cụ tìm kiếm.
Sơ đồ trang HTML vẫn giúp khách truy cập và truyền link tới những trang nằm sâu, nhưng nó không thể thay thế tệp XML. Một sitemap văn bản thuần chỉ gồm các URL, mỗi dòng một URL, trong một tệp đuôi .txt.
Công cụ này tạo cả ba thứ từ một lượt thu thập: sitemap.xml, một sơ đồ trang HTML để dán vào một trang, và cây cấu trúc site. Là một công cụ tạo sitemap trực quan, nó không tốn gì cả: cây tải về được dưới dạng SVG hoặc PNG, thứ mà các dịch vụ sitemap trực quan thường thu phí.
Sitemap XMLcho công cụ tìm kiếm
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
Sơ đồ trang HTMLcho khách truy cập
Example Garden Co.
Nhật ký làm vườnChăm sóc luống caoBố trí luống ớtGian hàngBộ tưới nhỏ giọt cơ bảnHướng dẫn trồng trọtSơ đồ trực quanđể lên kế hoạch
Bạn có thật sự cần một sitemap không?
Một site nhỏ mà các trang đều liên kết với nhau thì có thể không cần: Google đưa ra con số khoảng 500 trang trở xuống. Site lớn, site mới có ít link từ nơi khác, và site nhiều hình ảnh hay video là được lợi nhiều nhất.
Chính hướng dẫn khởi đầu của Google gọi sitemap là tùy chọn, và khai báo một sitemap là gợi ý chứ không phải mệnh lệnh. Dù vậy nó tốn rất ít công, và lượt thu thập để dựng nên nó cho thấy nhiều điều đáng biết: những trang không link nào dẫn tới, những chuyển hướng mà menu của bạn vẫn trỏ vào, và những chuyên mục gần như toàn noindex.
có thể không cần
khoảng 500 trang trở xuống, liên kết tốt
được lợi nhiều nhất
- site lớn
- site mới, ít link từ nơi khác
- nhiều hình ảnh hoặc video
- 5 trang chỉ sitemap mới dẫn tới
Lỗi sitemap trong Search Console, và cách khắc phục
Phần lớn lỗi sitemap trong Search Console quy về một URL mà sitemap không được phép liệt kê, một ký tự chưa được thoát, một ngày thiếu múi giờ, hoặc một tệp vượt giới hạn. Mỗi trường hợp dưới đây đều chỉ ra dòng gây ra nó.
URL không được phép
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
Lỗi phân tích cú pháp
<loc>https://www.example.org/search?q=soil&page=2</loc>
Ngày không hợp lệ
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
Định dạng không được hỗ trợ
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
Có quá nhiều URL
<url> × 50.001
Sơ đồ trang web chứa các URL bị tệp robots.txt chặn
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
Ngoài ra: Không thể tìm nạp (bị chặn, 404, một lỗi máy chủ, một hình phạt thủ công hay nhu cầu thu thập thấp), Lỗi nén (hãy gzip lại) và URL không đầy đủ (mỗi tệp trong một chỉ mục cần URL đầy đủ của nó).
AI có tạo được sitemap không?
AI có thể phác thảo cấu trúc một site để lên kế hoạch, nhưng sitemap là một danh sách sự thật về các URL đang sống: URL nào trả về 200, URL nào noindex, URL nào chuyển hướng. Chỉ việc tải từng URL về mới cho bạn biết điều đó.
Một mô hình khi được hỏi sitemap của một site có thật sẽ đoán URL theo khuôn mẫu. Nó không thấy được rằng một trang sản phẩm giờ trả về 404, rằng một trang lưu trữ thẻ là noindex hay rằng một bài cũ đã chuyển hướng, và mỗi URL như vậy trong tệp là một URL Search Console có thể báo lỗi. Hãy dùng AI cho kế hoạch, rồi thu thập dữ liệu để có tệp.
Nguồn
- Giao thức sitemaps.org và phần hỏi đáp của nó: định dạng, giới hạn 50.000 / 50 MB, chỉ mục, sitemap dạng văn bản
- Google Search Central: dựng một sitemap, sitemap lớn, phiên bản theo ngôn ngữ, sitemap hình ảnh, lastmod và lượt ping đã ngừng cùng các lỗi trong báo cáo Sitemaps
- Bing: sitemap trong tìm kiếm có AI (2025), thẻ lastmod (2023) và lượt ping đã gỡ bỏ (2022)
- Yandex: sitemap, Naver Search Advisor: feed và IndexNow
- RFC 9309, chuẩn robots.txt mà trình thu thập này tuân theo
| URL | Đoán | Thu thập |
|---|---|---|
| /blog/raised-care/ | đưa vào | Trong sitemap200 |
| /product/fern-varieties/ | đưa vào | 4xx404 |
| /tag/native-bed/ | đưa vào | noindexmeta |
| /2019/07/raised-care/ | đưa vào | Chuyển hướng301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | đưa vào | Canonical trỏ nơi khác→ /blog/pollinator-kit/ |
Câu hỏi thường gặp về trình tạo sitemap
Công cụ tạo sitemap online này có miễn phí không?
Vì sao một số trang của tôi bị thiếu trong sitemap?
Đặt tệp sitemap.xml ở đâu?
Một sitemap chứa được bao nhiêu URL?
Google có dùng priority và changefreq không?
Vì sao một số trang không có ngày lastmod?
Sitemap có nên chứa chuyển hướng hay trang noindex không?
Làm sao để khai báo sitemap với Google?
CMS của tôi đã tạo sitemap rồi. Tôi có cần cái này không?
Trình thu thập sitemap này có tuân thủ robots.txt không?
Công cụ này thu thập được site dựng bằng JavaScript không?
IndexNow là gì, và có nó rồi thì còn cần sitemap không?
Còn thiếu điều gì?Đề xuất tính năng hoặc công cụ mới
Thêm công cụ thu thập dữ liệu và SEO
Phân Tích Liên Kết
Phân tích tất cả liên kết trên trang web với phát hiện dofollow/nofollow và kiểm tra trạng thái HTTP
Kiểm tra Redirect
Kiểm tra chuyển hướng URL, chuỗi chuyển hướng và mã trạng thái HTTP cho SEO
Kiểm tra HTTP Header
Phân tích header phản hồi HTTP và chấm điểm header bảo mật
Kiểm Tra Website Sập
Web sập với mọi người hay chỉ mình bạn? Kiểm tra bất kỳ website nào từ 11 địa điểm và từ kết nối của bạn, kèm ảnh chụp màn hình trực tiếp
Tìm Tên Miền Phụ
Khám phá tất cả tên miền phụ của bất kỳ tên miền nào
Check CMS Website
Website dùng CMS, theme, plugin và công nghệ gì, kèm bằng chứng cho từng mục