Mọi trình thu thập khác
User-agent: *
Mọi trình thu thập không có nhóm riêng sẽ đọc nhóm này.
- Cho phép toàn bộ site.
Google bỏ qua nó; Bing thì đọc.
Tạo một robots.txt bạn tin được: mỗi quy tắc được giải thích ngay khi bạn gõ, tệp được công cụ kiểm tra robots.txt của chúng tôi đọc lại theo RFC 9309 và cách hiểu của chính Google, cùng kết luận tức thì cho bất kỳ trình thu thập và đường dẫn nào trước khi bạn công bố.
Mỗi host và mỗi giao thức cần một tệp riêng: www.example.com và example.com mỗi bên một tệp.
Nguồn: RFC 9309, đọc ngày 26 tháng 10, 2026.
Mọi trình thu thập không có nhóm riêng sẽ đọc nhóm này.
Chọn cách xử lý cho từng trình thu thập đã biết. Một trình thu thập có nhóm riêng chỉ đọc nhóm đó.
Chúng thu thập để xây dựng chỉ mục tìm kiếm. Trang bị chặn vẫn có thể được liệt kê nhờ liên kết từ nơi khác, nhưng không có gì trên trang được đọc.
Chúng thu thập trang để huấn luyện mô hình. Một token riêng cho phép bạn từ chối việc huấn luyện mà vẫn có mặt trong kết quả tìm kiếm.
Chúng tải trang để trả lời câu hỏi, kèm một liên kết dẫn về bạn.
Chúng tải một trang vì có người yêu cầu, nên một số nhà vận hành nói rằng chúng có thể bỏ qua robots.txt.
Chặn những trình thu thập này là từ chối một con người, không phải một lượt thu thập: khi ai đó nhờ trợ lý AI mở một trang của bạn, trợ lý nào tuân theo tệp sẽ không đọc trang đó giúp họ. Nếu điều bạn muốn từ chối là việc huấn luyện, hãy chặn các trình thu thập huấn luyện ở trên.
Xem trước liên kết, công cụ cho chủ site, kiểm tra quảng cáo, lưu trữ web, và những trình thu thập mà nhà vận hành nêu một việc khác hoặc không nêu gì.
robots.txt của bạn/robots.txt
User-agent: *Allow: /LỗiCảnh báoGhi chú23 B trên 500 KiB
1 cảnh báo
Cần làm gì Đây là dòng rẻ nhất trong tệp và mọi trình thu thập đều đọc nó. Hãy thêm Sitemap: với địa chỉ đầy đủ của sitemap.
Chọn một trình thu thập và một đường dẫn: kết luận, quy tắc quyết định và nhóm mà trình thu thập đọc đều đến từ chính bộ so khớp của công cụ kiểm tra robots.txt.
Trình thu thập này được phép yêu cầu URL.
User-agent: *bắt đầu ở dòng 1
Không nhóm nào nêu tên trình thu thập này, nên nhóm * được áp dụng.
Allow: /dòng 2
/any-page
/
Chỉ đường dẫn và chuỗi truy vấn được so sánh, từng byte một sau khi mã hóa phần trăm. Host, giao thức và fragment không bao giờ là một phần của quy tắc.
Viết các quy tắc, lưu chúng thành một tệp văn bản thuần tên robots.txt, mã hóa UTF-8, rồi tải lên cấp cao nhất của site để tệp có tại https://example.com/robots.txt. Không có gì cần gửi: trình thu thập tự tìm tới địa chỉ đó.
Google gói điều này trong ba câu: “Phải đặt tên tệp là robots.txt. Trang web của bạn chỉ có thể có một tệp robots.txt. Tệp robots.txt phải nằm tại thư mục gốc trên máy chủ của trang web, tương ứng với phạm vi áp dụng của tệp.” Tệp phải là “tệp văn bản được mã hoá UTF-8”, và “các trình thu thập thông tin của Google sẽ tự động tìm và bắt đầu sử dụng tệp robots.txt của bạn.”
Trình tạo ở trên bắt đầu từ một mẫu có sẵn, giải thích từng quy tắc khi bạn gõ, và đọc lại kết quả bằng trình phân tích và bộ so khớp của công cụ kiểm tra robots.txt trước khi bạn sao chép. Tệp tải về có tên robots.txt: UTF-8 không có dấu thứ tự byte, chỉ dùng ký tự xuống dòng LF, và không có ngày tháng hay chú thích nào bạn không yêu cầu.
https://example.com/robots.txtKhông có bước gửi: trình thu thập của Google tự tìm ra tệp.
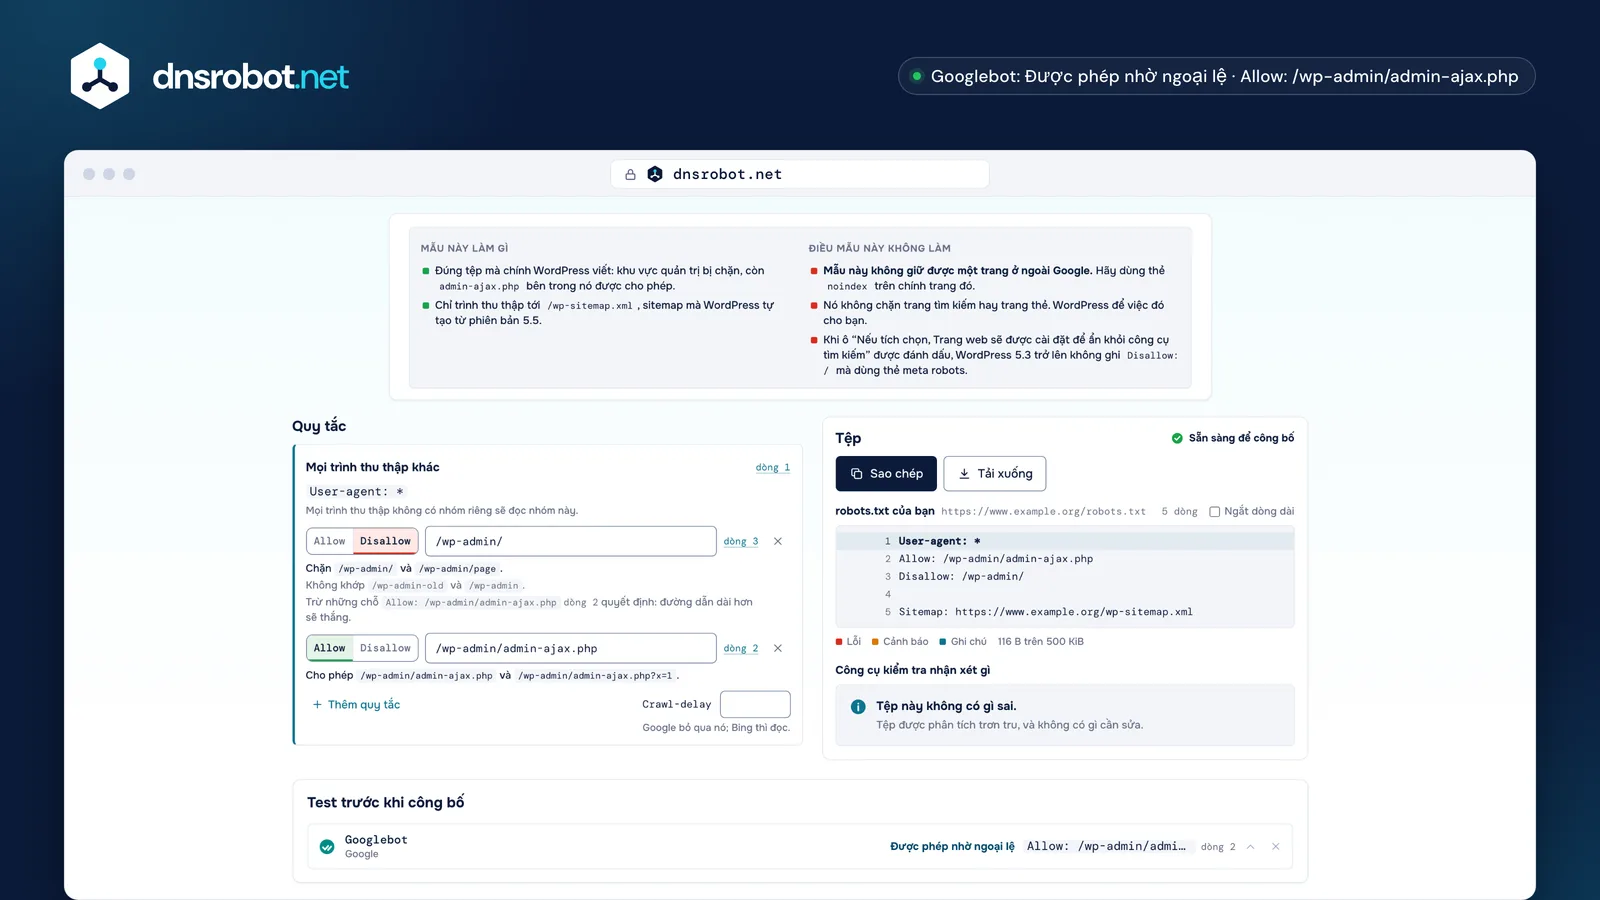
 Mẫu này làm gìVà điều nó không làm: không mẫu nào ở đây giữ được một trang ở ngoài Google, và mẫu nào cũng nói rõ điều đó.Giải thích từng quy tắcNhững đường dẫn một quy tắc chặn và những đường dẫn nó bỏ sót, từ chính bộ so khớp quyết định mọi kết luận, cùng quy tắc dài hơn tạo ra ngoại lệ.Tệp và các phát hiệnTệp kèm số dòng, được bước rà soát của chính công cụ kiểm tra robots.txt đọc lại trước khi bạn sao chép.Kết luậnChọn một trình thu thập và một đường dẫn: được phép hay bị chặn, quy tắc đã quyết định kèm số dòng, và nhóm mà trình thu thập đọc.
Các nhóm và các dòng Sitemap. Một nhóm bắt đầu bằng một hoặc nhiều dòng User-agent nêu tên trình thu thập, tiếp theo là các quy tắc Allow và Disallow mà những trình thu thập đó tuân theo; một dòng Sitemap đứng riêng, nằm ngoài mọi nhóm.
RFC 9309 định nghĩa nhóm là “một hoặc nhiều dòng user-agent theo sau là một hoặc nhiều quy tắc”, và một trình thu thập tuân theo đúng một nhóm: nhóm nêu token sản phẩm của chính nó, hoặc nhóm * khi không nhóm nào nêu. Google đọc bốn trường và không trường nào khác: user-agent, allow, disallow và sitemap.
Tên trường không phân biệt chữ hoa chữ thường, còn đường dẫn thì có: trong ví dụ của chính Google, disallow: /file.asp áp dụng cho /file.asp “nhưng không áp dụng cho” /FILE.asp. Dòng Sitemap: phải là một địa chỉ đầy đủ có giao thức và host; trình tạo này từ chối mọi dạng khác và nói rõ lý do.
User-agent: *Mở đầu nhóm cho mọi trình thu thập không có nhóm riêngDisallow: /cart/Một đường dẫn mà các trình thu thập này không được tảiAllow: /cart/helpMột ngoại lệ: dài hơn Disallow, nên nó thắng User-agent: GPTBotMở đầu nhóm nêu tên hai trình thu thậpUser-agent: ClaudeBotDisallow: /Cả hai đều bị chặn khỏi toàn bộ site Sitemap: https://www.example.org/sitemap.xmlNgoài mọi nhóm: một địa chỉ đầy đủ* và $: một quy tắc khớp như thế nàoKhi nhiều quy tắc cùng khớp một URL, quy tắc có đường dẫn dài nhất sẽ thắng, bất kể thuộc loại nào, và Allow thắng khi hòa. * thay cho một chuỗi ký tự bất kỳ và $ đánh dấu điểm kết thúc của URL; ngoài ra không ký tự nào trong đường dẫn mang nghĩa đặc biệt.
RFC 9309: “Kết quả khớp cụ thể nhất PHẢI được sử dụng. Kết quả khớp cụ thể nhất là kết quả có nhiều octet nhất”, và “nếu một quy tắc allow và một quy tắc disallow tương đương nhau, thì NÊN dùng quy tắc allow.” Tệp của chính WordPress hoạt động theo cách này: Disallow: /wp-admin/ đóng thư mục, còn Allow: /wp-admin/admin-ajax.php dài hơn mở một tệp bên trong nó.
Một quy tắc không có $ là một tiền tố, nên Disallow: /admin cũng chặn /administrator; hãy thêm dấu gạch chéo (/admin/) khi bạn muốn nói tới thư mục. Dưới mỗi quy tắc, trình soạn thảo ở trên hiển thị những đường dẫn nó bắt và một số đường dẫn nó không bắt, từ chính bộ so khớp quyết định mọi kết luận, và đánh dấu quy tắc nào luôn bị một quy tắc khác thắng.
* và $, và mỗi mẫu thật sự bắt được gì/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ và + là ký tự thường. robots.txt không có biểu thức chính quy.
/admin/report.pdfAllow thắng: nó khớp được phần dài hơn của đường dẫn.
Disallow: /files/7 ký tựAllow: /files/7 ký tựDài bằng nhau, nên Allow thắng. “Quy tắc có mức hạn chế thấp nhất”, như cách Google nói.
Cả ba đều đã phục vụ sẵn một tệp, và các mẫu có sẵn ở trên viết đúng những gì tài liệu của từng nền tảng mô tả: WordPress chặn khu vực quản trị nhưng cho phép admin-ajax.php, Shopify chặn giỏ hàng, trang thanh toán và các bộ sưu tập đã lọc hoặc đã sắp xếp, còn Next.js phục vụ tệp bạn đặt trong app/robots.txt.
WordPress viết tệp của mình bằng code, trong do_robots(): User-agent: *, một Disallow cho đường dẫn quản trị và một Allow cho admin-ajax.php, cộng thêm, trên một site công khai từ WordPress 5.5, một dòng Sitemap: cho /wp-sitemap.xml. Khi ô “Nếu tích chọn, Trang web sẽ được cài đặt để ẩn khỏi công cụ tìm kiếm” được đánh dấu, WordPress 5.3 trở lên không còn ghi Disallow: / nữa mà dùng thẻ meta robots.
Shopify nói tệp mặc định của họ “phù hợp với hầu hết cửa hàng”. Không có tệp nào để tải lên: muốn thay đổi thì phải sửa template robots.txt.liquid của theme, điều mà Shopify gọi là “một tùy chỉnh không được hỗ trợ”. Next.js phục vụ app/robots.txt đúng như bạn viết, hoặc dựng tệp từ app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlDo chính WordPress viết. Sửa bằng plugin hoặc filter robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlTệp mặc định của Shopify. Sửa trong template robots.txt.liquid của theme.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlTệp của chính bạn trong app/robots.txt, hoặc app/robots.ts, được phục vụ tại /robots.txt.
Một nhóm nêu tên trình thu thập, với Disallow: / bên dưới, có tác dụng với mọi trình thu thập mà nhà vận hành nói là tuân theo robots.txt, và chỉ với những trình thu thập đó. Đây là một lời yêu cầu mà trình thu thập tôn trọng, không phải ổ khóa: trình thu thập nào phớt lờ tệp vẫn có thể tải mọi trang.
Phần lớn công ty AI vận hành nhiều hơn một trình thu thập, nên hãy quyết định theo từng việc. Chặn một trình thu thập huấn luyện như GPTBot hay ClaudeBot là chặn trình thu thập lấy trang cho mô hình; chặn một trình thu thập câu trả lời như OAI-SearchBot hay PerplexityBot còn đưa bạn ra khỏi các liên kết mà những trợ lý đó hiển thị. Token huấn luyện của Google không phải Googlebot: “Google-Extended không ảnh hưởng đến việc đưa một trang web vào Google Tìm kiếm và cũng không dùng làm tín hiệu xếp hạng trên Google Tìm kiếm.”
Loại thứ ba thì khác. ChatGPT-User, Claude-User, Perplexity-User và Amzn-User tải một trang vì có người nhờ trợ lý mở trang đó, nên chặn chúng là từ chối chính người đó, và một số nhà vận hành nói các trình thu thập này dù sao cũng có thể bỏ qua robots.txt. Vì thế danh sách trình thu thập ở trên để chúng trong một mục riêng.
GPTBotTuân theoOAI-SearchBotTuân theoChatGPT-UserCó thể bỏ quaClaudeBotTuân theoClaude-SearchBotTuân theoClaude-UserTuân theoPerplexityBotTuân theoPerplexity-UserCó thể bỏ quaGoogle-ExtendedChỉ là tokenKhông có trình thu thập nàyKhông có trình thu thập nàyApplebot-ExtendedChỉ là tokenKhông có trình thu thập nàyKhông có trình thu thập nàymeta-externalagentTuân theometa-webindexerTuân theometa-externalfetcherCó thể bỏ quaAmazonbotTuân theoKhông có trình thu thập nàyAmzn-UserCó thể bỏ quaNó yêu cầu trình thu thập không tải một trang; nó không yêu cầu công cụ tìm kiếm không liệt kê trang đó. Google “vẫn có thể lập chỉ mục URL và hiển thị URL đó trong các kết quả tìm kiếm (không có đoạn trích)” khi các trang khác liên kết tới nó. Để giữ một trang ở ngoài, hãy dùng noindex, và để trang đó thu thập được để thẻ có thể được đọc.
Search Console gọi đó là “Đã lập chỉ mục, mặc dù bị robots.txt chặn”. Và Google nói rõ rằng “Để quy tắc noindex có hiệu lực, không được dùng tệp robots.txt để chặn trang hay tài nguyên”: noindex của một trang bị chặn không bao giờ được thấy, vì trình thu thập không bao giờ tải trang đó.
Đó là lý do mỗi mẫu có sẵn ở trên đều nói điều nó không làm. Disallow: / của mẫu staging giữ các trình thu thập lịch sự ở ngoài, nhưng một URL staging được liên kết từ bất cứ đâu vẫn có thể được liệt kê: hãy đặt site staging sau một mật khẩu, và đừng bao giờ đưa dòng đó lên site đang chạy thật.
<meta name="robots" content="noindex">Không bao giờ được đọcĐể giữ một trang ở ngoài: cho trình thu thập vào và dùng noindex, hoặc yêu cầu đăng nhập.
Ở thư mục gốc của host mà nó áp dụng, dưới tên /robots.txt, mỗi host và mỗi giao thức một tệp. https://example.com/robots.txt không nói gì về https://www.example.com hay https://shop.example.com: mỗi host cần một tệp riêng, và robots.txt nằm trong một thư mục con không bao giờ được đọc.
Google: “Bạn phải đặt tệp robots.txt trong thư mục cấp cao nhất của một trang web và qua một giao thức được hỗ trợ.” Báo cáo robots.txt của Search Console liệt kê riêng các tệp của 20 host hàng đầu trong một tài sản, tính HTTP và HTTPS tách biệt.
Nhập site của bạn ở đầu trình tạo, nó sẽ cho bạn địa chỉ chính xác mà tệp phải có, điền sẵn dòng Sitemap: cho host đó, và dẫn tới công cụ kiểm tra robots.txt, nơi đọc tệp thật khi nó đã lên mạng.
https://example.com/robots.txtMọi URL trên https://example.comhttps://www.example.com/robots.txtChỉ www.example.com: một host riênghttp://example.com/robots.txtChỉ site http://: một giao thức riênghttps://shop.example.com/robots.txtChỉ shop.example.comhttps://example.com/blog/robots.txtKhông gì cả: robots.txt nằm trong thư mục con không bao giờ được đọcGoogle không đọc lệnh nào trong số đó. Crawl-delay được Bing đọc, Clean-param được Yandex đọc, Host không nằm trong chuẩn cũng không có trong danh sách của Google, còn Content-Signal của Cloudflare nêu nội dung của bạn được dùng vào việc gì chứ không phải được thu thập những gì.
Google liệt kê bốn trường của mình và nói thêm rằng “các trường khác như crawl-delay không được hỗ trợ”. Blog của chính Bing viết “lệnh crawl-delay chỉ chấp nhận giá trị là số nguyên dương”, nên trình soạn thảo từ chối một số thập phân thay vì ghi nó ra. Không đọc được trang trợ giúp hiện tại của Bing để xác nhận phạm vi hay đơn vị, nên trang này không nêu điều nào trong hai.
Không lệnh nào trong số đó làm hỏng tệp: RFC 9309 yêu cầu việc phân tích các bản ghi khác “KHÔNG ĐƯỢC ảnh hưởng tới việc phân tích các bản ghi được định nghĩa rõ ràng”. Trong bốn lệnh, trình tạo chỉ ghi Crawl-delay, kèm nhãn cho biết ai đọc nó.
User-agentCó đọcCó đọcCó đọcAllowCó đọcCó đọcCó đọcDisallowCó đọcCó đọcCó đọcSitemapCó đọcCó đọcCó đọcCrawl-delayBỏ quaCó đọcChưa xác nhậnClean-paramBỏ quaBỏ quaCó đọcHostBỏ quaBỏ quaChưa xác nhậnnoindexBỏ quaChưa xác nhậnChưa xác nhậnContent-SignalBỏ quaChưa xác nhậnChưa xác nhậnHai lần. Trước khi công bố, với Test trước khi công bố ở trên: chọn một trình thu thập và một đường dẫn rồi xem quy tắc quyết định. Sau khi tải lên, hãy chạy công cụ kiểm tra robots.txt với tệp thật, vì câu trả lời của máy chủ cũng quan trọng ngang với nội dung tệp.
Một tệp trả về 404 được hiểu như không có tệp, nên mọi trình thu thập được lấy mọi thứ; một tệp trả về 500 hay 503 nghĩa là trình thu thập tuân theo chuẩn không được lấy gì. RFC 9309 §2.3.1.4: trình thu thập “PHẢI mặc định là bị cấm hoàn toàn”. Google làm dịu điều đó bằng một thang bậc của riêng mình, như trong hình.
Công cụ kiểm tra robots.txt của chính Google đã không còn: Search Central thông báo ngừng cung cấp nó ngày 15 tháng 11 năm 2023, và báo cáo robots.txt thay thế nó chỉ cho thấy tệp Google đã tải, không test một URL với một quy tắc. Test trước khi công bố, trong trình tạo ở trên, và công cụ kiểm tra robots.txt làm được việc test đó.
200Tuân theo các quy tắc trong tệp.301, 302Đi theo ít nhất năm bước chuyển hướng rồi dừng lại. Khi đó Google coi tệp là 404.403, 404Thu thập mọi thứ, như thể không có tệp.429Không thu thập gì. Google xếp mã này cùng các câu trả lời 5xx, không phải 4xx.500, 503Không thu thập gì cả, theo chuẩn.Không có tên nàyKhông có site nào để đọc, nên không có kết luận.Mỗi lỗi đắt giá chỉ là một dòng ngắn: một Disallow: / sót lại từ staging, một tiền tố vươn xa hơn ý bạn, một dòng Sitemap: viết thành đường dẫn, một đường dẫn thiếu dấu gạch chéo đầu, và một dòng noindex mà Google đã thôi đọc từ năm 2019.
Mỗi lỗi đều được bắt ở đây trước khi bạn sao chép tệp. Bước rà soát của chính công cụ kiểm tra chạy khi bạn gõ và các phát hiện nằm ngay dưới tệp; một dòng mà trình thu thập sẽ bác bỏ thì không bao giờ được ghi ra, và trình soạn thảo nói rõ ngay trên hàng đó vì sao nó bị để ngoài.
Có một lỗi là một cặp, không phải một dòng: một URL bị chặn ở đây mà cũng mang noindex trên trang. Trình thu thập không bao giờ tải trang, nên không bao giờ thấy noindex, và URL có thể vẫn nằm trong kết quả tìm kiếm. Hãy chọn một: chặn việc thu thập, hoặc cho trình thu thập vào và bảo nó đừng lập chỉ mục.
Disallow: /Sót lại từ staging: toàn bộ site đang chạy thật bị đóng với mọi trình thu thập.Disallow: /adminCũng chặn /administrator và /admin-tools. Hãy thêm dấu gạch chéo ở cuối.Allow: / dưới User-agent: *Không bao giờ được đọc bởi trình thu thập có nhóm riêng ở bất kỳ đâu trong tệp.Sitemap: /sitemap.xmlDòng Sitemap phải là địa chỉ đầy đủ kèm host.Disallow: adminĐường dẫn bắt đầu từ /. Quy tắc này không khớp gì cả.noindex: /private/Đã chết từ năm 2019. Trang vẫn có thể được thu thập và lập chỉ mục.* chứa Allow của bạn. Trình soạn thảo ở trên đánh dấu quy tắc luôn bị một quy tắc khác thắng, và Test trước khi công bố nêu quy tắc quyết định cùng nhóm mà trình thu thập đã đọc.Còn thiếu điều gì?Đề xuất tính năng hoặc công cụ mới
Tải robots.txt của bất kỳ website nào, test xem URL có bị chặn với Googlebot hoặc crawler AI không và tìm lỗi cú pháp
Thu thập dữ liệu website và nhận sitemap XML, sitemap HTML và cây cấu trúc site
Tìm và xác thực XML sitemap của website: cú pháp, giới hạn URL, ngày lastmod, xung đột với robots.txt và URL lỗi hoặc chuyển hướng
Kiểm tra title, meta description, canonical, hreflang, thẻ Open Graph và X card của trang, kèm bản xem trước trên Google và mạng xã hội
Phân tích header phản hồi HTTP và chấm điểm header bảo mật
Phát hiện trình duyệt, hệ điều hành, loại thiết bị, engine dựng hình và kiến trúc CPU từ chuỗi User Agent