











Robots.txt Tester
Ein Robots.txt Tester, der seinen Rechenweg zeigt: die Regel, die über Ihre URL entschieden hat, samt Zeilennummer; die Gruppe, die ein Crawler tatsächlich gelesen hat, und warum er die anderen übergangen hat; und was der Statuscode Ihrer Datei für die ganze Website bedeutet. So können Sie Ihre robots.txt testen, statt zu raten.
Geben Sie eine Domain ein, um ihre Datei zu lesen, oder eine vollständige URL wie example.com/admin/, um auch diesen Pfad zu testen.
- AbrufGET /robots.txt
- LesenGruppen, Regeln, Sitemaps
- Gruppewelche Regeln ein Crawler befolgt
- Urteilwas jeder Crawler crawlen darf
Robots.txt testen, seit Googles Tester abgeschaltet ist
Geben Sie oben eine Domain ein und wählen Sie „robots.txt prüfen“. Wir rufen die Datei einmal von unserem Server ab und testen dann in Ihrem Browser jede URL, die Sie eingeben, für jeden Crawler, den Sie wählen – genau das, was Googles eigener robots.txt-Tester konnte, bevor er eingestellt wurde.
Google hat die Änderung am 15. November 2023 angekündigt: „Im Rahmen dieses Updates stellen wir den robots.txt-Tester ein.“ Der alte Tester verschwand im Dezember 2023, und der robots.txt-Bericht der Search Console, der ihn ersetzt hat, ist etwas ganz anderes.
Dieser Bericht listet die Dateien, die Google bereits abgerufen hat, für die 20 wichtigsten Hosts einer Property, die Ihnen gehört und die Sie bestätigt haben, mit dem Datum der Prüfung, der Größe in Byte und der Zahl der Probleme. Er kann keine URL gegen eine Regel testen, keinen Crawler testen, der nicht von Google stammt, und keine Website ansehen, die Ihnen nicht gehört. Diese Seite kann alle drei.
- Die Datei, die Google zuletzt abgerufen hat
- Ihre Größe und das Datum der Prüfung
- Die Zahl der Parsing-Probleme
- Ist diese URL für diesen Crawler erlaubt?
- Welche Regel entschieden hat, und in welcher Zeile
- Ein Crawler, der nicht von Google stammt
- Eine Website, die Ihnen nicht gehört
Google hat die Änderung am 15. November 2023 angekündigt und den Tester im Dezember 2023 entfernt.
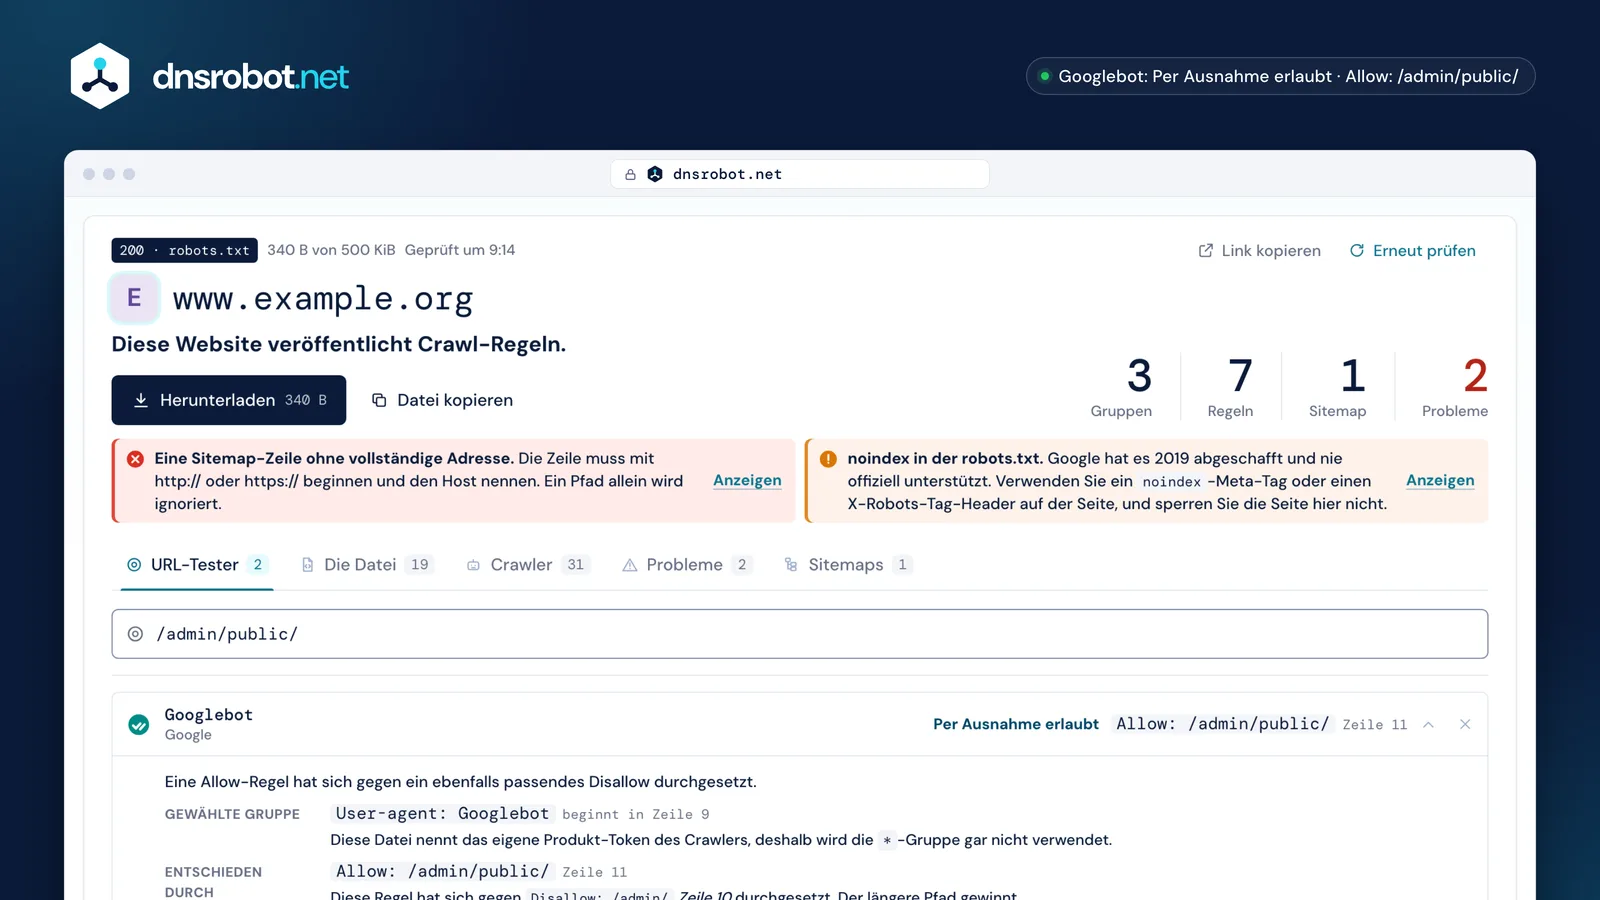
 Die FolgeNicht der Statuscode allein, sondern was er für die ganze Website bedeutet. Ein 404 lässt hier jeden Crawler alles abrufen; bei einem 503 ruft ein Crawler, der dem Standard folgt, gar nichts ab.Die entscheidende RegelDie Regel, die für diesen Crawler über diese URL entschieden hat, mit ihrer Zeilennummer und der Regel, gegen die sie sich durchgesetzt hat. Der längste Treffer gewinnt, und bei Gleichstand gewinnt Allow.Die gewählte GruppeWelche Gruppe der Crawler tatsächlich gelesen hat und warum er die anderen übergangen hat. Genau diesen Schritt lassen die übrigen Tools weg.Die BefundeJedes Problem in seiner eigenen Zeile der Datei, mit dem, was zu tun ist.
Wie wählt Google die Gruppe, die für einen Crawler gilt?
Ein Crawler befolgt genau einen Regelsatz. Er sucht eine Gruppe, deren User-agent-Zeile sein eigenes Produkt-Token nennt; nur wenn es keine gibt, greift er auf die Gruppe * zurück. Die *-Gruppe ist ein Ersatz, nie eine Ergänzung.
RFC 9309 sagt es deutlich: „Crawler MÜSSEN ohne Beachtung der Groß- und Kleinschreibung abgleichen, um die Gruppe zu finden, die zum Produkt-Token passt“, und „[gibt es] keine passende Gruppe, MÜSSEN Crawler die Gruppe mit einer user-agent-Zeile mit dem Wert * befolgen, sofern vorhanden.“ Google sagt dasselbe mit eigenen Worten: „Für einen bestimmten Crawler gilt jeweils nur eine Gruppe.“
Daraus folgen zwei Dinge, die zusammen für die meiste Verwirrung sorgen. Mehrere Gruppen, die dasselbe Token nennen, werden zu einer zusammengeführt, also zählen zwei Blöcke User-agent: Googlebot beide. Eine benannte Gruppe und die *-Gruppe werden dagegen nie zusammengeführt: Ein Allow: / unter * bewirkt für Googlebot nichts, sobald es eine Googlebot-Gruppe gibt. Googlebot-Image und die anderen Googlebot-*-Crawler greifen auf die googlebot-Gruppe zurück – ein Verhalten, das der Crawler über den reinen Regelabgleich hinaus mitbringt; Googles eigener Open-Source-Matcher setzt es nicht um.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Nennt eine Gruppe das eigene Token dieses Crawlers?Diese Gruppe lesen. Die
*-Gruppe wird nicht verwendet. - 2Nennen ihn mehrere?Alle zusammen als eine Gruppe lesen.
- 3Gibt es eine
*-Gruppe?Die*-Gruppe lesen. - —Keine Regeln gelten. Alles darf gecrawlt werden.
Allow: / unter * wird nie gelesen.
*.Allow vs. Disallow: Der längste Treffer gewinnt
Passen mehrere Regeln auf eine URL, gewinnt die mit dem längsten Pfad, egal welcher Art sie ist. Sind ein Allow und ein Disallow gleich lang, gewinnt das Allow.
RFC 9309: „Der spezifischste Treffer MUSS verwendet werden. Der spezifischste Treffer ist der mit den meisten Oktetten“, und „wenn eine allow-Regel und eine disallow-Regel gleichwertig sind, SOLLTE die allow-Regel verwendet werden.“ Google beschreibt dasselbe Verhalten: Bei widersprüchlichen Regeln verwendet Google „die am wenigsten restriktive“.
Oktette, nicht Zeichen: Ein Pfad mit Umlauten oder einem %2F wird nach der Prozentkodierung verglichen – genau dort liegen naive Tools falsch. Verglichen werden nur Pfad und Query, ab dem ersten Zeichen, und dabei zählt die Groß- und Kleinschreibung, anders als bei den Namen der Anweisungen: Disallow: /File.pdf bewirkt nichts bei /file.pdf.
/admin/report.pdfDas Allow gewinnt: Es deckt mehr vom Pfad ab.
Disallow: /files/7 ZeichenAllow: /files/7 ZeichenGleiche Länge, also gewinnt das Allow. Die „am wenigsten restriktive“ Regel, wie Google es ausdrückt.
Die einzigen zwei Platzhalter: `*` und `$`
* steht für eine beliebige Zeichenfolge, $ markiert das Ende der URL. Mehr gibt es nicht: keine regulären Ausdrücke und keine besondere Bedeutung für ?, ., [ oder + – das sind alles gewöhnliche Zeichen.
Eine Regel ohne $ ist ein Präfix, Disallow: /admin sperrt also auch /administrator und /admin-tools. Setzen Sie einen Schrägstrich ans Ende (/admin/), wenn Sie den Ordner meinen, und ein $, wenn Sie genau diese URL meinen. Disallow: /*.pdf$ sperrt jedes PDF; Disallow: /*? sperrt jede URL mit Query-String.
Der URL-Tester oben zeigt die Pfade, die eine Regel ebenfalls erfasst, aus demselben Matcher, der das Urteil gefällt hat. So sehen Sie eine Regel, die weiter reicht als gewollt, bevor Sie sie veröffentlichen.
* und $ und was jedes Muster wirklich erfasst/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ und + sind gewöhnliche Zeichen. In der robots.txt gibt es keine regulären Ausdrücke.
Was bedeutet der Statuscode Ihrer robots.txt?
Ein 4xx und ein 5xx auf dieselbe kaputte Datei haben gegenteilige Folgen. Ein 4xx wird so gelesen, als gäbe es keine Datei, ein Crawler darf also alles abrufen. Ein 5xx heißt, dass die Datei undefiniert ist, ein standardkonformer Crawler darf also nichts abrufen.
RFC 9309 §2.3.1.3: Zeigt der Status, dass die Datei „für den Crawler nicht verfügbar ist, DARF der Crawler auf alle Ressourcen auf dem Server zugreifen“. §2.3.1.4: Ist sie „aufgrund von Server- oder Netzwerkfehlern nicht erreichbar … MUSS der Crawler von einem vollständigen Disallow ausgehen.“ Google behandelt „alle 4xx-Fehler mit Ausnahme von 429 so, als wäre keine gültige robots.txt-Datei vorhanden“ – damit landet 429 auf der Seite der 5xx.
Den 5xx-Fall entschärft Google mit einer eigenen Stufenfolge: In den ersten 12 Stunden stoppt es das Crawlen, die nächsten 30 Tage nutzt es seine letzte gute Kopie, und danach verhält es sich, wenn der Rest der Website erreichbar ist, als gäbe es gar keine robots.txt. Google folgt mindestens fünf Weiterleitungs-Hops, bricht dann ab und „geht von einem 404-Fehler für die robots.txt-Datei aus“, das heißt: frei crawlen. Und ein Name, der sich nicht auflösen lässt, ist keine Website, die jemanden sperrt – es gibt keine Datei und kein Urteil.
200Befolgt die Regeln in der Datei.301, 302Folgt mindestens fünf Hops und bricht dann ab. Google wertet die Datei danach als 404.403, 404Crawlt alles, als gäbe es keine Datei.429Crawlt nichts. Google zählt das zu den 5xx-Antworten, nicht zu den 4xx.500, 503Crawlt laut Standard gar nichts.Kein solcher NameEs gibt keine Website zu lesen, also gibt es kein Urteil.- 1Erste 12 StundenStoppt das Crawlen der Website und versucht weiter, die Datei abzurufen
- 2Bis zu 30 TageNutzt seine letzte gute Kopie der robots.txt
- 3Nach 30 TagenVerhält sich, wenn die Website erreichbar ist, als gäbe es keine robots.txt
Hält robots.txt eine Seite aus Google heraus?
Nein. Die Datei bittet einen Crawler, die Seite nicht abzurufen – nicht aber eine Suchmaschine, sie nicht aufzulisten. Google kann eine gesperrte Seite nicht lesen, „aber die URL kann möglicherweise dennoch indexiert und ohne Snippet in den Suchergebnissen angezeigt werden“, wenn andere Seiten auf sie verlinken.
Das ist der Status „Indexiert, obwohl durch robots.txt-Datei blockiert“ in der Search Console: „Google fordert die Seite nicht an und crawlt sie nicht. Wir können sie jedoch indexieren, indem wir die Informationen von der Seite verwenden, die auf Ihre blockierte Seite verweist.“ Googles eigene Lösung: „Entfernen Sie die Blockierregel in der robots.txt-Datei und verwenden Sie das Tag noindex.“
Der häufigste Fehler in einer robots.txt ist deshalb ein Paar, keine einzelne Zeile: eine URL, die sowohl hier gesperrt ist als auch noindex trägt. Google sagt das ausdrücklich: „Wenn die Seite durch eine robots.txt-Datei blockiert wird oder nicht für den Crawler zugänglich ist, sieht der Crawler die Regel noindex nicht und die Seite kann weiterhin in den Suchergebnissen erscheinen“. Entscheiden Sie sich: das Crawlen sperren, oder den Crawler hereinlassen und ihm sagen, dass er nicht indexieren soll.
- Crawler
- Liest die robots.txt
- Die URL ist gesperrt
- Ruft die Seite nicht ab
<meta name="robots" content="noindex">Nie gelesenUm eine Seite herauszuhalten: den Crawler hereinlassen und noindex verwenden, oder eine Anmeldung verlangen.
Wie sperre ich ChatGPT, Claude und die anderen KI-Crawler?
Mit je einer gewöhnlichen Gruppe. Die KI-Unternehmen veröffentlichen Produkt-Tokens genau wie Suchmaschinen, und die meisten betreiben mehrere: einen fürs Training, einen, der eine Frage mit einem Link zurück beantwortet, und einen, der eine Seite abruft, weil eine Person danach gefragt hat.
Diese drei sollten Sie auseinanderhalten. Wer einen Trainings-Crawler sperrt, hält seine Seiten aus einem Modell heraus; wer einen Antwort-Crawler sperrt, verschwindet auch aus den Quellenangaben, die diese Produkte zeigen. Die Ansicht „Crawler“ oben nennt für jeden den Zweck, das Token und was die Dokumentation seines Betreibers über die Befolgung sagt – so können Sie das Training ablehnen, ohne aus KI-Antworten zu verschwinden.
Manche Betreiber sagen offen, dass der Crawler, der eine Seite im Auftrag einer einzelnen Person abruft, robots.txt ignorieren kann, weil er für einen Nutzer handelt, statt zu crawlen. Die Tabelle markiert diese Crawler. Und Cloudflares Content-Signal-Zeilen, die immer mehr Websites veröffentlichen, sind eine Aussage darüber, wofür Ihre Inhalte verwendet werden dürfen, keine Crawl-Regel: Diese Seite behält sie und erklärt sie, statt sie als Fehler zu melden.
GPTBotBefolgtOAI-SearchBotBefolgtChatGPT-UserKann ignorieren
ClaudeBotBefolgtClaude-SearchBotBefolgtClaude-UserBefolgt
PerplexityBotBefolgtPerplexity-UserKann ignorierenGoogle-ExtendedNur TokenKein solcher CrawlerKein solcher Crawler
Applebot-ExtendedNur TokenKein solcher CrawlerKein solcher Crawler
meta-externalagentBefolgtmeta-webindexerBefolgtmeta-externalfetcherKann ignorieren
AmazonbotBefolgtKein solcher CrawlerAmzn-UserKann ignorieren- TrainingSammelt Seiten, um ein Modell zu trainieren.
- KI-AntwortenRuft Seiten ab, um eine Frage zu beantworten, meist mit einem Link zurück zu Ihnen.
- Anfrage einer PersonRuft eine Seite ab, weil jemand danach gefragt hat. Manche Betreiber sagen, dass dieser Crawler robots.txt ignorieren kann.
Crawl-delay, Clean-param, Host und Content-Signal: Wer liest was?
Google liest vier Felder und keine anderen: user-agent, allow, disallow und sitemap. Alles andere in einer robots.txt liest jemand anderes oder niemand – und eine unbekannte Zeile ist nie ein Fehler.
Google nennt seine vier Felder und ergänzt: „andere Felder wie crawl-delay werden nicht unterstützt“. Bing unterstützt Crawl-delay sehr wohl, laut Bings eigenem Blog: „Die crawl-delay-Anweisung akzeptiert als Werte nur positive ganze Zahlen“. Clean-param gehört Yandex und sonst niemandem. Host steht weder im Standard noch in Googles Liste.
Keine davon macht eine Datei kaputt. RFC 9309 verlangt, dass das Parsen anderer Einträge „das Parsen ausdrücklich definierter Einträge NICHT beeinträchtigen DARF“, ein Crawler, der eine Zeile nicht kennt, überspringt sie also. Wirklich tot sind nur zwei Anweisungen: noindex und nofollow in der robots.txt. Google hat den Code, der sie verarbeitete, 2019 entfernt, und heute bewirken sie bei Google nichts.

User-agentLiest sieLiest sieLiest sieAllowLiest sieLiest sieLiest sieDisallowLiest sieLiest sieLiest sieSitemapLiest sieLiest sieLiest sieCrawl-delayIgnoriert sieLiest sieNicht bestätigtClean-paramIgnoriert sieIgnoriert sieLiest sieHostIgnoriert sieIgnoriert sieNicht bestätigtnoindexIgnoriert sieNicht bestätigtNicht bestätigtContent-SignalIgnoriert sieNicht bestätigtNicht bestätigt- Google unterstützt vier Felder und sagt das auch: user-agent, allow, disallow und sitemap.
- Bings eigener Blog bestätigt Crawl-delay. Einen Wertebereich oder eine Einheit nennen wir nicht: Bings aktuelle Hilfeseite ließ sich nicht lesen, um beides zu prüfen.
- Von Google 2019 abgeschafft und nie Teil des Standards.
- Cloudflares Content Signals Policy: eine Aussage darüber, wie Inhalte verwendet werden dürfen, keine Crawl-Regel.
Die 500-KiB-Grenze und was dahinter liegt
Google liest die ersten 500 Kibibyte einer robots.txt und ignoriert alles danach, ohne irgendwo einen Fehler zu melden. RFC 9309 setzt 500 KiB als Untergrenze für das Parse-Limit eines Crawlers; Google nennt den Wert als Obergrenze.
Google: „Google erzwingt für robots.txt-Dateien eine Höchstgrenze von 500 Kibibyte (KiB). Alles, was sich jenseits der maximalen Dateigröße befindet, wird ignoriert.“ Nichts warnt Sie. Eine Datei mit 600 KiB ist nicht ungültig – ihre letzten 100 KiB existieren für Googlebot einfach nicht, und ein Disallow dort unten schützt nichts.
Websites erreichen die Grenze öfter, als man denkt: eine Regel pro Kampagnenparameter, pro Facettenfilter, pro altem Staging-Ordner. Die Prüfung oben misst die Datei an der Grenze und sagt Ihnen, wie viel dahinter liegt. Ersetzen Sie lange Listen durch Muster (Disallow: /*?filter=), und setzen Sie die wichtigen Regeln nach oben.
Disallow: /cart/ · Zeile 12BefolgtDisallow: /private/ · Zeile 9.412Nie gelesenDie Datei antwortet weiterhin mit 200 und lässt sich weiterhin parsen. Nirgends erfahren Sie, dass der Rest verworfen wurde.
Häufige Fehler in der robots.txt und wie Sie sie finden
Die meisten kaputten robots.txt-Dateien sind auf eine von sechs Arten kaputt, und keine davon fällt auf, solange nichts sie testet: Die Datei antwortet weiterhin mit 200, lässt sich weiterhin parsen und sieht weiterhin richtig aus.
Den Klassiker kennt jeder: Disallow: /, vergessen, als die Website aus dem Staging live ging. Die anderen fünf: eine Regel, die weiter reicht als gewollt, etwa Disallow: /admin, die auch /administrator erfasst; ein Allow: / unter *, das eine benannte Gruppe stillschweigend ignoriert; eine Sitemap:-Zeile mit einem Pfad statt einer vollständigen Adresse; ein Pfad ohne führenden Schrägstrich, der auf nichts passt; und eine noindex-Zeile, die Google seit 2019 nicht mehr liest.
Starten Sie die Prüfung oben und lesen Sie dann die Ansicht „Probleme“: Jeder Befund steht in seiner eigenen Zeile der Datei, mit dem, was zu tun ist. Wenn Sie die Datei bearbeiten, statt sie zu prüfen, schreibt der robots.txt-Generator eine Datei, die genau dieser Checker bereits gelesen hat.
Quellen
- RFC 9309, das Robots Exclusion Protocol: Gruppen, Vorrang, Abgleich nach Prozentkodierung, Statuscodes und die Untergrenze von 500 KiB
- Google Search Central: wie Google die robots.txt interpretiert, eine robots.txt-Datei erstellen und einreichen und die Indexierung mit noindex blockieren
- Hilfe zur Google Search Console: der robots.txt-Bericht und der Bericht zur Seitenindexierung
- Bing: Crawl-delay und der Bing-Crawler und Yandex: Clean-param
- Googles Open-Source-Parser für robots.txt, der Matcher, den Googlebot selbst verwendet
- Token, Zweck und robots.txt-Verhalten jedes Crawlers stammen aus der Dokumentation seines Betreibers, verlinkt neben ihm in der Ansicht „Crawler“
Disallow: /Vom Staging übrig geblieben: Die ganze Live-Website ist für jeden Crawler gesperrt.Disallow: /adminSperrt auch /administrator und /admin-tools. Setzen Sie den Schrägstrich ans Ende.Allow: / unter User-agent: *Ein Crawler, der irgendwo in der Datei eine eigene Gruppe hat, liest es nie.Sitemap: /sitemap.xmlEine Sitemap-Zeile muss eine vollständige Adresse mit Host sein.Disallow: adminEin Pfad beginnt bei /. Diese Regel passt auf nichts.noindex: /private/Seit 2019 tot. Die Seite bleibt crawlbar und indexierbar.Robots.txt Tester: häufige Fragen
Was ist aus Googles robots.txt Tester geworden?
Warum wird mein Allow: / unter User-agent: * ignoriert?
*-Gruppe wird komplett übersprungen – sie ist ein Ersatz, keine Ergänzung. Zusammengeführt werden Gruppen nur, wenn mehrere dasselbe Token nennen. Der URL-Tester oben zeigt für jeden Crawler, welche Gruppe gewählt wurde und warum die anderen nicht.Verhindert robots.txt, dass eine Seite indexiert wird?
noindex-Meta-Tag oder einen X-Robots-Tag-Header aus, oder stellen Sie die Seite hinter eine Anmeldung.Warum funktioniert mein noindex nicht?
noindex, also kann die Seite über Links von anderswo weiter in den Suchergebnissen erscheinen. Google sagt es direkt: Damit noindex wirksam wird, „darf die Seite oder Ressource nicht durch eine robots.txt-Datei blockiert werden“. Entfernen Sie die Disallow-Zeile und behalten Sie das noindex.Was bedeutet ein 404 auf die robots.txt? Und ein 500?
Wenn Allow und Disallow beide passen, welche Regel gewinnt?
Welche Platzhalter funktionieren in der robots.txt?
* steht für eine beliebige Zeichenfolge, $ markiert das Ende der URL. Alles andere gilt wörtlich: ?, ., [, ] und + stehen für sich selbst, und reguläre Ausdrücke gibt es nicht. Eine Regel ohne $ ist ein Präfix, Disallow: /admin erfasst also auch /administrator. Pfade unterscheiden Groß- und Kleinschreibung, Anweisungsnamen wie Disallow dagegen nicht.Unterstützt Google Crawl-delay?
Wie groß darf eine robots.txt-Datei sein?
Wie sperre ich KI-Crawler wie GPTBot und ClaudeBot?
Disallow: /, genau wie bei einer Suchmaschine. Die meisten KI-Unternehmen betreiben mehrere Crawler mit unterschiedlichen Aufgaben: einen fürs Training, einen, der Fragen mit einem Link zurück zu Ihnen beantwortet, und einen, der im Auftrag einer Person eine einzelne Seite abruft. Die Ansicht „Crawler“ oben nennt jedes Token, seinen Zweck und was sein Betreiber über die Befolgung sagt – so können Sie das Training ablehnen, ohne KI-Quellenangaben zu verlieren.Robots.txt testen oder validieren: Ist das dasselbe?
Ist robots.txt ein Sicherheitsrisiko?
Disallow: /admin-backup/ ist ein Wegweiser zu genau dem, was Sie verbergen wollten. Nichts darin verhindert den Zugriff; ein Crawler befolgt sie nur, weil sein Betreiber es so entschieden hat. Schützen Sie private Pfade mit Authentifizierung oder einer Firewall-Regel – dieser Checker zeigt Ihnen die Pfade in Ihrer Datei, die wie eine Einladung wirken.Fehlt Ihnen etwas?Funktion oder neues Tool vorschlagen
Weitere Tools zum Crawlen und Indexieren
Sitemap-Checker
Die XML-Sitemap einer Website finden und validieren: Syntax, URL-Limits, lastmod-Daten, robots.txt-Konflikte und defekte oder umgeleitete URLs
Sitemap-Generator
Ihre Website crawlen und eine XML-Sitemap, eine HTML-Sitemap und einen visuellen Website-Baum erhalten
HTTP-Header-Checker
HTTP-Antwort-Header und Sicherheits-Header-Bewertung analysieren
Redirect Checker
URL-Weiterleitungen, Weiterleitungsketten und HTTP-Statuscodes für SEO prüfen
Mein User Agent
Browser, Betriebssystem, Gerätetyp, Rendering-Engine und CPU-Architektur aus Ihrem User Agent String erkennen
Link-Analyse
Alle Links einer Webseite mit Dofollow/Nofollow-Erkennung und HTTP-Statusprüfung analysieren