











Verificador de Robots.txt
Um verificador de robots.txt que mostra o raciocínio. Ao testar o robots.txt, você vê a regra que decidiu sua URL, com o número da linha; o grupo que o rastreador realmente leu e por que os outros foram ignorados; e o que o código de status do seu arquivo significa para o site inteiro.
Digite um domínio para ler o arquivo dele, ou uma URL completa como example.com/admin/ para testar também esse caminho.
- BuscaGET /robots.txt
- Leituragrupos, regras, sitemaps
- Grupoquais regras um rastreador obedece
- Vereditoo que cada rastreador pode rastrear
Como testar robots.txt agora que o testador do Google saiu do ar
Digite um domínio acima e selecione Verificar robots.txt. Buscamos o arquivo uma vez a partir do nosso servidor e depois testamos contra ele, no seu navegador, qualquer URL que você digitar, para qualquer rastreador que escolher — que é o que o testador de robots.txt do próprio Google fazia antes de ser aposentado.
O Google anunciou a mudança em 15 de novembro de 2023: “Como parte desta atualização, estamos descontinuando o testador de robots.txt.” O testador antigo saiu em dezembro de 2023, e o relatório robots.txt do Search Console que entrou no lugar dele é outro tipo de coisa.
Esse relatório lista os arquivos que o Google já buscou para os 20 principais hosts de uma propriedade que você tem e verificou, com a data da verificação, o tamanho em bytes e uma contagem de problemas. Ele não consegue testar uma URL contra uma regra, testar um rastreador que não é do Google nem olhar um site que não é seu. Esta página faz as três coisas.
- O arquivo que o Google buscou por último
- O tamanho e a data em que foi verificado
- Uma contagem de problemas de análise
- Esta URL está liberada para este rastreador?
- Qual regra decidiu, e em qual linha
- Um rastreador que não é do Google
- Um site que não é seu
O Google anunciou a mudança em 15 de novembro de 2023 e removeu o testador em dezembro de 2023.
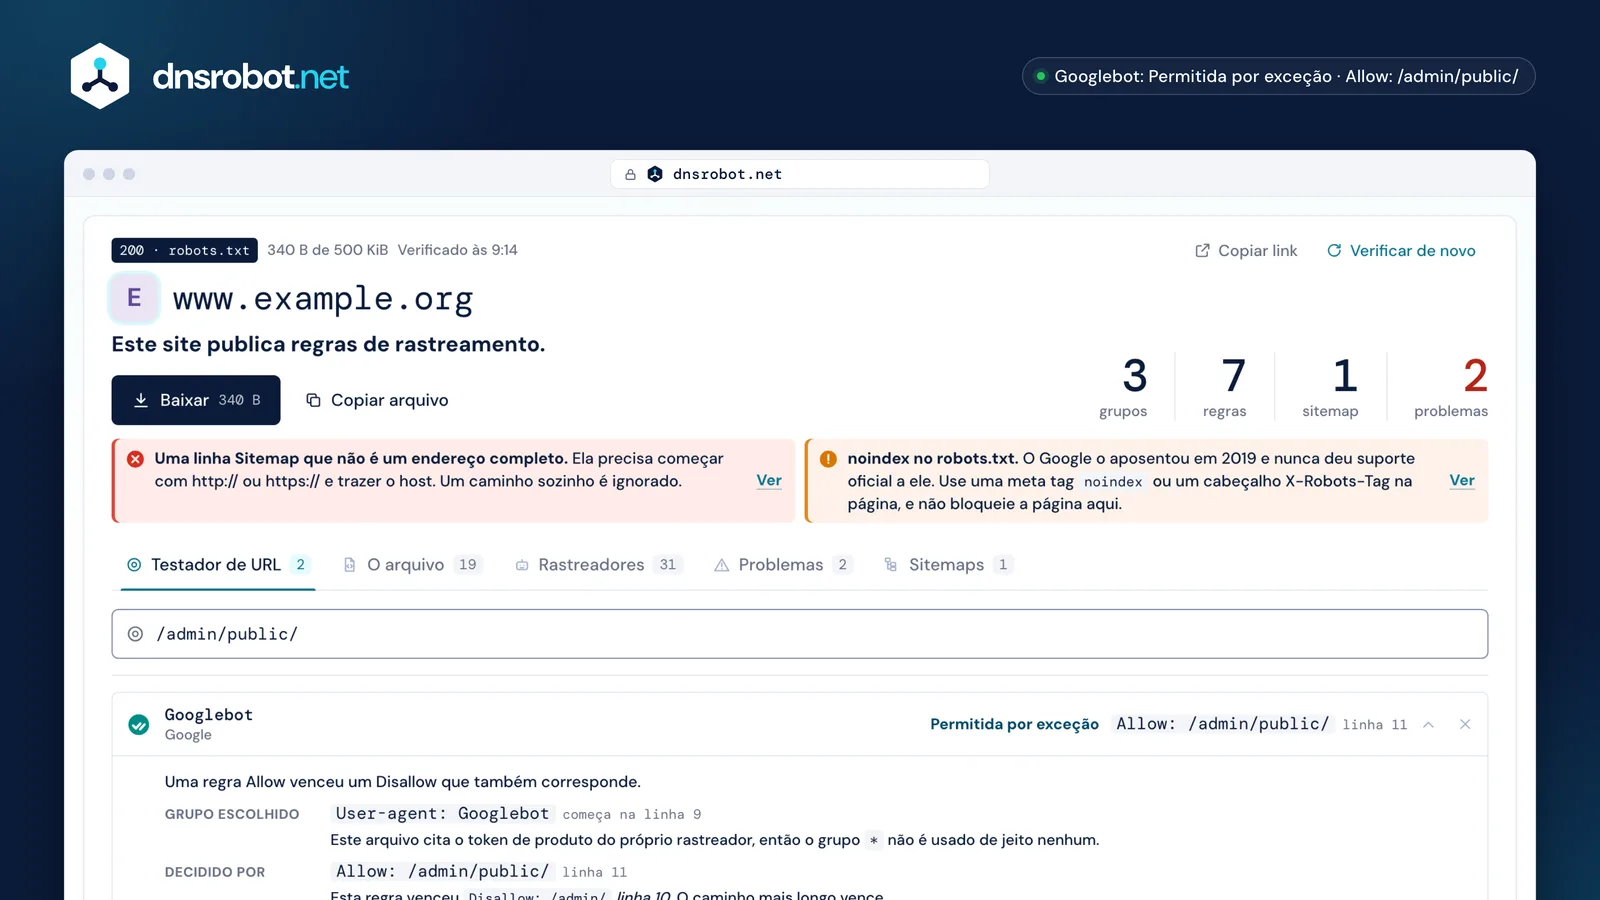
 A consequênciaNão o código de status sozinho: o que ele significa para o site inteiro. Um 404 aqui deixa todo rastreador rastrear tudo; um 503 quer dizer que um rastreador que segue o padrão não rastreia nada.A regra decisivaA regra que decidiu esta URL para este rastreador, com o número da linha e a regra que ela venceu. A correspondência mais longa vence, e um Allow vence o empate.O grupo escolhidoQual grupo o rastreador realmente leu, e por que os outros foram ignorados. É a etapa que as outras ferramentas deixam de fora.Os problemasCada problema na própria linha do arquivo, com o que fazer a respeito.
Como o Google escolhe qual grupo vale para um rastreador?
Um rastreador obedece a exatamente um conjunto de regras. Ele procura um grupo cuja linha User-agent cite o próprio token de produto dele; só se não houver nenhum é que ele recorre ao grupo chamado *. O grupo * é um plano B, nunca um acréscimo.
A RFC 9309 diz com clareza: “Os rastreadores DEVEM usar correspondência sem distinção entre maiúsculas e minúsculas para encontrar o grupo que corresponde ao token de produto” e “[se] não existir grupo correspondente, os rastreadores DEVEM obedecer ao grupo com uma linha user-agent de valor *, se houver.” O Google diz o mesmo com outras palavras: “Só um grupo é válido para um determinado rastreador.”
Duas coisas decorrem disso, e juntas causam a maior parte da confusão. Vários grupos que citam o mesmo token são fundidos num só, então dois blocos User-agent: Googlebot contam os dois. Mas um grupo com nome e o grupo * nunca são fundidos: um Allow: / sob * não faz nada pelo Googlebot quando existe um grupo Googlebot. O Googlebot-Image e os outros rastreadores Googlebot-* recorrem ao grupo googlebot, um comportamento que o rastreador acrescenta por cima do algoritmo de correspondência — o algoritmo de código aberto do próprio Google não o implementa.
- 1
# www.example.org - 2
User-agent: * - 3
Allow: / - 4
Disallow: /cart/ - 5
- 6
User-agent: Googlebot - 7
Disallow: /admin/ - 8
Allow: /admin/report.pdf - 9
- 10
Sitemap: https://www.example.org/sitemap.xml
- 1Algum grupo cita o próprio token deste rastreador?Ler esse grupo. O grupo
*não é usado. - 2Mais de um cita?Ler todos como um só grupo.
- 3Existe um grupo
*?Ler o grupo*. - —Nenhuma regra se aplica. Tudo pode ser rastreado.
Allow: / sob * nunca é lido.
*.Allow x Disallow: a correspondência mais longa vence
Quando mais de uma regra corresponde a uma URL, vence a que tem o caminho mais longo, seja de que tipo for. Se um Allow e um Disallow têm o mesmo comprimento, o Allow vence.
RFC 9309: “A correspondência mais específica encontrada DEVE ser usada. A correspondência mais específica é a que tem mais octetos”, e “se uma regra allow e uma regra disallow forem equivalentes, a regra allow DEVERIA ser usada.” O Google descreve o mesmo comportamento como usar “a regra menos restritiva” quando as regras entram em conflito.
Octetos, não caracteres: um caminho com letras acentuadas ou um %2F é comparado depois da codificação percentual, e é aí que as ferramentas ingênuas erram. Só o caminho e a consulta são comparados, a partir do primeiro caractere, e eles diferenciam maiúsculas de minúsculas, embora os nomes das diretivas não diferenciem — Disallow: /File.pdf não faz nada com /file.pdf.
/admin/report.pdfO Allow vence: ele corresponde a uma parte maior do caminho.
Disallow: /files/7 caracteresAllow: /files/7 caracteresComprimento igual, então o Allow vence. “A regra menos restritiva”, como diz o Google.
Os dois únicos curingas: `*` e `$`
* vale por qualquer sequência de caracteres, e $ marca o fim da URL. Não existe mais nada: nenhuma expressão regular e nenhum significado especial para ?, ., [ ou +, que são todos caracteres comuns.
Uma regra sem $ é um prefixo, então Disallow: /admin também bloqueia /administrator e /admin-tools. Acrescente uma barra no final (/admin/) quando quiser dizer a pasta, e um $ quando quiser dizer exatamente aquela URL. Disallow: /*.pdf$ bloqueia todo PDF; Disallow: /*? bloqueia toda URL com string de consulta.
O Testador de URL acima mostra os caminhos que uma regra também pega, a partir do mesmo algoritmo que produziu o veredito, então uma regra que vai mais longe do que você queria fica visível antes de você publicá-la.
* e $, e o que cada padrão pega de verdade/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ e + são caracteres comuns. Não existem expressões regulares no robots.txt.
O que significa o código de status do seu robots.txt?
Um 4xx e um 5xx no mesmo arquivo quebrado têm resultados opostos. Um 4xx é lido como se não houvesse arquivo, então um rastreador pode rastrear tudo. Um 5xx quer dizer que o arquivo é indefinido, então um rastreador que cumpre o padrão não pode rastrear nada.
RFC 9309 §2.3.1.3: se o status diz que o arquivo “está indisponível para o rastreador, então o rastreador PODE acessar quaisquer recursos no servidor”. §2.3.1.4: se ele “está inacessível por erros de servidor ou de rede… o rastreador DEVE presumir bloqueio total.” O Google trata “todos os erros 4xx, exceto 429, como se não existisse um arquivo robots.txt válido”, o que põe o 429 do lado dos 5xx.
Depois o Google ameniza o caso 5xx com uma escada própria: para de rastrear nas primeiras 12 horas, usa a última cópia boa nos 30 dias seguintes e, depois disso, se o resto do site estiver no ar, age como se não houvesse robots.txt nenhum. O Google segue pelo menos cinco saltos de redirecionamento, depois para e “trata como um 404 para o arquivo robots.txt”, o que significa rastrear à vontade. E um nome que não resolve não é um site bloqueando ninguém — não há arquivo, e não há veredito.
200Segue as regras do arquivo.301, 302Segue pelo menos cinco saltos e depois para. Aí o Google lê o arquivo como um 404.403, 404Rastreia tudo, como se não houvesse arquivo.429Não rastreia nada. O Google conta esta resposta com as 5xx, não com as 4xx.500, 503Não rastreia absolutamente nada, pelo padrão.Nome inexistenteNão há site para ler, então não há veredito.- 1Primeiras 12 horasPara de rastrear o site e continua tentando buscar o arquivo
- 2Até 30 diasUsa a última cópia boa do robots.txt
- 3Depois de 30 diasSe o site estiver no ar, age como se não houvesse robots.txt
O robots.txt tira uma página do Google?
Não. Ele pede a um rastreador que não busque a página; não pede a um buscador que não a liste. O Google não consegue ler uma página bloqueada, mas “ainda pode indexar a URL e mostrá-la nos resultados de pesquisa sem um snippet” quando outras páginas apontam para ela.
É o status do Search Console “Página indexada, mas bloqueada pelo robots.txt”: “O Google não vai solicitar nem rastrear a página, mas ainda podemos indexá-la usando as informações da página que tem um link para a sua página bloqueada.” A correção que o próprio Google indica é “remover o bloqueio do robots.txt e usar uma diretiva noindex”.
O que faz do erro mais comum no robots.txt um par, não uma linha: uma URL que está ao mesmo tempo bloqueada aqui e com noindex. O Google é explícito: “se a página estiver bloqueada por um arquivo robots.txt… o rastreador nunca verá a regra noindex, e a página ainda poderá aparecer nos resultados de pesquisa”. Escolha uma das duas: bloqueie o rastreamento, ou deixe o rastreador entrar e diga a ele que não indexe.
- Rastreador
- Lê o robots.txt
- A URL está bloqueada
- Não busca a página
<meta name="robots" content="noindex">Nunca lidaPara manter uma página fora: deixe o rastreador entrar e use noindex, ou exija login.
Como bloquear o ChatGPT, o Claude e os outros rastreadores de IA?
Com um grupo comum para cada um. As empresas de IA publicam tokens de produto exatamente como os buscadores, e a maioria tem vários: um para treinamento, um para responder a uma pergunta com um link de volta e um que busca uma página porque uma pessoa pediu.
Vale a pena separar esses três. Bloquear um rastreador de treinamento mantém suas páginas fora de um modelo; bloquear um rastreador de respostas também tira você das citações que esses produtos mostram. A visão Rastreadores acima traz a finalidade de cada um, o token e o que a documentação do próprio operador diz que ele obedece, para você recusar o treinamento sem sumir das respostas de IA.
Alguns operadores dizem com todas as letras que o rastreador que busca uma página em nome de uma pessoa pode ignorar o robots.txt, porque está agindo por um usuário em vez de rastrear. A tabela marca esses casos. E as linhas Content-Signal da Cloudflare, que cada vez mais sites publicam, são uma declaração sobre o uso que pode ser feito do seu conteúdo, não uma regra de rastreamento: esta página as mantém e as explica, em vez de chamá-las de erro.
GPTBotObedeceOAI-SearchBotObedeceChatGPT-UserPode ignorar
ClaudeBotObedeceClaude-SearchBotObedeceClaude-UserObedece
PerplexityBotObedecePerplexity-UserPode ignorarGoogle-ExtendedSó tokenNão existe esse rastreadorNão existe esse rastreador
Applebot-ExtendedSó tokenNão existe esse rastreadorNão existe esse rastreador
meta-externalagentObedecemeta-webindexerObedecemeta-externalfetcherPode ignorar
AmazonbotObedeceNão existe esse rastreadorAmzn-UserPode ignorar- TreinamentoColeta páginas para treinar um modelo.
- Respostas de IABusca páginas para responder a uma pergunta, em geral com um link de volta para você.
- Pedido de uma pessoaBusca uma página porque alguém pediu. Alguns operadores dizem que este pode ignorar o robots.txt.
Crawl-delay, Clean-param, Host e Content-Signal: quem lê o quê?
O Google lê quatro campos e nenhum outro: user-agent, allow, disallow e sitemap. Todo o resto num robots.txt é lido por outro, ou por ninguém — e uma linha desconhecida nunca é um erro.
O Google lista os quatro campos dele e acrescenta que “outros campos, como crawl-delay, não são compatíveis”. O Bing dá suporte ao Crawl-delay, segundo o blog do próprio Bing: “a diretiva crawl-delay aceita como valores apenas números inteiros positivos”. O Clean-param é do Yandex e de mais ninguém. O Host não está nem no padrão nem na lista do Google.
Nenhuma delas quebra um arquivo. A RFC 9309 exige que a análise de outros registros “NÃO DEVE interferir na análise dos registros definidos explicitamente”, então um rastreador que não conhece uma linha a pula. As duas diretivas que estão mortas de verdade são noindex e nofollow dentro do robots.txt: o Google aposentou o código que lidava com elas em 2019, e hoje elas não fazem nada no Google.

User-agentLêLêLêAllowLêLêLêDisallowLêLêLêSitemapLêLêLêCrawl-delayIgnoraLêNão confirmadoClean-paramIgnoraIgnoraLêHostIgnoraIgnoraNão confirmadonoindexIgnoraNão confirmadoNão confirmadoContent-SignalIgnoraNão confirmadoNão confirmado- O Google aceita quatro campos e diz isso: user-agent, allow, disallow e sitemap.
- O blog do próprio Bing confirma o Crawl-delay. Não publicamos um intervalo nem uma unidade para ele: não foi possível ler a página de ajuda atual do Bing para conferi-los.
- Aposentado pelo Google em 2019, e nunca fez parte do padrão.
- Content Signals Policy da Cloudflare: uma declaração sobre como o conteúdo pode ser usado, não uma regra de rastreamento.
O limite de 500 KiB, e o que passa dele
O Google lê os primeiros 500 kibibytes de um robots.txt e ignora tudo o que vem depois, sem erro em lugar nenhum. A RFC 9309 define 500 KiB como o mínimo para o limite de análise de um rastreador; o Google o declara como teto.
Google: “O Google impõe um limite de tamanho de 500 kibibytes (KiB) ao arquivo robots.txt. O conteúdo que vem depois do tamanho máximo do arquivo é ignorado.” Nada avisa você. Um arquivo de 600 KiB não é inválido — os últimos 100 KiB dele simplesmente não existem para o Googlebot, e um Disallow lá embaixo não protege nada.
Os sites chegam a esse limite mais vezes do que se imagina: uma regra por parâmetro de campanha, por filtro de navegação facetada, por pasta antiga de homologação. A verificação acima mede o arquivo contra o limite e diz quanto passa dele. Troque listas longas por padrões (Disallow: /*?filter=) e coloque as regras que importam no topo.
Disallow: /cart/ · Linha 12ObedecidaDisallow: /private/ · Linha 9.412Nunca lidaO arquivo continua respondendo 200 e continua sendo analisado. Nada, em lugar nenhum, avisa que o resto foi descartado.
Erros comuns no robots.txt, e como encontrá-los
A maioria dos arquivos robots.txt quebrados quebra de um entre seis jeitos, e nenhum deles aparece até que algo teste o arquivo: ele continua respondendo 200, continua sendo analisado sem erro e continua parecendo certo.
O que todo mundo conhece é o Disallow: / esquecido quando um site sai da homologação e entra no ar. Os outros cinco: uma regra que vai mais longe do que você queria, como Disallow: /admin, que também pega /administrator; um Allow: / sob * que um grupo com nome ignora em silêncio; uma linha Sitemap: escrita como caminho em vez de endereço completo; um caminho sem a barra inicial, que não corresponde a nada; e uma linha noindex, que o Google parou de ler em 2019.
Rode a verificação acima e depois leia a visão Problemas: cada problema aparece na própria linha do arquivo, com o que fazer a respeito. Se você está editando o arquivo em vez de auditá-lo, o gerador de robots.txt escreve um arquivo que este mesmo verificador já leu.
Fontes
- RFC 9309, o Robots Exclusion Protocol: grupos, precedência, correspondência com codificação percentual, códigos de status e o mínimo de 500 KiB
- Google Search Central: como o Google interpreta o robots.txt, criar e enviar um arquivo robots.txt e bloquear a indexação com noindex
- Ajuda do Google Search Console: o relatório robots.txt e o relatório de indexação de páginas
- Bing: Crawl-delay e o rastreador do Bing e Yandex: Clean-param
- O analisador de robots.txt de código aberto do Google, o algoritmo de correspondência que o próprio Googlebot usa
- O token, a finalidade e o comportamento diante do robots.txt de cada rastreador vêm da documentação do próprio operador, com o link ao lado dele na visão Rastreadores
Disallow: /Sobra da homologação: o site inteiro, já no ar, fica fechado para todos os rastreadores.Disallow: /adminTambém bloqueia /administrator e /admin-tools. Acrescente a barra no final.Allow: / sob User-agent: *Nunca é lido por um rastreador que tem um grupo próprio em qualquer parte do arquivo.Sitemap: /sitemap.xmlUma linha Sitemap precisa ser um endereço completo, com o host.Disallow: adminUm caminho começa em /. Esta regra não corresponde a nada.noindex: /private/Morto desde 2019. A página continua rastreável e indexável.Verificador de robots.txt: perguntas frequentes
O que aconteceu com o testador de robots.txt do Google?
Por que meu Allow: / sob User-agent: * está sendo ignorado?
* é pulado por inteiro — ele é um plano B, não um acréscimo. Os grupos só são fundidos quando vários deles citam o mesmo token. O Testador de URL acima mostra qual grupo foi escolhido para cada rastreador e por que os outros não foram.O robots.txt impede que uma página seja indexada?
noindex ou um cabeçalho X-Robots-Tag, ou coloque a página atrás de um login.Por que meu noindex não está funcionando?
noindex incluído, então a página pode continuar aparecendo nos resultados de busca por causa de links de outros lugares. O Google diz isso diretamente: para o noindex fazer efeito, a página “não pode estar bloqueada por um arquivo robots.txt”. Remova a linha Disallow e mantenha o noindex.O que significa um 404 no robots.txt? E um 500?
Se um Allow e um Disallow correspondem, qual vence?
Quais curingas funcionam no robots.txt?
* vale por qualquer sequência de caracteres e $ marca o fim da URL. Todo o resto é literal: ?, ., [, ] e + correspondem a si mesmos, e não há expressões regulares. Uma regra sem $ é um prefixo, então Disallow: /admin também pega /administrator. Os caminhos diferenciam maiúsculas de minúsculas; os nomes das diretivas, como Disallow, não.O Google aceita Crawl-delay?
Qual o tamanho máximo de um arquivo robots.txt?
Como bloquear rastreadores de IA como o GPTBot e o ClaudeBot?
Disallow: /, como faria com um buscador. A maioria das empresas de IA tem vários rastreadores com funções diferentes: um para treinamento, um que responde a perguntas com um link de volta para você e um que busca uma única página a pedido de uma pessoa. A visão Rastreadores acima traz cada token, a finalidade e o que o operador diz que ele obedece, para você recusar o treinamento sem perder as citações em IA.Um verificador de robots.txt é o mesmo que um validador?
O robots.txt é um risco de segurança?
Disallow: /admin-backup/ é uma placa apontando exatamente para o que você queria esconder. Nada nele impede o acesso; um rastreador o obedece só porque o operador dele escolheu obedecer. Proteja caminhos privados com autenticação ou com uma regra de firewall, e este verificador vai apontar os caminhos do seu arquivo que soam como um convite.Sentiu falta de algo?Sugira um recurso ou uma nova ferramenta
Mais ferramentas de rastreamento e indexação
Verificador de Sitemap
Encontre e valide o sitemap XML de um site: sintaxe, limites de URLs, datas lastmod, conflitos com o robots.txt e URLs quebradas ou com redirecionamento
Gerador de Sitemap
Rastreie seu site e receba um sitemap XML, um mapa do site HTML e uma árvore visual do site
Verificador de headers HTTP
Analise cabeçalhos de resposta HTTP e classificação de cabeçalhos de segurança
Verificador de Redirecionamento
Verifique redirecionamentos de URL, cadeias de redirecionamento e códigos de status HTTP para SEO
Qual é Meu User Agent
Detecte seu navegador, SO, tipo de dispositivo, motor de renderização e arquitetura da CPU pelo seu user agent
Analisador de Links
Analise todos os links de uma página com detecção dofollow/nofollow e verificação de status HTTP