











Verificador de Sitemap
Cole um domínio ou a URL de um sitemap e receba uma análise de sitemap completa: cada arquivo do índice, cada regra que o protocolo define, as URLs que os buscadores vão recusar e por quê, e se as datas nele significam alguma coisa.
Um domínio basta: lemos o robots.txt e procuramos nos lugares de costume. Um arquivo também serve, como example.com/sitemap.xml.
- robots.txtLido primeiro, e o que ele significa
- Sitemapo robots.txt, depois os caminhos habituais
- Arquivos lidosO índice e dez dos arquivos dele
- ConferidoCada regra, cruzada com o robots.txt
Como verificar um sitemap XML
Digite o seu domínio acima e selecione Verificar sitemap: lemos o robots.txt, encontramos o arquivo que ele cita, lemos esse arquivo e até dez dos arquivos dele e buscamos uma amostra distribuída das URLs; depois mostramos o que um buscador faria com tudo isso.
Você pode informar só o domínio ou o endereço do próprio arquivo. A partir de um domínio, pegamos primeiro as linhas Sitemap: do robots.txt e depois tentamos os caminhos habituais; a partir de um endereço, lemos exatamente o que você informou. Nos dois casos o arquivo inteiro é lido, não as primeiras cem URLs, e com ele até dez arquivos de um índice de sitemaps.
Quatro coisas decidem se um sitemap cumpre o seu papel: o arquivo é analisado sem erro, fica dentro dos limites do protocolo, nada nele contradiz o robots.txt ou o noindex das próprias páginas, e as datas dele significam alguma coisa. As visões acima cobrem as quatro: Arquivos e Problemas para o formato e os limites, robots.txt e Páginas de amostra para as contradições, e URLs para as datas.
200sitemap_index.xml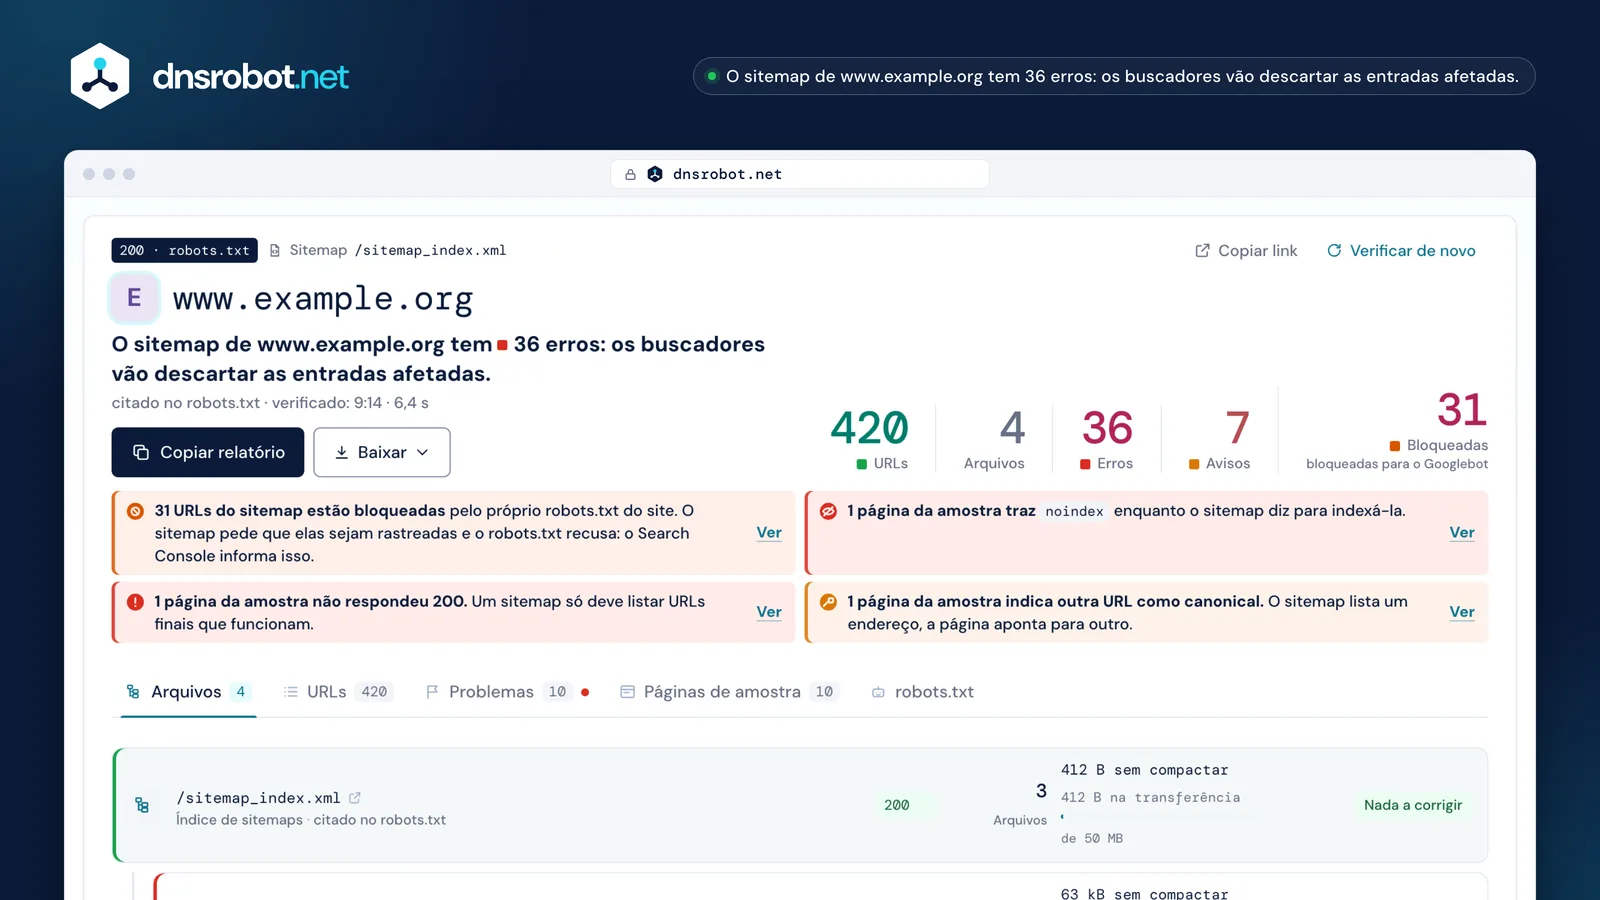
 O vereditoO que está errado neste sitemap numa frase só, com os cinco números que a sustentam: URLs, arquivos, erros, avisos e as URLs que o robots.txt recusa.O robots.txt e a consequência deleNão só o código de status: o que esse status significa para o site inteiro. Um 4xx quer dizer que tudo pode ser rastreado; um 5xx, que nada pode.Cada arquivo do índiceCada arquivo com as URLs que traz, o tamanho descompactado diante do limite de 50 MB, o tamanho da transferência ao lado e os próprios problemas.As contradiçõesURLs que o sitemap pede aos buscadores para rastrear enquanto o robots.txt as recusa, e páginas da amostra que trazem noindex ou indicam outra URL como canonical.
O que torna um sitemap inválido
Um sitemap é inválido quando um analisador não consegue lê-lo: um & solto, um elemento raiz errado, um namespace ausente, uma URL relativa ou espaço em branco impresso antes da declaração XML. Todo o resto é um aviso, não uma recusa.
O mais comum de todos é um & sem escape. O XML lê & como o início de uma referência de caractere, então um único & solto encerra o arquivo para um analisador, e tudo o que vem depois fica sem ler. Escreva-o como &, e escape <, >, " e ' do mesmo jeito (sitemaps.org). Um <loc> precisa ser uma URL completa, que comece pelo protocolo e tenha menos de 2.048 caracteres.
O namespace precisa ser exatamente http://www.sitemaps.org/schemas/sitemap/0.9, com http:// mesmo num site https: é um nome para os analisadores, não um endereço que alguém vá buscar. O arquivo precisa ser UTF-8, e nada, nem mesmo uma linha em branco, pode vir antes de <?xml; uma marca de ordem de bytes UTF-8 é a única coisa permitida ali.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1Uma linha em branco antes da declaração
- 2O namespace precisa ser exatamente esta string, com http://
- 3Um & solto encerra o arquivo para um analisador
- 4Um caminho não é uma URL: ela precisa começar pelo protocolo
- 5A hora precisa de fuso horário; se não, deixe a hora de fora
Erros de sitemap no Search Console e o que cada um significa
O Google Search Console dá a um sitemap um de três status — Processado, Contém erros ou Não foi possível buscar o sitemap —, só para propriedades verificadas, e não diz qual linha está errada. Esta página verifica qualquer sitemap público e aponta a linha.
Não foi possível buscar o sitemap quer dizer que o pedido do Google não voltou com um arquivo legível: um 4xx ou 5xx, uma cadeia de redirecionamentos, um tempo esgotado, um firewall que recusa o Google ou uma regra do robots.txt que bloqueia o caminho do próprio sitemap. Contém erros quer dizer que o arquivo foi lido e algo nele quebrou uma regra — a figura ao lado lista as mensagens que você tem mais chance de ver e a linha por trás de cada uma.
Duas delas falam de tamanho, não de formato: um sitemap que lista mais de 50.000 URLs e um índice de sitemaps que lista mais de 50.000 sitemaps (Google). Divida um sitemap grande demais em arquivos listados num índice; um índice grande demais vira vários índices, cada um enviado separadamente. Um sitemap que lista URLs bloqueadas pelo robots.txt também é apontado, e esse caso é uma contradição entre os seus próprios arquivos, mais do que um erro de formato.
Os três status
As mensagens que você tem mais chance de ver
- Não foi possível buscar o sitemapUm 4xx ou 5xx, uma cadeia de redirecionamentos, um firewall, ou o robots.txt bloqueando o caminho do próprio sitemap.
- URLs em excessoMais de 50.000 URLs num sitemap: um erro, não um aviso. Divida-o sob um índice.
- Erro na análiseMuitas vezes, um & solto dentro de uma URL. Escreva-o &.
- Data inválidaUm lastmod que não é um W3C Datetime, ou uma hora sem fuso horário.
- URL inválidoUm espaço, uma aspa ou outro caractere que uma URL não pode conter, ou um esquema quebrado como htp://.
- O sitemap contém URLs bloqueados pelo arquivo robots.txtOs dois arquivos se contradizem. Decida qual deles está certo.
Só propriedades verificadasO Search Console só informa sobre o sitemap de uma propriedade que é sua. Esta página verifica qualquer sitemap público, e aponta a linha.
O lastmod precisa ser honesto?
Sim. O Google usa o <lastmod> “se ele for consistente e verificavelmente exato”, então uma data que é a mesma em todas as URLs, ou que muda toda vez que o arquivo é escrito, é pior do que nenhuma data — ela ensina o Google a ignorar a tag.
Todos os outros verificadores de sitemap leem o formato de uma data: se é um W3C Datetime, se a hora traz fuso horário. O formato é a metade fácil. O que decide se a tag serve para alguma coisa é se o valor significa o que afirma, e os dois sinais que denunciam isso são uma mesma marca repetida em todas as entradas e uma data que é sempre hoje. O Bing também programa os rastreamentos pelo lastmod e pode desconsiderar datas que são sempre atuais.
Por isso este verificador mostra o que as datas são, não só como estão escritas: quantas entradas trazem uma, a mais antiga e a mais recente, e se são um mesmo valor repetido. Deixar o <lastmod> de fora é válido e não custa nada; inventá-lo custa a credibilidade da tag no site inteiro. Marque a última alteração significativa — o conteúdo principal, os dados estruturados, os links —, não um ano de copyright novo (Google).
Nenhum lastmodVálido. Nada com que programar, e nada de que desconfiar.
50.000 URLs e 50 MB: quando dividir
Um sitemap pode ter no máximo 50.000 URLs e 50 MB sem compactar. Ao passar do primeiro dos dois limites que atingir, divida as URLs em vários arquivos e liste esses arquivos num índice de sitemaps; depois envie o índice.
O limite de tamanho conta o arquivo descompactado, mesmo quando você o serve como .xml.gz, e é por isso que este verificador mostra o tamanho sem compactar com o tamanho da transferência ao lado: um sitemap de 30 KB servido com gzip pode ter 1,6 KB na transferência, e esse número não diz nada sobre o limite. O Naver Search Advisor recusa arquivos com mais de 10 MB, então um site coreano tem um teto mais baixo que o do protocolo.
Um índice pode listar até 50.000 sitemaps, só arquivos do próprio site, e nunca outro índice: um índice aninhado não é lido. As alternativas de idioma escritas com xhtml:link não contam para as 50.000. Este verificador lê o índice e até dez dos arquivos dele numa execução, cada um com a própria contagem, o próprio tamanho e os próprios problemas.
6,2 MBNa transferência812 kBo gzip deixa o arquivo menor para enviar; o limite continua contando o tamanho depois da descompactação.sitemap_index.xmlUm índice não pode citar outro índiceO robots.txt e o seu sitemap: as contradições que custam páginas
O seu sitemap pede aos buscadores que rastreiem uma lista de URLs; o robots.txt diz o que eles não podem rastrear. Quando os dois discordam, o robots.txt vence e a entrada do sitemap é desperdiçada — e o Search Console aponta isso.
O status do próprio robots.txt é a primeira coisa a ler, e quase ninguém diz o que ele significa. Um 4xx é “indisponível”: não há regras, então tudo pode ser rastreado. Um 5xx, ou nenhuma resposta, é “inacessível”, e um rastreador que segue a RFC 9309 não pode então rastrear nada no site; o Google lê um 429 do mesmo jeito. O mesmo arquivo quebrado produz resultados opostos, e uma ferramenta que mostra “nenhuma URL bloqueada” sobre um robots.txt ilegível erra sempre que o arquivo respondeu 5xx ou 429, ou não respondeu.
Depois vêm as contradições dentro de um arquivo que funciona: URLs que o sitemap lista e o robots.txt bloqueia, e — fácil de deixar passar — o caminho do próprio sitemap bloqueado, o que publica um arquivo que nenhum rastreador pode ler. A outra direção é barata e vale a pena: uma linha Sitemap: no robots.txt não exige conta em lugar nenhum, e todo rastreador a lê.
O status e a consequência dele
A contradição
/search/?q=pepperDisallow: /search/A entrada não faz nada, e o Search Console aponta isso
E o caminho do próprio sitemap, bloqueado: um arquivo publicado que nenhum rastreador pode ler.
Quais URLs não devem estar num sitemap
Só as URLs canônicas que você quer ver nos resultados de busca, uma por página: endereços finais que respondem 200, são indexáveis e não estão bloqueados pelo robots.txt. Redirecionamentos, páginas com noindex, URLs cuja canonical aponta para outro lugar, erros e variantes com parâmetros ficam de fora.
Um sitemap que lista uma URL que redireciona manda o rastreador um salto além do necessário, e o Google pede a URL em que o redirecionamento termina no lugar dela. Uma página com noindex num sitemap é uma contradição direta: o arquivo diz “indexe isto”, a página diz “não indexe”. A página vence, e a entrada não faz nada.
Nada disso é fatal — cada URL de um sitemap é uma sugestão, e quem decide o que indexar continua sendo o Google —, mas cada entrada errada é uma que um buscador aprende a descontar. É por isso que este verificador busca uma amostra distribuída das URLs em vez de só analisar o arquivo: a análise do arquivo não consegue dizer que uma página listada agora responde 404.
/shop/raised-beds/VálidaIndexada como listada/shop/raised-bed/Redirecionamentodesperdiçada/shop/?sort=priceCanonical em outra URLdesperdiçada/tags/autumn/noindexdesperdiçada/shop/old-kit/404desperdiçada/search/?q=pepperBloqueadadesperdiçadaEntradas de imagem, vídeo e hreflang
Uma entrada <url> pode trazer mais que um endereço: as imagens da página, as versões dela em outros idiomas e metadados de vídeo ou de notícias, cada um no próprio namespace, dentro dessa entrada.
As imagens usam o namespace de imagens do Google, até 1.000 por página; só <image:image> e <image:loc> ainda contam, e caption, title, license e geo_location foram aposentados em 2022. Este verificador conta as entradas de imagem que encontra e as mostra por URL.
As versões de idioma usam xhtml:link com um código hreflang: um idioma ISO 639-1 com uma região ISO 3166-1 opcional, nunca só a região. Cada versão de uma página precisa listar todas as outras, ela mesma incluída, senão o Google ignora o conjunto. As alternativas não contam para o limite de 50.000 URLs, então listar doze versões de idioma em cada entrada não multiplica a contagem por doze.
https://www.example.org/guides/raised-beds/2026-09-143até 1.000 por páginaen · de · frcada versão lista todas as versões, ela mesma incluídaAs alternativas não contam para as 50.000
Com que frequência os buscadores leem o seu sitemap?
O Google lê um sitemap no próprio ritmo, que não publica: enviar um é uma sugestão, não uma ordem. O Bing lê um sitemap assim que o encontra e depois, em geral, pelo menos uma vez por dia. Nenhum dos dois relê um arquivo com mais frequência porque você pediu.
Os antigos pings anônimos acabaram: o Bing desligou o bing.com/ping em 13 de maio de 2022 e o Google anunciou em junho de 2023 que o ping dele ia parar de funcionar; hoje ele responde 404. Uma ferramenta que ainda oferece “fazer ping no Google” não faz absolutamente nada.
O que de fato antecipa o próximo rastreamento de uma página alterada é um lastmod exato, que é justamente o motivo de a honestidade da tag importar, e o IndexNow para URLs alteradas uma a uma — um envio só chega ao Bing, ao Yandex, ao Naver, ao Seznam e a outros, mas não ao Google. Reenviar à mão um sitemap que não mudou não adianta nada.
Um lastmod exato antecipa o próximo rastreamento de uma página alterada
Você precisa mesmo de um sitemap?
Um site pequeno cujas páginas se linkam todas entre si pode não precisar: o Google situa o número em cerca de 500 páginas ou menos. Sites grandes, sites novos com poucos links de fora e sites com muitas imagens ou vídeos são os que mais ganham.
O próprio guia de SEO para iniciantes do Google chama o sitemap de opcional, e enviá-lo é uma sugestão, não uma instrução: ele não faz uma página ranquear e não garante a indexação. O que ele faz é garantir que um rastreador saiba que uma URL existe, o que importa mais nas páginas que os seus próprios links não alcançam.
Se você tem um, vale a pena que ele esteja certo. Um sitemap cheio de redirecionamentos, páginas com noindex e URLs bloqueadas pelo robots.txt não é neutro — é uma lista em que um buscador aprende a confiar menos. Verificá-lo leva um minuto; criar um novo a partir do seu próprio site leva um rastreamento.
Fontes
- Protocolo do sitemaps.org e as perguntas frequentes dele: o formato, as tags obrigatórias e opcionais, os limites de 50.000 / 50 MB, o índice e a regra do local
- Google Search Central: criar um sitemap, sitemaps grandes, o relatório de sitemaps e os erros dele, versões localizadas e o lastmod e o ping aposentado
- Bing: a tag lastmod (2023), sitemaps na busca com IA (2025) e o ping removido (2022)
- RFC 9309, o padrão do robots.txt: o que um 4xx e um 5xx significam para um rastreador
- Naver Search Advisor: feeds e IndexNow
- sites grandes
- sites novos com poucos links de fora
- muitas imagens ou vídeos
- páginas que nenhum link interno alcança
Perguntas frequentes sobre o verificador de sitemap
Como verificar se o meu sitemap XML é válido?
Quais são os erros de sitemap mais comuns?
Por que o Search Console diz “Não foi possível buscar o sitemap”?
É um problema se uma URL do meu sitemap estiver bloqueada no robots.txt?
O lastmod precisa ser exato?
Quantas URLs um sitemap pode ter?
O Google usa priority e changefreq?
Este verificador de sitemap é grátis? Tem limite de URLs?
Qual a diferença entre esta página e o Google Search Console?
O que é um índice de sitemaps, e ele pode citar outro índice?
O meu sitemap precisa estar no robots.txt?
Um sitemap vai fazer as minhas páginas serem indexadas?
Sentiu falta de algo?Sugira um recurso ou uma nova ferramenta
Mais ferramentas de rastreamento e SEO
Verificador de Robots.txt
Busque o robots.txt de qualquer site, teste se uma URL está bloqueada para o Googlebot ou crawlers de IA e encontre erros de sintaxe
Gerador de Sitemap
Rastreie seu site e receba um sitemap XML, um mapa do site HTML e uma árvore visual do site
Analisador de Links
Analise todos os links de uma página com detecção dofollow/nofollow e verificação de status HTTP
Verificador de Redirecionamento
Verifique redirecionamentos de URL, cadeias de redirecionamento e códigos de status HTTP para SEO
Verificador de headers HTTP
Analise cabeçalhos de resposta HTTP e classificação de cabeçalhos de segurança
Verificador de Site Fora do Ar
Está fora do ar para todos ou só para você? Verifique qualquer site de 11 lugares e da sua conexão, com uma captura de tela ao vivo
Detector de CMS
Qual CMS, tema, plugins e tecnologias um site usa, com a prova de cada um