











Comprobador de Sitemap
Para comprobar su sitemap, pegue un dominio o la URL de su sitemap.xml o sitemap_index.xml y obtenga el panorama completo: cada archivo del índice, cada regla que fija el protocolo, las URL que los motores de búsqueda rechazarán y por qué, y si las fechas significan algo.
Basta con un dominio: leemos robots.txt y buscamos en los lugares habituales. También sirve un archivo, como example.com/sitemap.xml.
- robots.txtSe lee primero, y qué significa
- Sitemaprobots.txt, y después las rutas habituales
- Archivos leídosEl índice y diez de sus archivos
- RevisiónCada regla, frente a robots.txt
Cómo comprobar su sitemap.xml
Escriba su dominio arriba y seleccione Comprobar sitemap: leemos robots.txt, encontramos el archivo que nombra, lo leemos junto con hasta diez de sus archivos y obtenemos una muestra repartida de sus URL; después le mostramos qué haría un motor de búsqueda con todo ello.
Puede indicar un dominio sin más o la dirección del propio archivo. A partir de un dominio tomamos primero las líneas Sitemap: de robots.txt y después probamos las rutas habituales; a partir de una dirección leemos exactamente lo que indicó. En los dos casos se lee el archivo completo, no las primeras cien URL, y con él hasta diez archivos de un índice de sitemaps.
Cuatro cosas deciden si un sitemap cumple su función: el archivo se analiza sin errores, se mantiene dentro de los límites del protocolo, nada en él contradice robots.txt ni el noindex de las propias páginas, y sus fechas significan algo. Las vistas de arriba las cubren: Archivos y Problemas para el formato y los límites, robots.txt y Páginas de muestra para las contradicciones, y URL para las fechas.
200sitemap_index.xml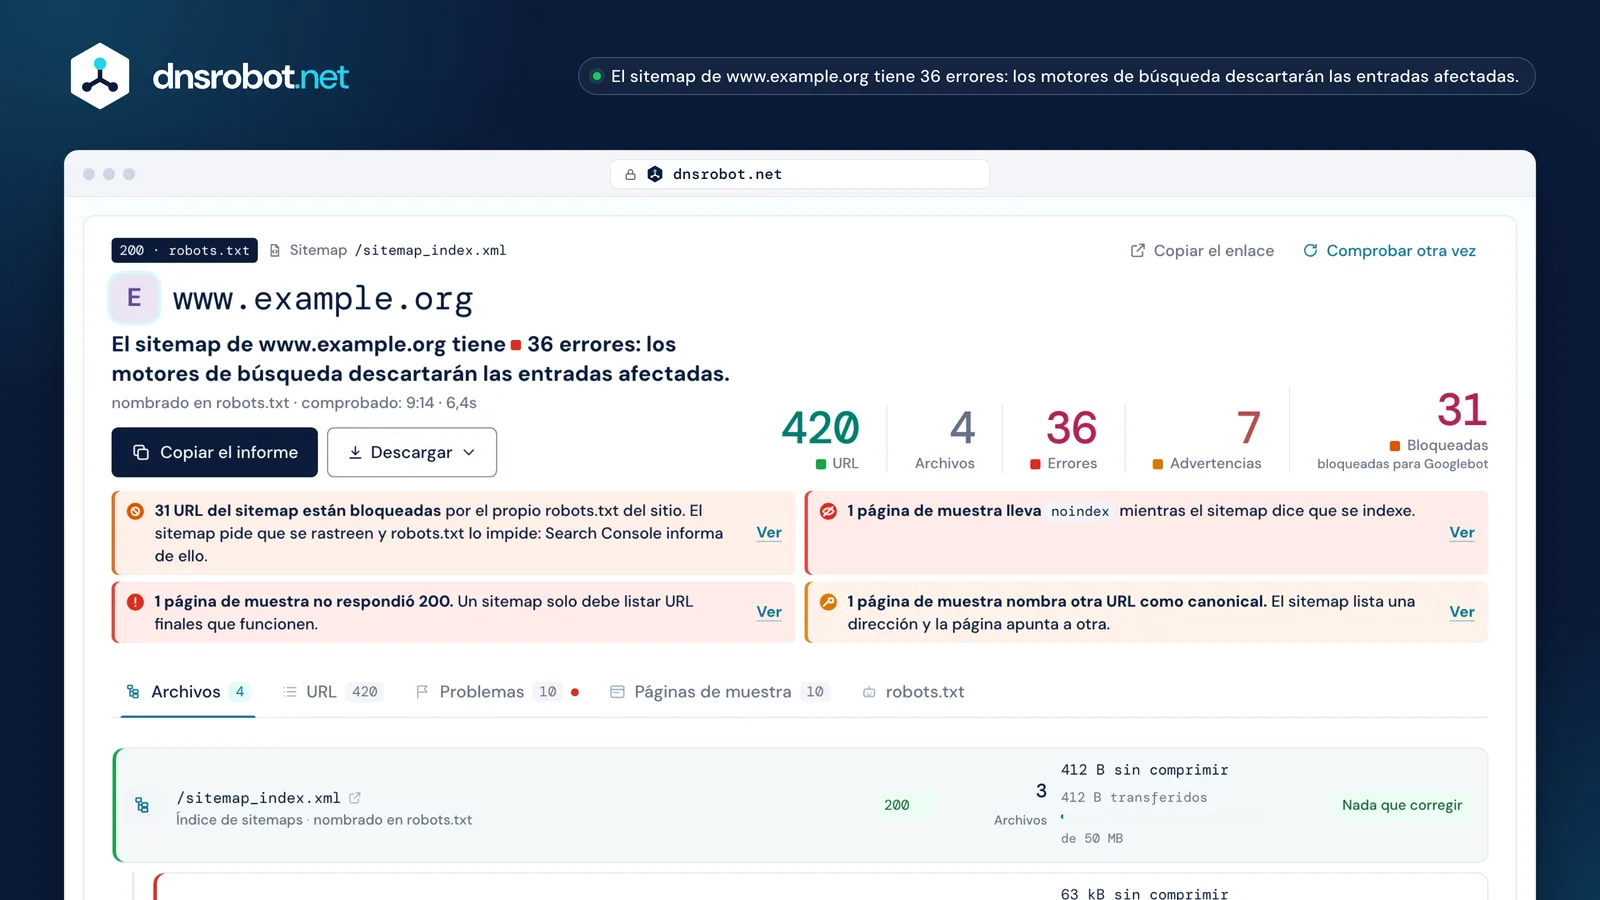
 El veredictoQué falla en este sitemap en una sola frase, con las cinco cifras que lo sostienen: URL, archivos, errores, advertencias y las URL que robots.txt rechaza.robots.txt y su consecuenciaNo solo el código de estado: lo que ese estado significa para todo el sitio. Un 4xx significa que se puede rastrear todo; un 5xx, que no se puede rastrear nada.Cada archivo del índiceCada archivo con las URL que contiene, su tamaño descomprimido frente al límite de 50 MB, el tamaño transferido al lado y sus propios hallazgos.Las contradiccionesURL que el sitemap pide rastrear mientras robots.txt las rechaza, y páginas de muestra que llevan noindex o nombran otra URL como canonical.
Qué hace que un sitemap no sea válido
Un sitemap no es válido cuando un analizador no puede leerlo: un & suelto, un elemento raíz incorrecto, un espacio de nombres que falta, una URL relativa o espacio en blanco impreso antes de la declaración XML. Todo lo demás es una advertencia, no un rechazo.
El más común de todos es un ampersand sin escapar. XML lee & como el inicio de una referencia de carácter, así que uno solo, suelto, termina el archivo para un analizador, y todo lo que viene después queda sin leer. Escríbalo &, y escape del mismo modo <, >, " y ' (sitemaps.org). Un <loc> debe ser una URL completa que empiece por el protocolo y tenga menos de 2048 caracteres.
El espacio de nombres debe ser exactamente http://www.sitemaps.org/schemas/sitemap/0.9, con http:// incluso en un sitio https: es un nombre para los analizadores, no una dirección que alguien vaya a pedir. El archivo debe estar en UTF-8, y nada, ni siquiera una línea en blanco, puede ir antes de <?xml; una marca de orden de bytes UTF-8 es lo único que se permite ahí.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1Una línea en blanco antes de la declaración
- 2El espacio de nombres debe ser exactamente esta cadena, con http://
- 3Un & suelto termina el archivo para un analizador
- 4Una ruta no es una URL: debe empezar por el protocolo
- 5Una hora necesita zona horaria; si no, quite la hora
Errores de sitemap en Search Console y qué significa cada uno
Google Search Console da a un sitemap uno de tres estados —Correcto, Tiene errores o No se ha podido obtener—, solo para propiedades verificadas, y no le dice qué línea está mal. Esta página comprueba cualquier sitemap público y nombra la línea.
No se ha podido obtener significa que la solicitud de Google no volvió con un archivo legible: un 4xx o un 5xx, una cadena de redirecciones, un tiempo de espera agotado, un firewall que rechaza a Google o una regla de robots.txt que bloquea la ruta del propio sitemap. Tiene errores significa que el archivo se leyó y algo en él incumplió una regla: la figura de al lado lista los mensajes que es más probable que vea y la línea que hay detrás de cada uno.
Dos de ellos tienen que ver con el tamaño y no con el formato: un sitemap que lista más de 50 000 URL y un índice de sitemaps que lista más de 50 000 sitemaps (Google). Divida un sitemap demasiado grande en archivos listados en un índice; un índice demasiado grande se convierte en varios índices, cada uno enviado por separado. También se informa de un sitemap que lista URL bloqueadas por robots.txt, y esa es una contradicción entre sus propios archivos más que un error de formato.
Los tres estados
Los mensajes que es más probable que vea
- No se ha podido obtenerUn 4xx o un 5xx, una cadena de redirecciones, un firewall, o robots.txt que bloquea la ruta del propio sitemap.
- Hay demasiadas URLsMás de 50 000 URL en un sitemap: un error, no una advertencia. Divídalo bajo un índice.
- Error de análisisA menudo, un & suelto dentro de una URL. Escríbalo &.
- Fecha incorrectaUn lastmod que no es un W3C Datetime, o una hora sin zona horaria.
- URL no válidaUn espacio, unas comillas u otro carácter que una URL no puede contener, o un esquema roto como htp://.
- El sitemap incluye URLs que el archivo robots.txt ha bloqueadoLos dos archivos se contradicen. Decida cuál tiene razón.
Solo propiedades verificadasSearch Console informa de un sitemap solo para una propiedad suya. Esta página comprueba cualquier sitemap público y nombra la línea.
¿lastmod tiene que ser honesto?
Sí. Google usa <lastmod> “si es coherente y verificablemente exacto”, así que una fecha que es la misma en todas las URL, o que cambia cada vez que se escribe el archivo, es peor que no tener fecha: le enseña a Google a ignorar la etiqueta.
Todos los demás comprobadores de sitemaps leen el formato de una fecha: si es un W3C Datetime, si la hora lleva zona horaria. El formato es la mitad fácil. Lo que decide si la etiqueta sirve de algo es si el valor significa lo que dice, y las dos señales que lo delatan son una misma marca repetida en todas las entradas y una fecha que siempre es hoy. Bing también programa sus rastreos con lastmod y puede desatender las fechas que siempre son actuales.
Por eso este comprobador informa de lo que son las fechas, no solo de cómo están escritas: cuántas entradas llevan una, la más antigua y la más reciente, y si son un mismo valor repetido. Dejar fuera <lastmod> es válido y no cuesta nada; inventarlo le cuesta a la etiqueta su credibilidad en todo el sitio. Marque el último cambio importante —el contenido principal, los datos estructurados, los enlaces—, no un año nuevo de copyright (Google).
Ningún lastmodVálido. Nada con qué programar, y nada de qué desconfiar.
50 000 URL y 50 MB: cuándo dividirlo con un sitemap_index.xml
Un sitemap admite como máximo 50 000 URL y 50 MB sin comprimir. Al pasar el primero de los dos límites que alcance, reparta las URL en varios archivos y lístelos en un índice de sitemaps; después envíe el índice.
El límite de tamaño cuenta el archivo descomprimido, aunque lo sirva como .xml.gz, y por eso este comprobador muestra el tamaño sin comprimir con el tamaño transferido al lado: un sitemap de 30 KB servido con gzip puede ocupar 1,6 KB en la transferencia, y esa cifra no dice nada del límite. Naver Search Advisor rechaza los archivos de más de 10 MB, así que un sitio coreano tiene un techo más bajo que el del protocolo.
Un índice puede listar hasta 50 000 sitemaps, solo archivos de su propio sitio, y nunca otro índice: un índice anidado no se lee. Las alternativas de idioma escritas con xhtml:link no cuentan para las 50 000. Este comprobador lee el índice y hasta diez de sus archivos en una sola ejecución, cada uno con su propio recuento, tamaño y hallazgos.
6,2 MBEn la transferencia812 kBgzip hace que el archivo ocupe menos al enviarlo; el límite sigue contando el tamaño después de descomprimir.sitemap_index.xmlUn índice no puede nombrar otro índicerobots.txt y su sitemap: las contradicciones que le cuestan páginas
Su sitemap pide a los motores de búsqueda que rastreen una lista de URL; robots.txt les dice qué no pueden rastrear. Cuando los dos no coinciden, gana robots.txt y la entrada del sitemap se desperdicia, y Search Console informa de ello.
Lo primero que hay que leer es el estado del propio robots.txt, y casi nadie dice lo que significa. Un 4xx es “no disponible”: no hay reglas, así que se puede rastrear todo. Un 5xx, o ninguna respuesta, es “inaccesible”, y un rastreador que sigue RFC 9309 no debe rastrear entonces nada en el sitio; Google interpreta un 429 del mismo modo. El mismo archivo roto produce resultados opuestos, y una herramienta que muestra “no se bloquea ninguna URL” sobre un robots.txt que no se puede leer se equivoca cada vez que el archivo respondió 5xx o 429, o no respondió.
Después vienen las contradicciones dentro de un archivo que funciona: URL que el sitemap lista y robots.txt bloquea, y —fácil de pasar por alto— la ruta del propio sitemap bloqueada, que publica un archivo que ningún rastreador puede leer. La otra dirección es barata y vale la pena: una línea Sitemap: en robots.txt no necesita ninguna cuenta y todos los rastreadores la leen.
El estado y su consecuencia
La contradicción
/search/?q=pepperDisallow: /search/La entrada no sirve de nada, y Search Console informa de ello
Y la ruta del propio sitemap, bloqueada: un archivo publicado que ningún rastreador puede leer.
Qué URL no deben ir en un sitemap
Solo las URL canonical que usted quiere ver en los resultados de búsqueda, una por página: direcciones finales que responden 200, son indexables y no están bloqueadas por robots.txt. Las redirecciones, las páginas con noindex, las URL cuya canonical apunta a otra parte, los errores y las variantes con parámetros no tienen lugar en él.
Un sitemap que lista una URL que redirige manda a un rastreador un salto más lejos de lo necesario, y Google pide la URL a la que llega la redirección en su lugar. Una página con noindex en un sitemap es una contradicción directa: el archivo dice “indexa esto” y la página dice “no lo hagas”. Gana la página, y la entrada no sirve de nada.
Nada de esto es grave —cada URL de un sitemap es una sugerencia, y Google sigue decidiendo qué indexa—, pero cada entrada equivocada es una que un motor de búsqueda aprende a descontar. Por eso este comprobador obtiene una muestra repartida de las URL en lugar de solo analizar el archivo: analizarlo no puede decirle que una página listada ahora responde 404.
/shop/raised-beds/VálidaIndexada tal como se lista/shop/raised-bed/Redireccióndesperdiciada/shop/?sort=priceCanonical a otra URLdesperdiciada/tags/autumn/noindexdesperdiciada/shop/old-kit/404desperdiciada/search/?q=pepperBloqueadadesperdiciadaEntradas de imagen, de vídeo y de hreflang
Una entrada <url> puede llevar más que una dirección: las imágenes de la página, sus versiones en otros idiomas y metadatos de vídeo o de noticias, cada uno en su propio espacio de nombres dentro de esa entrada.
Las imágenes usan el espacio de nombres de imágenes de Google, hasta 1000 por página; solo <image:image> y <image:loc> siguen contando, y caption, title, license y geo_location se retiraron en 2022. Este comprobador cuenta las entradas de imagen que encuentra y las muestra por URL.
Las versiones de idioma usan xhtml:link con un código hreflang: un idioma ISO 639-1 con una región ISO 3166-1 opcional, nunca una región sola. Cada versión de una página debe listar todas las demás, ella incluida, o Google ignora el conjunto. Las alternativas no cuentan para el límite de 50 000 URL, así que listar doce versiones de idioma en cada entrada no multiplica el recuento por doce.
https://www.example.org/guides/raised-beds/2026-09-143hasta 1000 por páginaen · de · frcada versión lista todas las versiones, ella incluidaLas alternativas no cuentan para las 50 000
¿Con qué frecuencia leen su sitemap los motores de búsqueda?
Google lee un sitemap según su propio calendario, que no publica: enviarlo es una sugerencia, no una orden. Bing lo lee en cuanto lo encuentra y después, normalmente, al menos una vez al día. Ninguno de los dos vuelve a leer un archivo más a menudo porque usted se lo pida.
Los viejos pings anónimos ya no existen: Bing desactivó bing.com/ping el 13 de mayo de 2022 y Google anunció en junio de 2023 que su ping dejaría de funcionar; hoy responde 404. Una herramienta que todavía ofrece “avisar a Google con un ping” no hace nada en absoluto.
Lo que sí adelanta el siguiente rastreo de una página modificada es un lastmod exacto, que es justo por lo que importa que la etiqueta sea honesta, e IndexNow para las URL modificadas una a una: un solo envío llega a Bing, Yandex, Naver, Seznam y otros, aunque no a Google. Volver a enviar a mano un sitemap que no ha cambiado no consigue nada.
Un lastmod exacto adelanta el siguiente rastreo de una página modificada
¿De verdad necesita un sitemap?
Un sitio pequeño cuyas páginas se enlazan todas entre sí puede no necesitarlo: Google sitúa la cifra en unas 500 páginas o menos. Los sitios grandes, los nuevos con pocos enlaces desde otros sitios y los que tienen muchas imágenes o vídeos son los que más ganan.
La propia guía de iniciación de Google llama opcional al sitemap, y enviarlo es una sugerencia, no una instrucción: no hace que una página posicione ni garantiza su indexación. Lo que sí hace es asegurarse de que un rastreador sepa que una URL existe, lo que importa sobre todo en las páginas a las que no llegan sus propios enlaces.
Si tiene uno, vale la pena que esté bien. Un sitemap lleno de redirecciones, páginas con noindex y URL bloqueadas por robots.txt no es neutral: es una lista en la que un motor de búsqueda aprende a confiar menos. Comprobarlo cuesta un minuto; crear uno nuevo a partir de su propio sitio cuesta un rastreo.
Fuentes
- Protocolo de sitemaps.org y sus preguntas frecuentes: el formato, las etiquetas obligatorias y opcionales, los límites de 50 000 / 50 MB, el índice y la regla de la ubicación
- Google Search Central: crear un sitemap, sitemaps grandes, el informe Sitemaps y sus errores, versiones localizadas y lastmod y el ping retirado
- Bing: la etiqueta lastmod (2023), los sitemaps en la búsqueda con IA (2025) y el ping eliminado (2022)
- RFC 9309, el estándar de robots.txt: qué significan un 4xx y un 5xx para un rastreador
- Naver Search Advisor: feeds e IndexNow
- sitios grandes
- sitios nuevos con pocos enlaces desde otros sitios
- muchas imágenes o vídeos
- páginas a las que no llega ningún enlace interno
Preguntas frecuentes sobre el comprobador de sitemap
¿Cómo compruebo si mi sitemap.xml es válido?
¿Cuáles son los errores de sitemap más comunes?
¿Por qué Search Console dice “No se ha podido obtener”?
¿Es un problema que una URL de mi sitemap esté bloqueada en robots.txt?
¿lastmod tiene que ser exacto?
¿Cuántas URL puede tener un sitemap?
¿Google usa priority y changefreq?
¿Este comprobador de sitemap es gratis? ¿Tiene un límite de URL?
¿En qué se diferencia de Google Search Console?
¿Qué es un índice de sitemaps (sitemap_index.xml) y puede nombrar otro índice?
¿Mi sitemap tiene que estar en robots.txt?
¿Un sitemap hará que mis páginas se indexen?
¿Le falta algo?Sugiera una función o una herramienta nueva
Más herramientas de rastreo y SEO
Comprobador de Robots.txt
Obtenga el robots.txt de cualquier sitio, compruebe si una URL está bloqueada para Googlebot o crawlers de IA y encuentre errores de sintaxis
Generador de Sitemap
Rastrea tu sitio web y obtén un sitemap XML, un mapa del sitio HTML y un árbol visual del sitio
Analizador de Enlaces
Analiza todos los enlaces de una página con detección dofollow/nofollow y verificación de estado HTTP
Verificador de Redirecciones
Verifica redirecciones de URL, cadenas de redirección y códigos de estado HTTP para SEO
Verificador de encabezados HTTP
Analiza cabeceras de respuesta HTTP y clasificación de cabeceras de seguridad
Comprobador de Páginas Caídas
¿La página está caída para todos o solo para usted? Compruebe cualquier web desde 11 lugares y desde su conexión, con una captura en vivo
Detector de CMS
Qué CMS, tema, plugins y tecnologías usa una web, con la prueba de cada uno