Todos los demás rastreadores
User-agent: *
Lo leen todos los rastreadores que no tienen un grupo propio.
- Permite todo el sitio.
Google lo ignora; Bing lo lee.
Tema
Un generador de robots.txt para crear robots.txt con confianza: cada regla se explica mientras la escribe, nuestro comprobador de robots.txt relee el archivo según RFC 9309 y la propia interpretación de Google, y antes de publicar obtiene un veredicto en vivo para cualquier rastreador y cualquier ruta.
Un archivo por host y protocolo: www.example.com y example.com necesitan uno cada uno.
Fuente: RFC 9309, consultado el 26 de octubre de 2026.
Lo leen todos los rastreadores que no tienen un grupo propio.
Elija qué recibe cada rastreador conocido. Un rastreador con un grupo propio lee solo ese grupo.
Rastrean para crear un índice de búsqueda. Las páginas bloqueadas aún pueden aparecer gracias a enlaces de otros sitios, pero sin que se lea nada de ellas.
Recopilan páginas para entrenar modelos. Un token aparte le permite rechazar el entrenamiento y seguir apareciendo en los resultados de búsqueda.
Obtienen páginas para responder preguntas con un enlace a su sitio.
Obtienen una página porque una persona la pidió, así que algunos operadores dicen que pueden ignorar robots.txt.
Rechazarlos es rechazar a una persona, no un rastreo: cuando alguien le pide a un asistente de IA que abra una de sus páginas, un asistente que obedece el archivo no la leerá por esa persona. Si lo que quiere rechazar es el entrenamiento, rechace los rastreadores de entrenamiento de arriba.
Vistas previas de enlaces, herramientas del propietario, comprobaciones publicitarias, archivos web y rastreadores cuyos operadores declaran otra tarea o ninguna.
Su robots.txt/robots.txt
User-agent: *Allow: /ErrorAdvertenciaNota23 B de 500 KiB
1 advertencia
Qué hacer Es la línea más barata del archivo y todos los rastreadores la leen. Añada Sitemap: con la dirección completa de su sitemap.
Elija un rastreador y una ruta: el veredicto, la regla que lo decide y el grupo que lee el rastreador salen del propio comparador del Comprobador de Robots.txt.
Este rastreador puede solicitar la URL.
User-agent: *empieza en la línea 1
Ningún grupo nombra a este rastreador, así que se aplica el grupo *.
Allow: /línea 2
/any-page
/
Solo se comparan la ruta y la consulta, byte a byte tras la codificación porcentual. El host, el esquema y el fragmento nunca forman parte de una regla.
Escriba las reglas, guárdelas en un archivo de texto plano llamado robots.txt, codificado en UTF-8, y súbalo al nivel superior de su sitio, para que responda en https://example.com/robots.txt. No hay nada que enviar: los rastreadores piden esa dirección por su cuenta.
Google lo resume en tres frases: “El archivo debe llamarse robots.txt. Solo puede haber un archivo robots.txt por sitio. El archivo robots.txt debe incluirse en la raíz del host del sitio web al que se aplica”. Los archivos “deben estar codificados en UTF-8, que incluye ASCII”, y “los rastreadores de Google buscarán y empezarán a usar el archivo robots.txt automáticamente”.
El generador de arriba parte de un preajuste, explica cada regla mientras la escribe y relee el resultado con el analizador y el comparador de nuestro comprobador de robots.txt antes de que lo copie. La descarga se llama robots.txt: UTF-8 sin marca de orden de bytes, solo saltos de línea LF y ninguna fecha ni comentario que usted no haya pedido.
https://example.com/robots.txtNo hay paso de envío: los rastreadores de Google encuentran el archivo por su cuenta.
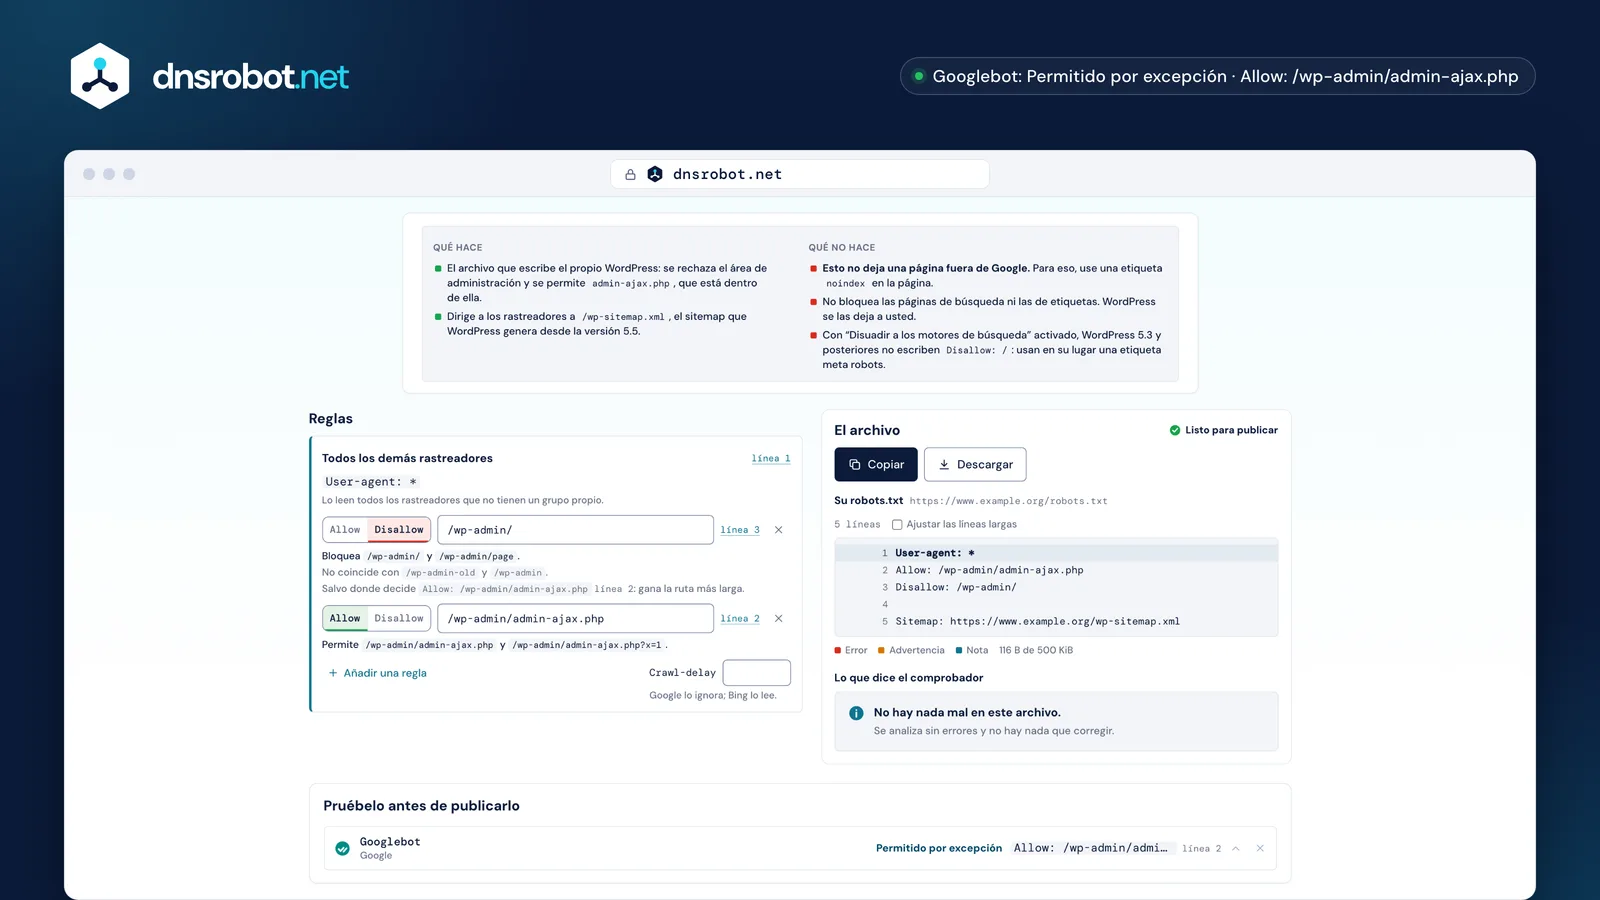
 Qué hace el preajusteY lo que no hace: ninguno de estos preajustes deja una página fuera de Google, y cada uno lo dice.Cada regla explicadaLas rutas que bloquea una regla y las que se le escapan, desde el mismo comparador que decide cada veredicto, y la regla más larga que abre una excepción.El archivo y sus hallazgosEl archivo con sus números de línea, releído por la propia auditoría del Comprobador de Robots.txt antes de que usted lo copie.El veredictoElija un rastreador y una ruta: permitido o bloqueado, la regla que lo decidió con su línea y el grupo que lee el rastreador.
Grupos y líneas Sitemap. Un grupo empieza con una o más líneas User-agent que nombran rastreadores, seguidas de las reglas Allow y Disallow que esos rastreadores obedecen; una línea Sitemap va sola, fuera de todos los grupos.
RFC 9309 define un grupo como “una o más líneas user-agent seguidas de una o más reglas”, y un rastreador obedece exactamente un grupo: el que nombra su propio token de producto, o el grupo * cuando ninguno lo hace. Google lee cuatro campos y ninguno más: user-agent, allow, disallow y sitemap.
Los nombres de los campos no distinguen mayúsculas de minúsculas, pero las rutas sí: en el propio ejemplo de Google, disallow: /file.asp se aplica a /file.asp “pero no” a /FILE.asp. Una línea Sitemap: debe ser una dirección completa con el protocolo y el host; este generador rechaza cualquier otra forma y dice por qué.
User-agent: *Empieza un grupo para cada rastreador sin grupo propioDisallow: /cart/Una ruta que estos rastreadores no deben obtenerAllow: /cart/helpUna excepción: más larga que el Disallow, así que gana User-agent: GPTBotEmpieza un grupo que nombra a dos rastreadoresUser-agent: ClaudeBotDisallow: /A los dos se les rechaza todo el sitio Sitemap: https://www.example.org/sitemap.xmlFuera de todos los grupos: una dirección completa* y $: cómo coincide una reglaCuando varias reglas coinciden con una URL, gana la de la ruta más larga, sea del tipo que sea, y en un empate gana Allow. * representa cualquier secuencia de caracteres y $ marca el final de la URL; nada más en una ruta tiene un significado especial.
RFC 9309: “Se DEBE usar la coincidencia más específica que se encuentre. La coincidencia más específica es la que tiene más octetos”, y “si una regla allow y una regla disallow son equivalentes, DEBERÍA usarse la regla allow”. El propio archivo de WordPress funciona así: Disallow: /wp-admin/ cierra la carpeta, y el Allow: /wp-admin/admin-ajax.php, más largo, abre un archivo dentro de ella.
Una regla sin $ es un prefijo, así que Disallow: /admin también bloquea /administrator; añada la barra (/admin/) cuando se refiera a la carpeta. Bajo cada regla, el editor de arriba muestra las rutas que atrapa y algunas que no, desde el comparador que decide cada veredicto, y señala una regla a la que otra siempre le gana.
* y $, y lo que atrapa de verdad cada patrón/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ y + son caracteres normales. En robots.txt no hay expresiones regulares.
/admin/report.pdfGana el Allow: coincide con una parte mayor de la ruta.
Disallow: /files/7 caracteresAllow: /files/7 caracteresMisma longitud, así que gana el Allow. “La regla menos restrictiva”, como dice Google.
Las tres plataformas ya sirven uno, y los preajustes de arriba escriben lo que describe la propia documentación de cada una: WordPress rechaza su área de administración pero permite admin-ajax.php, Shopify rechaza los carritos, los pagos y las colecciones filtradas u ordenadas, y Next.js sirve el archivo que usted pone en app/robots.txt.
WordPress escribe su archivo en código, en do_robots(): User-agent: *, un Disallow para la ruta de administración y un Allow para admin-ajax.php, más, en un sitio público desde WordPress 5.5, una línea Sitemap: para /wp-sitemap.xml. Con “Disuadir a los motores de búsqueda” activado, WordPress 5.3 y posteriores ya no escriben Disallow: /; usan en su lugar una etiqueta meta robots.
Shopify dice que su archivo predeterminado “funciona para la mayoría de las tiendas”. No hay archivo que subir: cambiarlo significa editar la plantilla robots.txt.liquid del tema, algo que Shopify llama “una personalización no admitida”. Next.js sirve app/robots.txt tal como está escrito, o genera el archivo a partir de app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlLo escribe el propio WordPress. Se cambia con un plugin o con el filtro robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlEl predeterminado de Shopify. Se cambia en la plantilla robots.txt.liquid del tema.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlSu propio archivo en app/robots.txt, o app/robots.ts, servido en /robots.txt.
Un grupo que nombra al rastreador, con Disallow: / debajo, funciona con cada rastreador cuyo operador dice que obedece robots.txt, y solo con esos. Es una petición que el rastreador respeta, no un candado: un rastreador que ignora el archivo puede seguir obteniendo todas las páginas.
La mayoría de las empresas de IA usan más de un rastreador, así que decida según la tarea. Rechazar un rastreador de entrenamiento como GPTBot o ClaudeBot rechaza el que recopila páginas para los modelos; rechazar un rastreador de respuestas como OAI-SearchBot o PerplexityBot también lo saca de los enlaces que muestran esos asistentes. El token de entrenamiento de Google no es Googlebot: “Google-Extended no afecta a la inclusión de los sitios en la Búsqueda de Google ni se utiliza como factor de posicionamiento en la Búsqueda de Google”.
El tercer tipo es distinto. ChatGPT-User, Claude-User, Perplexity-User y Amzn-User obtienen una página porque una persona le pidió a un asistente que la abriera, así que rechazarlos es rechazar a esa persona, y algunos de sus operadores dicen que estos rastreadores pueden ignorar robots.txt de todos modos. Por eso la lista de rastreadores de arriba los pone en una sección propia.
GPTBotObedeceOAI-SearchBotObedeceChatGPT-UserPuede ignorarloClaudeBotObedeceClaude-SearchBotObedeceClaude-UserObedecePerplexityBotObedecePerplexity-UserPuede ignorarloGoogle-ExtendedSolo tokenSin rastreadorSin rastreadorApplebot-ExtendedSolo tokenSin rastreadorSin rastreadormeta-externalagentObedecemeta-webindexerObedecemeta-externalfetcherPuede ignorarloAmazonbotObedeceSin rastreadorAmzn-UserPuede ignorarloLes pide a los rastreadores que no obtengan una página; no le pide a un buscador que no la liste. Google “aun así puede indexar la URL y mostrarla en los resultados de búsqueda sin fragmento” cuando otras páginas enlazan a ella. Para dejar una página fuera, use noindex y deje la página rastreable para que la etiqueta se pueda leer.
Search Console lo llama “Se ha indexado aunque un archivo robots.txt la tenía bloqueada”. Y Google es explícito: “para que la regla noindex sea efectiva, la página o el recurso no debe estar bloqueado por un archivo robots.txt”. El propio noindex de una página bloqueada nunca se ve, porque el rastreador nunca obtiene la página.
Por eso cada preajuste de arriba dice lo que no hace. El Disallow: / del preajuste de pruebas mantiene fuera a los rastreadores que cumplen las normas, pero una URL de pruebas enlazada desde cualquier parte aún puede aparecer en los resultados: ponga el sitio de pruebas detrás de una contraseña y nunca lleve esa línea al sitio publicado.
<meta name="robots" content="noindex">Nunca se leePara dejar una página fuera: deje entrar al rastreador y use noindex, o exija iniciar sesión.
En la raíz del host al que se aplica, como /robots.txt, un archivo por host y protocolo. https://example.com/robots.txt no dice nada sobre https://www.example.com ni sobre https://shop.example.com: cada uno necesita su propio archivo, y un robots.txt dentro de una carpeta nunca se lee.
Google: “Debes colocar el archivo robots.txt en el directorio de nivel superior de un sitio y debes usar en él un protocolo compatible”. El informe de robots.txt de Search Console lista por separado los archivos de los 20 hosts principales de una propiedad, y cuenta aparte HTTP y HTTPS.
Escriba su sitio en la parte superior del generador y le dará la dirección exacta en la que debe responder el archivo, completará la línea Sitemap: para ese host y enlazará al Comprobador de Robots.txt, que lee el archivo publicado en cuanto esté en línea.
https://example.com/robots.txtTodas las URL de https://example.comhttps://www.example.com/robots.txtSolo www.example.com: es otro hosthttp://example.com/robots.txtSolo el sitio http://: es otro protocolohttps://shop.example.com/robots.txtSolo shop.example.comhttps://example.com/blog/robots.txtNada: un robots.txt dentro de una carpeta nunca se leeGoogle no lee ninguna de ellas. Bing lee Crawl-delay, Yandex lee Clean-param, Host no está ni en el estándar ni en la lista de Google, y Content-Signal de Cloudflare declara para qué se puede usar su contenido, no qué se puede rastrear.
Google lista sus cuatro campos y añade que “no se admiten otros campos, como crawl-delay”. El propio blog de Bing dice que “la directiva crawl-delay solo acepta números enteros positivos como valores”, así que el editor rechaza una fracción en lugar de escribirla. La página de ayuda actual de Bing no se pudo leer para confirmar un rango o una unidad, así que esta página no indica ninguno de los dos.
Ninguna de ellas rompe un archivo: RFC 9309 establece que el análisis de otros registros “NO DEBE interferir con el análisis de los registros definidos explícitamente”. De las cuatro, el generador solo escribe Crawl-delay, rotulado con quién lo lee.
User-agentLa leeLa leeLa leeAllowLa leeLa leeLa leeDisallowLa leeLa leeLa leeSitemapLa leeLa leeLa leeCrawl-delayLa ignoraLa leeSin confirmarClean-paramLa ignoraLa ignoraLa leeHostLa ignoraLa ignoraSin confirmarnoindexLa ignoraSin confirmarSin confirmarContent-SignalLa ignoraSin confirmarSin confirmarDos veces. Antes de publicar, con Pruébelo antes de publicarlo arriba: elija un rastreador y una ruta y vea la regla que lo decide. Después de subirlo, pase el Comprobador de Robots.txt por el archivo publicado, porque lo que responde el servidor importa tanto como lo que dice el archivo.
Un archivo que responde 404 se interpreta como si no hubiera archivo, así que cualquier rastreador puede tomarlo todo; un archivo que responde 500 o 503 significa que un rastreador que sigue el estándar no debe tomar nada. RFC 9309 §2.3.1.4: el rastreador “DEBE asumir una prohibición total”. Google lo suaviza con una escala propia, que se muestra en la figura.
El probador de robots.txt de Google ya no existe: Search Central anunció su retirada el 15 de noviembre de 2023, y el informe de robots.txt que lo sustituyó muestra el archivo que Google obtuvo, sin probar una URL contra una regla. Pruébelo antes de publicarlo, en el generador de arriba, y el comprobador de robots.txt hacen esa prueba.
200Sigue las reglas del archivo.301, 302Sigue al menos cinco saltos y después se detiene. Entonces Google lee el archivo como un 404.403, 404Rastrea todo, como si no hubiera archivo.429No rastrea nada. Google lo cuenta con las respuestas 5xx, no con las 4xx.500, 503No rastrea nada en absoluto, según el estándar.El nombre no existeNo hay ningún sitio que leer, así que no hay veredicto.Los errores que salen caros son, cada uno, una sola línea corta: un Disallow: / que quedó del entorno de pruebas, un prefijo que llega más lejos de lo que quería, una línea Sitemap: escrita como ruta, una ruta sin su barra inicial y una línea noindex que Google dejó de leer en 2019.
Aquí se detecta cada uno antes de copiar el archivo. La auditoría del propio comprobador se ejecuta mientras escribe y sus hallazgos aparecen bajo el archivo; una línea que un rastreador rechazaría nunca llega a escribirse, y el editor dice en su fila por qué quedó fuera.
Un error es una pareja, no una línea: una URL bloqueada aquí que además lleva noindex en la página. El rastreador nunca obtiene la página, así que nunca ve el noindex, y la URL puede seguir en los resultados de búsqueda. Elija una opción: bloquear el rastreo, o dejarlo entrar y decirle que no indexe.
Disallow: /Restos de un entorno de pruebas: todo el sitio publicado queda cerrado a todos los rastreadores.Disallow: /adminTambién bloquea /administrator y /admin-tools. Añada la barra final.Allow: / bajo User-agent: *Nunca lo lee un rastreador que tenga su propio grupo en cualquier parte del archivo.Sitemap: /sitemap.xmlUna línea Sitemap debe ser una dirección completa con el host.Disallow: adminUna ruta empieza en /. Esta regla no coincide con nada.noindex: /private/Muerto desde 2019. La página sigue siendo rastreable e indexable.* en el que está su Allow. El editor de arriba señala una regla a la que otra siempre le gana, y Pruébelo antes de publicarlo nombra la regla decisiva y el grupo que leyó el rastreador.Obtenga el robots.txt de cualquier sitio, compruebe si una URL está bloqueada para Googlebot o crawlers de IA y encuentre errores de sintaxis
Rastrea tu sitio web y obtén un sitemap XML, un mapa del sitio HTML y un árbol visual del sitio
Encuentre y valide el sitemap XML de un sitio web: sintaxis, límites de URL, fechas lastmod, conflictos con robots.txt y URL rotas o redirigidas
Compruebe el title, la meta description, la canonical, el hreflang y las etiquetas Open Graph y de X de una página, con vistas previas de Google y redes sociales
Analiza cabeceras de respuesta HTTP y clasificación de cabeceras de seguridad
Detecta tu navegador, SO, tipo de dispositivo, motor de renderizado y arquitectura de CPU desde tu user agent