











Generador de Sitemap
Un generador de sitemap gratis para crear sitemap.xml: rastrea su sitio como lo hace un motor de búsqueda, conserva solo las páginas que deben aparecer en los resultados y le dice por qué dejó fuera cada una de las demás URL.
También sirve un dominio: example.org empieza por su página de inicio.
- robots.txtSe lee primero y se obedece
- Su sitemapSe busca y se compara
- RastreadasHasta 500 páginas, 3 a la vez
- Decididasnoindex, canonical, redirecciones
Cómo crear un sitemap XML, paso a paso
Escriba su página de inicio arriba y seleccione Generar sitemap. El rastreador lee robots.txt, sigue sus enlaces como lo hace un motor de búsqueda, conserva solo las páginas que corresponden y le entrega un sitemap.xml para subir a la raíz de su sitio.
Una página corresponde cuando responde 200, es HTML, no lleva noindex, se nombra a sí misma como canonical y no está bloqueada por robots.txt. Las demás URL caen en Fuera con su motivo, para que pueda distinguir un error de una decisión.
Suba el archivo a la raíz, https://www.example.org/sitemap.xml: un sitemap solo puede listar URL de su propia carpeta y de las que cuelgan de ella, así que la raíz cubre todo el sitio (Google). Después añada una línea Sitemap: a robots.txt y envíelo en Google Search Console y en Bing Webmaster Tools.
1Escriba su página de inicio
example.orgo pegue una lista de URL2Rastreamos y decidimos
robots.txt 200499/500412 en el sitemap · 87 fuera3Descargue el archivo
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML o CSV4Suba y envíe
/sitemap.xmlSitemap: https://www.example.org/…la raíz · robots.txt · Search Console



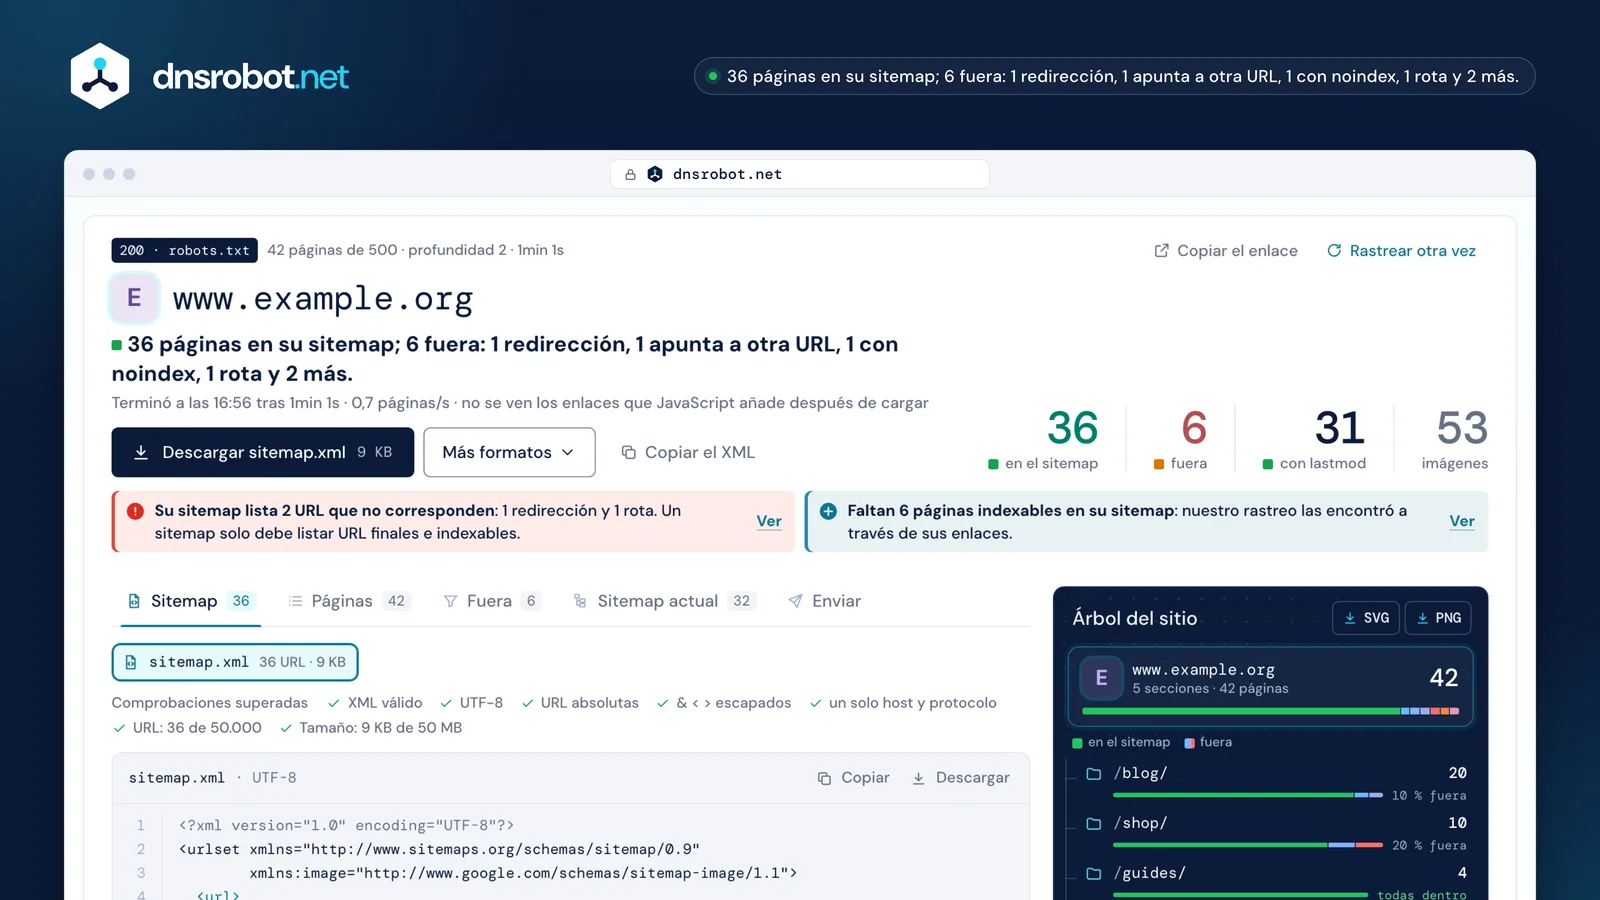
 El veredictoCuántas páginas entran, cuántas quedan fuera y por qué, en una sola frase. Las cifras grandes lo repiten.Descargarsitemap.xml, o un ZIP con todos los archivos y el índice cuando se reparte; también .xml.gz, TXT, un mapa del sitio HTML y un CSV con cada página rastreada.AvisosLas entradas desactualizadas de su sitemap actual, las páginas que le faltan y de dónde salió cada fecha lastmod.El árbol del sitioCada sección con su número de páginas y la proporción que queda fuera. Seleccione una rama para filtrar las páginas; descárguelo en SVG o PNG.
¿Cómo es un sitemap XML? Un ejemplo de sitemap
Un sitemap XML es un archivo UTF-8 con una entrada <url> por página. Solo <urlset>, <url> y <loc> son obligatorios; todo lo demás es opcional. Este es un ejemplo de sitemap, anotado línea por línea.
Cada <loc> es una URL completa y absoluta que empieza por el protocolo y no pasa de 2048 caracteres, con & escrito como & (sitemaps.org). <lastmod> es la fecha del último cambio de la página, en formato W3C como 2026-09-14; la hora es opcional, pero necesita zona horaria.
El espacio de nombres se queda en http://, incluso en un sitio https: es un nombre para los analizadores, no una dirección que alguien vaya a pedir. <changefreq> y <priority> están permitidos, pero Google y Bing los ignoran.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1UTF-8, declarado en la primera línea
- 2El espacio de nombres: http://, no https://
- 3Una URL absoluta, con & escrito como &
- 4La fecha de cambio real, o ningún lastmod
- 5Google y Bing lo ignoran
- 6Sin lastmod: una página de inicio solo reúne otras páginas
¿Qué páginas deben ir en un sitemap y por qué algunas quedan fuera?
Las URL canonical que usted quiere ver en los resultados de búsqueda, una por página: URL finales que responden 200, son indexables y no están bloqueadas por robots.txt. Todo lo demás queda fuera, con el motivo escrito al lado.
Una redirección, una página con noindex o una URL cuya canonical apunta a otra parte mandan a los motores de búsqueda un mensaje contradictorio: el sitemap dice “indexa esto” mientras la página dice lo contrario. No nombre una URL en el sitemap y otra en rel=canonical (Google), y tenga en cuenta que Search Console informa de los sitemaps que listan URL bloqueadas por robots.txt.
Cada URL de un sitemap es solo una sugerencia; Google sigue decidiendo qué páginas son duplicadas. Por eso este generador muestra el motivo de cada página que deja fuera: un noindex que usted quiso está bien, un noindex en su mejor producto no.
lastmod, changefreq y priority: ¿qué leen los motores de búsqueda?
Google y Bing ignoran changefreq y priority. Ambos usan lastmod, pero solo cuando es exacto: una fecha que cambia en cada rastreo les enseña a dejar de confiar en ella.
Google usa lastmod “si es coherente y verificablemente exacto”, y debe marcar el último cambio importante —el contenido principal, los datos estructurados o los enlaces—, no un año nuevo de copyright (Google). Un lastmod que sigue anunciando cambios recientes en páginas antiguas deja de merecer confianza. Bing programa sus rastreos con lastmod y puede desatender las fechas que siempre son hoy. Yandex todavía lee las tres etiquetas.
Por eso este generador nunca escribe la fecha de hoy. Toma lastmod de los datos de la propia página, en el orden de abajo, y lo deja fuera cuando no hay ninguna: dejarlo fuera está bien en una página de inicio o en una categoría que solo reúne otras páginas.
| Etiqueta | Bing | Yandex | |
|---|---|---|---|
| lastmod | la usa si es exacta | la usa si es exacta | la lee |
| changefreq | la ignora | la ignora | la lee |
| priority | la ignora | la ignora | la lee |
Qué aspecto tiene un “hoy” en cada página
412 entradas, una sola fecha: una fecha de generación, no de cambio.
50 000 URL, 50 MB y el índice de sitemaps
Un sitemap admite como máximo 50 000 URL y 50 MB sin comprimir. Al pasar el primero de los dos límites que alcance, reparta las URL en varios archivos y lístelos en un índice de sitemaps; después envíe el índice.
El límite cuenta el archivo sin comprimir, aunque lo sirva como .xml.gz: gzip, no ZIP (sitemaps.org). Un índice puede listar hasta 50 000 sitemaps, solo archivos de su propio sitio, en su carpeta o más abajo, y nunca otro índice. Naver Search Advisor rechaza los archivos de más de 10 MB, así que elija el límite de 10 MB en Más opciones para un sitio coreano.
Las alternativas de idioma (xhtml:link) no cuentan para las 50 000. Este generador reparte los archivos automáticamente y, si usted lo pide, por secciones: uno para el blog, otro para los productos.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
Entradas de imagen y de hreflang
Un sitemap también puede listar las imágenes de cada página y sus versiones en otros idiomas, dentro de la entrada <url> de esa misma página.
Las imágenes usan el espacio de nombres de imágenes de Google, hasta 1000 por página; solo <image:image> y <image:loc> siguen contando, y caption, title, license y geo_location se retiraron en 2022.
Para los idiomas, cada entrada lista todas las versiones de la página, ella incluida, con xhtml:link y un código hreflang: un idioma ISO 639-1 con una región ISO 3166-1 opcional, nunca una región sola. Los enlaces deben ir en los dos sentidos o Google los ignora, así que este generador escribe un grupo solo cuando todas las versiones enlazan de vuelta, y muestra el resto con su fallo. x-default es opcional, para los visitantes cuyo idioma usted no tiene.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja enlaza a de, y de no enlaza de vuelta: el grupo no se escribeentrada de imagen hasta 1000 por página
¿Cómo envío un sitemap a Google y a Bing?
Añada una línea Sitemap: a robots.txt, que todos los rastreadores leen, y envíe el archivo en Google Search Console y en Bing Webmaster Tools. Para las páginas nuevas y las que cambian, IndexNow avisa a Bing, Yandex, Naver y a otros a la vez.
Solo los propietarios verificados de un sitio pueden enviarlo en Search Console; la línea de robots.txt le sirve a cualquiera. Search Console no sigue las redirecciones de un sitemap enviado, así que envíe su dirección final. Bing lee un sitemap en cuanto lo encuentra y después aproximadamente una vez al día.
Los viejos pings anónimos ya no existen: Bing desactivó bing.com/ping el 13 de mayo de 2022 y Google anunció el 26 de junio de 2023 que su ping dejaría de funcionar; hoy responde 404. Una herramienta que todavía “avisa a Google con un ping” no hace nada.


Sitemap XML frente a mapa del sitio HTML (y mapas visuales)
Un sitemap XML es para los rastreadores, un mapa del sitio HTML es una página de enlaces para los visitantes y un mapa visual es un dibujo de la estructura del sitio para planificar. Solo el XML, o una lista TXT, se puede enviar a los motores de búsqueda.
Un mapa del sitio HTML sigue ayudando a los visitantes y reparte enlaces hacia las páginas profundas, pero no puede sustituir al archivo XML. Un sitemap de texto plano son solo URL, una por línea, en un archivo terminado en .txt.
Este generador hace los tres con un solo rastreo: sitemap.xml, un mapa del sitio HTML para pegar en una página y el árbol del sitio. Como generador de mapas visuales no cuesta nada: el árbol se descarga en SVG o PNG, algo que los servicios de mapas visuales suelen cobrar.
Sitemap XMLpara los motores de búsqueda
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
Mapa del sitio HTMLpara los visitantes
Example Garden Co.
Diario del huertoCuidado de los bancalesDistribución de los pimientosTiendaKit de riego por goteoGuías de cultivoMapa visualpara planificar
¿De verdad necesita un sitemap?
Un sitio pequeño cuyas páginas se enlazan todas entre sí puede no necesitarlo: Google sitúa la cifra en unas 500 páginas o menos. Los sitios grandes, los nuevos con pocos enlaces desde fuera y los que tienen muchas imágenes o vídeos son los que más ganan.
La propia guía de iniciación de Google llama opcional al sitemap, y enviarlo es una sugerencia, no una orden. Aun así cuesta poco, y el rastreo que lo construye muestra cosas que vale la pena saber: páginas a las que no llega ningún enlace, redirecciones a las que sus menús todavía apuntan y secciones que son casi todas noindex.
puede que no lo necesite
unas 500 páginas o menos, bien enlazadas
los que más ganan
- sitios grandes
- sitios nuevos, con pocos enlaces desde fuera
- muchas imágenes o vídeos
- 5 páginas a las que solo llega el sitemap
Errores de sitemap en Search Console y cómo corregirlos
Casi todos los errores de sitemap de Search Console se reducen a una URL que el sitemap no puede listar, un carácter sin escapar, una fecha sin zona horaria o un archivo por encima de los límites. Cada caso de abajo muestra la línea que lo provoca.
URL no permitida
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
Error de análisis
<loc>https://www.example.org/search?q=soil&page=2</loc>
Fecha incorrecta
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
Formato no admitido
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
Hay demasiadas URLs
<url> × 50.001
El sitemap incluye URLs que el archivo robots.txt ha bloqueado
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
También: No se ha podido obtener (bloqueado, 404, un error del servidor, una acción manual o poca demanda de rastreo), Error de compresión (vuelva a comprimirlo con gzip) y URL incompleta (cada archivo de un índice necesita su URL completa).
¿Puede la IA crear un sitemap?
La IA puede esbozar la estructura de un sitio para planificar, pero un sitemap es una lista de hechos sobre URL en vivo: cuáles responden 200, cuáles llevan noindex, cuáles redirigen. Eso solo se sabe pidiendo cada URL.
Un modelo al que se le pide el sitemap de un sitio que ya existe adivina las URL a partir de patrones. No puede ver que una página de producto ahora responde 404, que un archivo de etiquetas lleva noindex o que una entrada antigua redirige, y cada URL así en el archivo es una que Search Console puede señalar. Use la IA para el plan y el rastreo para el archivo.
Fuentes
- Protocolo de sitemaps.org y sus preguntas frecuentes: el formato, los límites de 50 000 / 50 MB, el índice y los sitemaps de texto
- Google Search Central: crear un sitemap, sitemaps grandes, versiones localizadas, sitemaps de imágenes, lastmod y el ping retirado y los errores del informe Sitemaps
- Bing: los sitemaps en la búsqueda con IA (2025), la etiqueta lastmod (2023) y el ping eliminado (2022)
- Yandex: sitemap, Naver Search Advisor: feeds e IndexNow
- RFC 9309, el estándar de robots.txt que sigue este rastreador
| URL | Supuesta | Rastreada |
|---|---|---|
| /blog/raised-care/ | incluir | En el sitemap200 |
| /product/fern-varieties/ | incluir | 4xx404 |
| /tag/native-bed/ | incluir | noindexmeta |
| /2019/07/raised-care/ | incluir | Redirección301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | incluir | Canonical a otra URL→ /blog/pollinator-kit/ |
Preguntas frecuentes sobre el generador de sitemap
¿Es gratis crear un sitemap XML con este generador?
¿Por qué faltan algunas de mis páginas en el sitemap?
¿Dónde pongo el archivo sitemap.xml?
¿Cuántas URL puede tener un sitemap?
¿Google usa priority y changefreq?
¿Por qué algunas páginas se quedan sin fecha lastmod?
¿Un sitemap debe incluir redirecciones o páginas con noindex?
¿Cómo envío mi sitemap a Google?
Mi CMS ya hace un sitemap. ¿Necesito este?
¿Este rastreador de sitemaps obedece robots.txt?
¿Puede rastrear un sitio hecho con JavaScript?
¿Qué es IndexNow y sigo necesitando un sitemap si lo uso?
Más herramientas de rastreo y SEO
Analizador de Enlaces
Analiza todos los enlaces de una página con detección dofollow/nofollow y verificación de estado HTTP
Verificador de Redirecciones
Verifica redirecciones de URL, cadenas de redirección y códigos de estado HTTP para SEO
Verificador de encabezados HTTP
Analiza cabeceras de respuesta HTTP y clasificación de cabeceras de seguridad
Comprobador de Páginas Caídas
¿La página está caída para todos o solo para usted? Compruebe cualquier web desde 11 lugares y desde su conexión, con una captura en vivo
Buscador de Subdominios
Descubre todos los subdominios de cualquier dominio
Detector de CMS
Qué CMS, tema, plugins y tecnologías usa una web, con la prueba de cada uno