











Generator mapy strony XML
Darmowy generator mapy strony, który skanuje witrynę tak jak wyszukiwarka, zostawia tylko strony mające prawo trafić do wyników i mówi, dlaczego pominął każdy inny adres.
Domena też wystarczy: example.org zaczyna od strony głównej.
- robots.txtCzytamy pierwszy, przestrzegamy
- Twój sitemapZnajdziemy i porównamy
- PrzeskanowaneDo 500 stron, po 3 naraz
- Decyzjanoindex, canonical, przekierowania
Jak zrobić mapę strony XML krok po kroku
Wpisz wyżej adres strony głównej i wybierz „Wygeneruj sitemap”. Nasz robot czyta robots.txt, idzie po twoich linkach tak jak wyszukiwarka, zostawia tylko strony, które tam pasują, i oddaje ci plik sitemap.xml do wgrania do katalogu głównego witryny.
Strona tam pasuje, gdy odpowiada 200, jest HTML-em, nie ma noindex, wskazuje samą siebie jako canonical i nie jest zablokowana w robots.txt. Każdy inny adres ląduje w widoku Pominięte razem z powodem, więc odróżnisz pomyłkę od świadomej decyzji.
Wgraj plik do katalogu głównego, https://www.example.org/sitemap.xml: sitemap może wymieniać tylko adresy ze swojego katalogu i katalogów poniżej, więc w katalogu głównym obejmuje całą witrynę (Google). Potem dodaj do robots.txt linię Sitemap: i zgłoś plik w Google Search Console oraz Bing Webmaster Tools.
1Wpisz adres strony głównej
example.orgalbo wklej listę adresów2Skanujemy i decydujemy
robots.txt 200499/500412 w pliku sitemap · pominięto 873Pobierz plik
sitemap.xml93 KBXML, gzip, ZIP, TXT, HTML lub CSV4Wgraj i zgłoś
/sitemap.xmlSitemap: https://www.example.org/…katalog główny · robots.txt · Search Console



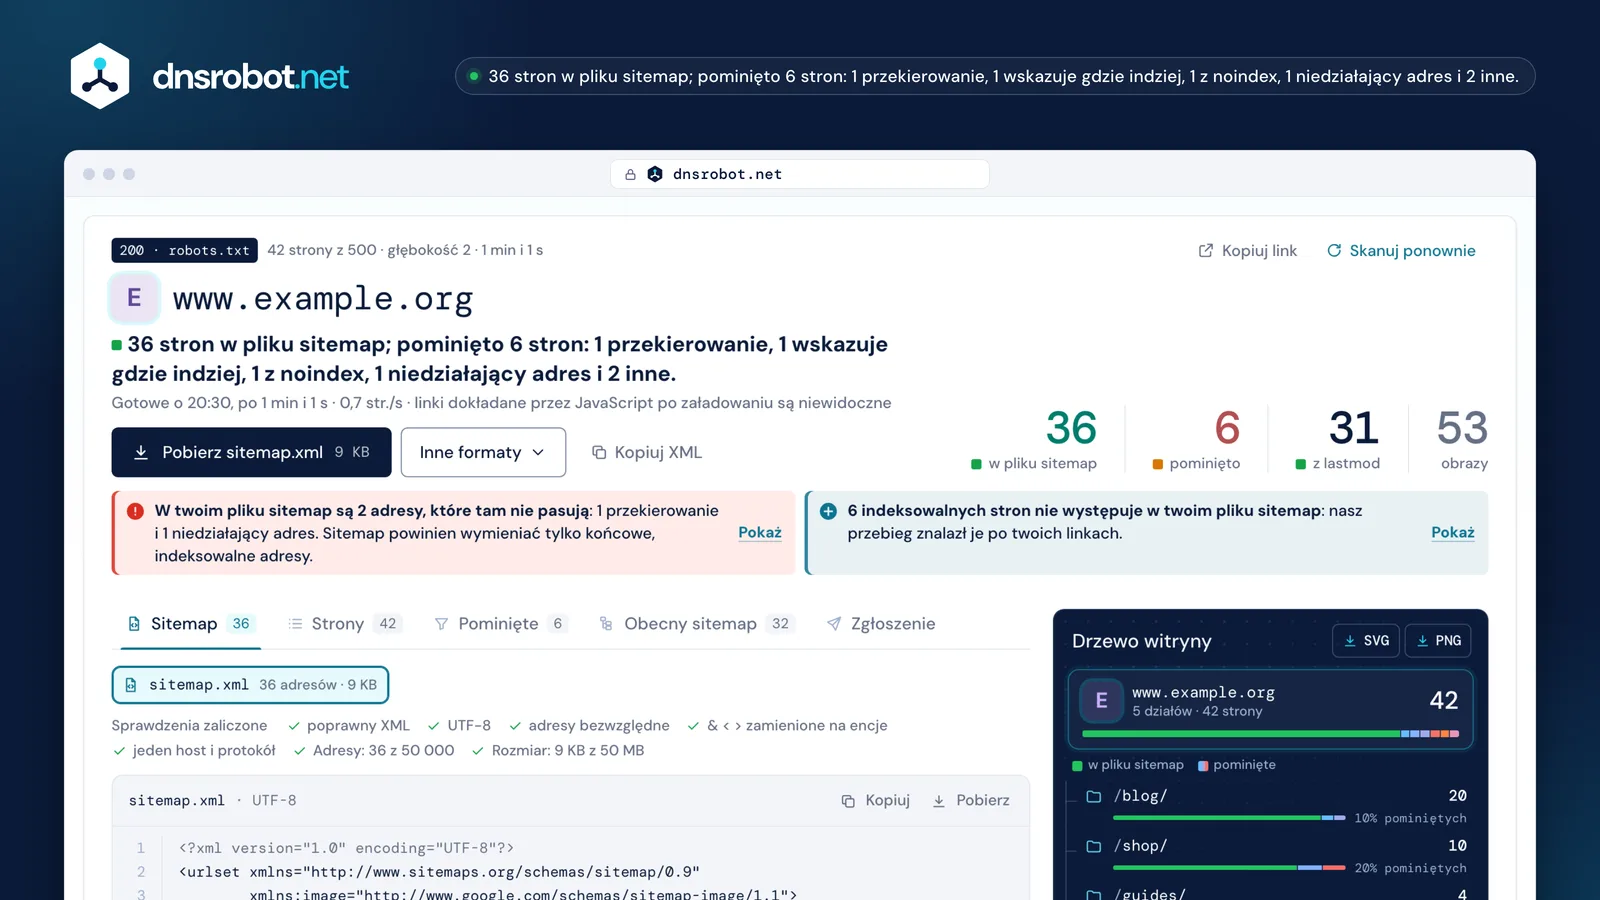
 WerdyktIle stron wchodzi, ile zostaje pominiętych i dlaczego — w jednym zdaniu. Duże liczby powtarzają to samo.Pobieraniesitemap.xml albo ZIP ze wszystkimi plikami i indeksem, gdy plik jest dzielony; a także .xml.gz, TXT, mapa strony HTML i CSV z każdą przeskanowaną stroną.UwagiNieaktualne wpisy w twoim obecnym pliku sitemap, strony, których w nim brakuje, i to, skąd wzięła się każda data lastmod.Drzewo witrynyKażdy dział z liczbą stron i udziałem pominiętych. Wybierz gałąź, aby odfiltrować strony; pobierz je w SVG albo PNG.
Jak wygląda sitemap XML? Przykład mapy strony
Sitemap XML to plik w UTF-8 z jednym wpisem <url> na stronę. Wymagane są tylko <urlset>, <url> i <loc>; cała reszta jest opcjonalna. Oto przykład mapy strony, opisany wiersz po wierszu.
Każdy <loc> to pełny, bezwzględny adres, który zaczyna się od protokołu i mieści się poniżej 2048 znaków, z & zapisanym jako & (sitemaps.org). <lastmod> to data ostatniej zmiany strony w formacie W3C, na przykład 2026-09-14; godzina jest opcjonalna, ale wymaga strefy czasowej.
Przestrzeń nazw zostaje na http:// nawet w witrynie na https: to nazwa dla parserów, a nie adres, pod który ktokolwiek sięga. <changefreq> i <priority> są dozwolone, ale Google i Bing je ignorują.
<?xml version="1.0" encoding="UTF-8"?> 1 <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> 2 <url> <loc>https://www.example.org/</loc> 6 </url> <url> <loc>https://www.example.org/shop/?size=m&color=green</loc> 3 <lastmod>2026-09-14</lastmod> 4 <changefreq>weekly</changefreq> 5 <priority>0.8</priority> </url> </urlset>
- 1UTF-8, zadeklarowany w pierwszym wierszu
- 2Przestrzeń nazw: http://, nie https://
- 3Adres bezwzględny, z & zapisanym jako &
- 4Prawdziwa data zmiany albo żadnego lastmod
- 5Google i Bing to ignorują
- 6Bez lastmod: strona główna tylko zbiera inne strony
Które strony pasują do mapy strony, a które są pomijane?
Kanoniczne adresy, które chcesz widzieć w wynikach, po jednym na stronę: końcowe adresy odpowiadające 200, indeksowalne i niezablokowane w robots.txt. Cała reszta jest pomijana, a powód stoi obok.
Przekierowanie, strona z noindex albo adres, którego canonical wskazuje gdzie indziej, wysyła wyszukiwarkom sprzeczny sygnał: sitemap mówi „zaindeksuj to”, a strona mówi co innego. Nie wymieniaj jednego adresu w pliku sitemap, a innego w rel=canonical (Google) — Search Console zgłasza też pliki sitemap z adresami, które blokuje robots.txt.
Każdy adres w pliku sitemap to tylko sugestia; o tym, które strony są duplikatami, i tak decyduje Google. Dlatego ten generator pokazuje powód przy każdej pominiętej stronie: zaplanowany noindex jest w porządku, noindex na twoim najlepszym produkcie już nie.
lastmod, changefreq i priority: co naprawdę czytają wyszukiwarki?
Google i Bing ignorują changefreq oraz priority. Oba czytają lastmod, ale tylko wtedy, gdy jest dokładny: data, która zmienia się przy każdym skanowaniu, uczy je, że nie warto jej ufać.
Google używa lastmod, „jeśli jest konsekwentnie i sprawdzalnie dokładny”, i ma on oznaczać ostatnią istotną zmianę — treści głównej, danych strukturalnych albo linków — a nie nowy rok w nocie o prawach autorskich (Google). lastmod, który wciąż ogłasza świeże zmiany na starych stronach, przestaje być brany na poważnie. Bing planuje skanowanie według lastmod i może pomijać daty, które zawsze są dzisiejsze. Yandex nadal czyta wszystkie trzy tagi.
Dlatego ten generator nigdy nie wpisuje dzisiejszej daty. Bierze lastmod z danych samej strony, w kolejności poniżej, i pomija go, gdy żadnej nie ma: brak daty jest zupełnie w porządku na stronie głównej albo na stronie kategorii, która tylko zbiera inne.
| Tag | Bing | Yandex | |
|---|---|---|---|
| lastmod | używa, gdy jest dokładny | używa, gdy jest dokładny | czyta |
| changefreq | ignoruje | ignoruje | czyta |
| priority | ignoruje | ignoruje | czyta |
Jak wygląda „dzisiaj” na każdej stronie
412 wpisów, jedna data: data wygenerowania pliku, a nie daty zmian.
50 000 adresów, 50 MB i indeks sitemap
Jeden plik sitemap mieści najwyżej 50 000 adresów i 50 MB bez kompresji. Po przekroczeniu tego z limitów, który wypadnie pierwszy, rozłóż adresy na kilka plików i wymień je w indeksie sitemap; zgłaszasz wtedy indeks.
Limit liczy plik nieskompresowany, nawet gdy serwujesz go jako .xml.gz — gzip, nie ZIP (sitemaps.org). Indeks może wymieniać do 50 000 plików sitemap, wyłącznie z własnej witryny, ze swojego katalogu albo niżej, i nigdy kolejnego indeksu. Naver Search Advisor odrzuca pliki większe niż 10 MB, więc dla koreańskiej witryny wybierz limit 10 MB w sekcji „Więcej opcji”.
Wersje językowe (xhtml:link) nie liczą się do 50 000. Ten generator dzieli pliki automatycznie, a na życzenie także po działach: osobny plik na blog, osobny na produkty.
4.4 MB
4.6 MB
4.5 MB
2.9 MB
Wpisy obrazów i hreflang
Sitemap może też wymieniać obrazy każdej strony i jej wersje w innych językach, wewnątrz wpisu <url> tej właśnie strony.
Obrazy korzystają z przestrzeni nazw Google dla obrazów, do 1000 na stronę; liczą się już tylko <image:image> i <image:loc>, a caption, title, license i geo_location zostały wycofane w 2022 roku.
Przy językach każdy wpis wymienia wszystkie wersje strony, łącznie z nią samą, przez xhtml:link i kod hreflang: język w ISO 639-1 z opcjonalnym regionem w ISO 3166-1, nigdy sam region. Linki muszą iść w obie strony, inaczej Google je pomija, więc ten generator zapisuje klaster dopiero wtedy, gdy każda wersja odsyła z powrotem, a pozostałe pokazuje razem z błędem. x-default jest opcjonalny, dla odwiedzających, których języka nie masz.
<url>
  <loc>https://docs.example.net/de/guide/install/</loc>
  <image:image>
    <image:loc>https://docs.example.net/img/ui.png</image:loc>
  </image:image>
  <xhtml:link rel="alternate" hreflang="en"
    href="https://docs.example.net/en/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="de"
    href="https://docs.example.net/de/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="ja"
    href="https://docs.example.net/ja/guide/install/"/>
  <xhtml:link rel="alternate" hreflang="x-default"
    href="https://docs.example.net/en/guide/install/"/>
</url>
ja linkuje do de, a de nie odsyła z powrotem: klaster nie zostaje zapisanywpis obrazu do 1000 na stronę
Jak zgłosić mapę strony do Google i Bing?
Dodaj do robots.txt linię Sitemap:, którą czyta każdy robot, i zgłoś plik w Google Search Console oraz Bing Webmaster Tools. Przy nowych i zmienionych stronach IndexNow powiadamia Bing, Yandex, Naver i innych naraz.
W Search Console zgłosi plik tylko zweryfikowany właściciel witryny; linia w robots.txt działa u każdego. Search Console nie podąża za przekierowaniami przy zgłoszonym pliku sitemap, więc podaj jego końcowy adres. Bing czyta plik, gdy tylko go znajdzie, a potem mniej więcej raz dziennie.
Dawne anonimowe pingi zniknęły: Bing wyłączył bing.com/ping 13 maja 2022, a Google ogłosił 26 czerwca 2023, że jego ping przestanie działać; dziś odpowiada 404. Narzędzie, które nadal „pinguje Google”, nie robi nic.


Sitemap XML a mapa strony HTML (i mapy wizualne)
Sitemap XML jest dla robotów, mapa strony HTML to strona z linkami dla odwiedzających, a wizualna mapa strony to obrazek struktury witryny, do planowania. Do wyszukiwarek zgłosisz tylko ten pierwszy albo listę TXT.
Mapa strony HTML nadal pomaga odwiedzającym i rozprowadza linki do głębokich podstron, ale nie zastąpi pliku XML. Sitemap w zwykłym tekście to same adresy, po jednym na wiersz, w pliku z końcówką .txt.
Ten generator robi wszystkie trzy z jednego skanowania: sitemap.xml, mapę strony HTML do wklejenia na podstronę i drzewo witryny. Jako generator wizualnej mapy strony nic nie kosztuje: drzewo pobierzesz w SVG albo PNG, za co serwisy od wizualnych map strony zwykle każą płacić.
Sitemap XMLdla wyszukiwarek
<url>
  <loc>…/blog/</loc>
</url>
<url>
  <loc>…/product/</loc>
</url>
Mapa strony HTMLdla odwiedzających
Example Garden Co.
Dziennik ogrodowyPielęgnacja podwyższonych grządekRozkład paprykSklepZestaw startowy do nawadniania kroplowegoPoradniki uprawyWizualna mapa stronydo planowania
Czy w ogóle potrzebujesz mapy strony?
Mała witryna, której strony linkują się nawzajem, może się bez niej obejść: Google podaje liczbę mniej więcej 500 stron lub mniej. Najwięcej zyskują duże witryny, nowe witryny z niewieloma linkami z zewnątrz oraz witryny z dużą liczbą obrazów albo filmów.
Własny przewodnik startowy Google nazywa sitemap opcjonalnym, a zgłoszenie go jest podpowiedzią, nie rozkazem. Kosztuje jednak niewiele, a skanowanie, które go buduje, pokazuje rzeczy warte wiedzy: strony, do których nie prowadzi żaden link, przekierowania, na które wciąż wskazują twoje menu, i działy prawie w całości na noindex.
może się bez niej obejść
około 500 stron lub mniej, dobrze polinkowane
zyskuje najwięcej
- duże witryny
- nowe witryny, mało linków z zewnątrz
- dużo obrazów albo filmów
- 5 stron, do których dociera tylko sitemap
Błędy mapy strony w Search Console i jak je naprawić
Większość błędów sitemap w Search Console sprowadza się do adresu, którego plik nie ma prawa wymieniać, znaku bez encji, daty bez strefy czasowej albo pliku ponad limitem. Każdy przypadek poniżej pokazuje wiersz, który go wywołuje.
Niedozwolony adres URL
sitemap: https://www.example.org/sitemap.xml
<loc>http://example.org/about/</loc>
Błąd analizy składni
<loc>https://www.example.org/search?q=soil&page=2</loc>
Nieprawidłowa data
<lastmod>2026-09-14T08:30:00</lastmod>
→ 2026-09-14T08:30:00+00:00
Nieobsługiwany format
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/.9”>
Zbyt wiele adresów URL
<url> × 50 001
Mapa witryny zawiera URL-e blokowane przez plik robots.txt
robots.txt: Disallow: /search/
<loc>https://www.example.org/search/tomato/</loc>
Poza tym: Nie udało się pobrać (blokada, 404, błąd serwera, działanie ręczne albo niskie zapotrzebowanie na skanowanie), Błąd kompresji (spakuj plik gzipem jeszcze raz) oraz Niepełny adres URL (każdy plik w indeksie potrzebuje pełnego adresu).
Czy AI może zrobić mapę strony?
AI naszkicuje strukturę witryny do planowania, ale sitemap to lista faktów o żywych adresach: które odpowiadają 200, które mają noindex, które przekierowują. Powie ci to dopiero pobranie każdego adresu.
Model poproszony o sitemap istniejącej witryny zgaduje adresy po wzorcach. Nie widzi, że karta produktu odpowiada już 404, że archiwum tagów ma noindex albo że stary wpis przekierowuje, a każdy taki adres w pliku to jeden, który Search Console może zgłosić. Użyj AI do planu, a plik zbuduj skanowaniem.
Źródła
- Protokół sitemaps.org i jego FAQ: format, limity 50 000 / 50 MB, indeks, pliki tekstowe
- Google Search Central: budowa pliku sitemap, duże pliki sitemap, wersje zlokalizowane, sitemap obrazów, lastmod i wycofany ping oraz błędy w raporcie Mapy witryn
- Bing: pliki sitemap w wyszukiwaniu z AI (2025), tag lastmod (2023) i usunięty ping (2022)
- Yandex: sitemap, Naver Search Advisor: kanały i IndexNow
- RFC 9309, standard robots.txt, którego przestrzega ten robot
| URL | Zgadnięte | Przeskanowane |
|---|---|---|
| /blog/raised-care/ | uwzględnij | W pliku sitemap200 |
| /product/fern-varieties/ | uwzględnij | 4xx404 |
| /tag/native-bed/ | uwzględnij | noindexmeta |
| /2019/07/raised-care/ | uwzględnij | Przekierowanie301 → /blog/raised-care/ |
| /blog/pollinator-kit/amp/ | uwzględnij | Canonical gdzie indziej→ /blog/pollinator-kit/ |
Generator mapy strony: pytania i odpowiedzi
Czy ten generator mapy strony XML jest darmowy?
Dlaczego część moich stron nie trafiła do pliku sitemap?
Gdzie wgrać plik sitemap.xml?
Ile adresów może mieć jeden plik sitemap?
Czy Google używa priority i changefreq?
Dlaczego niektóre strony nie dostają daty lastmod?
Czy sitemap powinien zawierać przekierowania albo strony z noindex?
Jak zgłosić mapę strony do Google?
Mój CMS już tworzy sitemap. Czy potrzebuję tego?
Czy ten robot przestrzega robots.txt?
Czy przeskanuje witrynę zbudowaną w JavaScripcie?
Czym jest IndexNow i czy przy nim nadal potrzebny jest sitemap?
Więcej narzędzi do skanowania i SEO
Analiza Linków
Analizuj wszystkie linki na stronie z wykrywaniem dofollow/nofollow i sprawdzaniem statusu HTTP
Sprawdzanie Przekierowań
Sprawdź przekierowania URL, łańcuchy przekierowań i kody statusu HTTP dla SEO
Sprawdzanie Nagłówków HTTP
Analizuj nagłówki odpowiedzi HTTP i ocenę nagłówków bezpieczeństwa
Czy strona działa?
Awaria dla wszystkich czy tylko u Ciebie? Sprawdź dowolną stronę z 11 miejsc i ze swojego łącza, ze zrzutem ekranu na żywo
Wyszukiwarka Subdomen
Odkryj wszystkie subdomeny dowolnej domeny
Detektor CMS
Jaki CMS, motyw, wtyczki i technologie ma strona, z dowodem dla każdego