Każdy inny robot
User-agent: *
Tę grupę czyta każdy robot, który nie ma własnej.
- Zezwala na całą witrynę.
Google go ignoruje, Bing go czyta.
Motyw
Utwórz plik robots.txt, któremu możesz zaufać: każda reguła wyjaśniona w trakcie pisania, plik odczytany przez nasz tester robots.txt zgodnie z RFC 9309 i interpretacją samego Google oraz werdykt na żywo dla dowolnego robota i dowolnej ścieżki, zanim opublikujesz.
Jeden plik na host i protokół: www.example.com i example.com potrzebują osobnych plików.
Źródło: RFC 9309, stan na 26 października 2026.
Tę grupę czyta każdy robot, który nie ma własnej.
Wybierz, co dostaje każdy znany robot. Robot z własną grupą czyta tylko tę grupę.
Te roboty skanują, żeby zbudować indeks wyszukiwarki. Zablokowane strony mogą nadal trafić do wyników dzięki linkom z innych miejsc, ale bez niczego, co odczytano z nich samych.
Te roboty zbierają strony do trenowania modeli. Osobny token pozwala odmówić trenowania bez utraty widoczności w wyszukiwarce.
Te roboty pobierają strony, żeby odpowiadać na pytania z linkiem do ciebie.
Te roboty pobierają jedną stronę, bo poprosiła o nią konkretna osoba, więc niektórzy operatorzy mówią, że mogą one ignorować robots.txt.
Blokując je, odmawiasz człowiekowi, a nie skanowaniu: gdy ktoś poprosi asystenta AI o otwarcie jednej z twoich stron, asystent, który przestrzega pliku, nie przeczyta jej dla tej osoby. Jeśli chodzi ci o trenowanie, zablokuj roboty trenujące powyżej.
Podglądy linków, narzędzia właściciela witryny, kontrole reklam, archiwa i roboty, których operatorzy podają inne zadanie albo nie podają żadnego.
Twój robots.txt/robots.txt
User-agent: *Allow: /BłądOstrzeżenieInformacja23 B z 500 KiB
1 ostrzeżenie
Co zrobić To najtańszy wiersz w pliku i czyta go każdy robot. Dodaj Sitemap: z pełnym adresem swojego pliku sitemap.
Wybierz robota i ścieżkę: werdykt, decydująca reguła i grupa, którą czyta robot, pochodzą z mechanizmu dopasowania samego testera robots.txt.
Temu robotowi wolno pobrać ten adres URL.
User-agent: *zaczyna się w wierszu 1
Żadna grupa nie wymienia tego robota, więc obowiązuje grupa *.
Allow: /wiersz 2
/any-page
/
Porównywane są tylko ścieżka i ciąg zapytania, bajt po bajcie, po zakodowaniu procentowym. Host, protokół i fragment nigdy nie są częścią reguły.
Napisz reguły, zapisz je jako zwykły plik tekstowy o nazwie robots.txt, zakodowany w UTF-8, i wgraj go do katalogu głównego witryny, tak żeby odpowiadał pod adresem https://example.com/robots.txt. Niczego nie trzeba zgłaszać: roboty same pytają o ten adres.
Google mówi to w trzech zdaniach: „Plik musi się nazywać robots.txt. Witryna może mieć tylko 1 plik robots.txt. Plik robots.txt musi się znajdować w katalogu głównym hosta witryny, do której się odnosi”. Musi być „plikiem tekstowym zakodowanym w formacie UTF-8”, a „roboty Google automatycznie go znajdą i zaczną z niego korzystać”.
Generator powyżej zaczyna od szablonu, wyjaśnia każdą regułę w trakcie pisania i odczytuje wynik parserem i mechanizmem dopasowania naszego testera robots.txt, zanim go skopiujesz. Pobrany plik nazywa się robots.txt: UTF-8 bez znacznika kolejności bajtów, tylko znaki LF na końcu wierszy i żadnej daty ani komentarza, o które nie prosiłeś.
https://example.com/robots.txtNie ma kroku zgłaszania: roboty Google same znajdują plik.
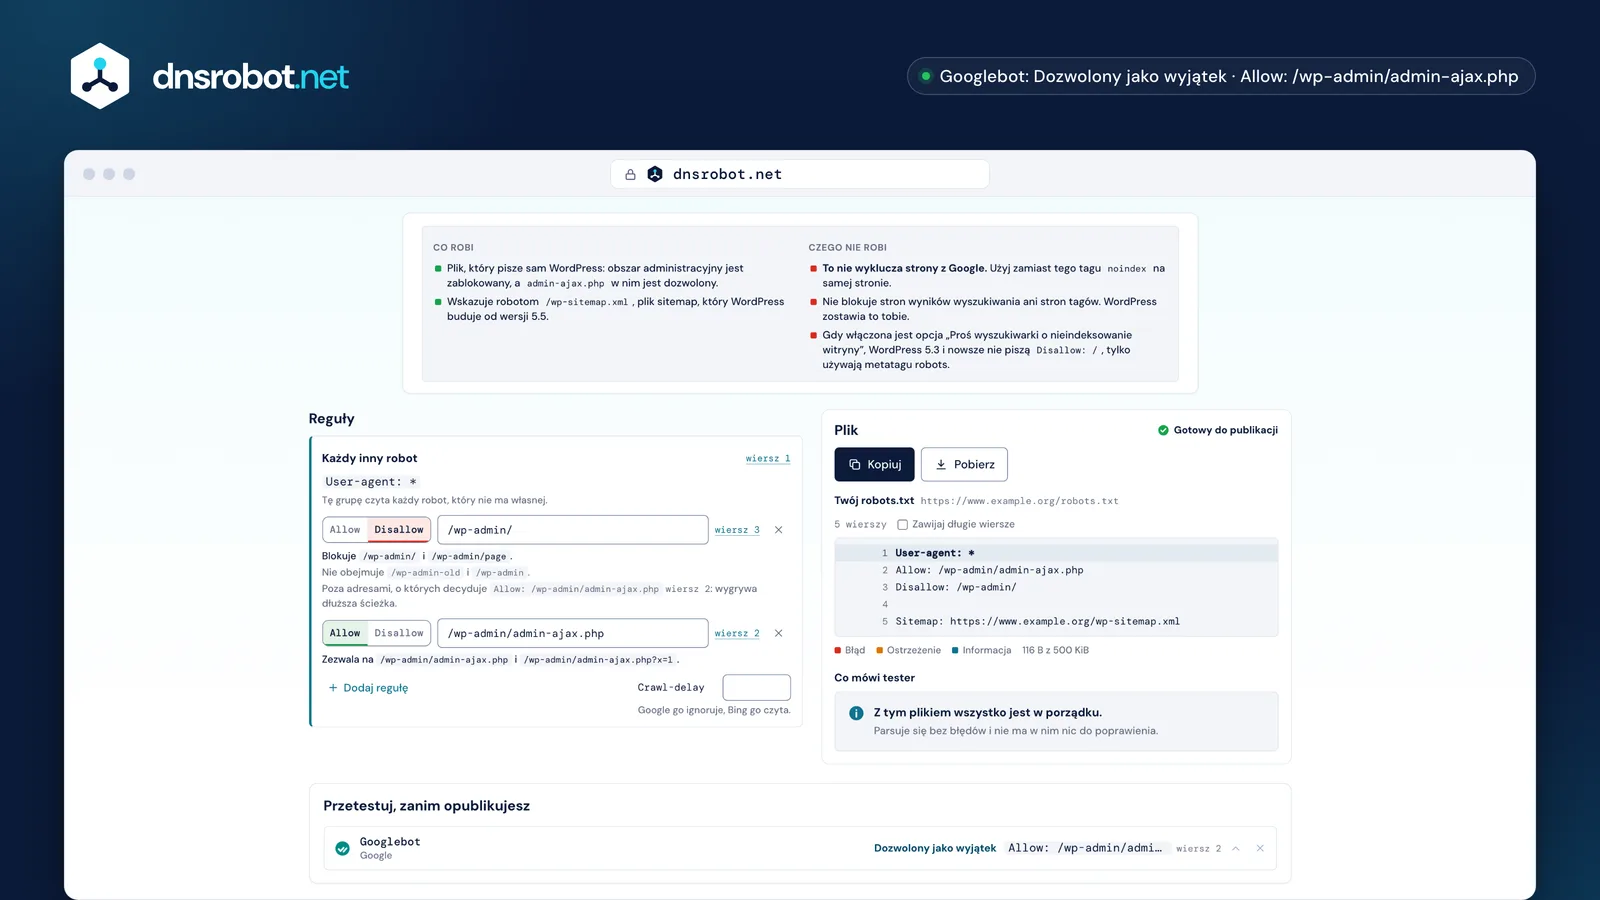
 Co robi szablonI czego nie robi: żaden z tych szablonów nie wyklucza strony z Google i każdy to mówi.Każda reguła wyjaśnionaŚcieżki, które reguła blokuje, i te, które pomija, z tego samego mechanizmu dopasowania, który wydaje każdy werdykt, oraz dłuższa reguła, która tworzy wyjątek.Plik i uwagiPlik z numerami wierszy, odczytany przez audyt samego testera robots.txt, zanim go skopiujesz.WerdyktWybierz robota i ścieżkę: dozwolony czy zablokowany, reguła, która o tym zdecydowała, z jej wierszem, i grupa, którą czyta robot.
Grupy i wiersze Sitemap. Grupa zaczyna się od jednego lub kilku wierszy User-agent z nazwami robotów, po których idą reguły Allow i Disallow, których te roboty przestrzegają; wiersz Sitemap stoi osobno, poza wszystkimi grupami.
RFC 9309 definiuje grupę jako „jeden lub więcej wierszy user-agent, po których następuje jedna lub więcej reguł”, a robot przestrzega dokładnie jednej grupy: tej, która wymienia jego własny token produktu, albo grupy *, gdy żadna go nie wymienia. Google czyta cztery pola i żadnych innych: user-agent, allow, disallow i sitemap.
W nazwach pól wielkość liter nie ma znaczenia, w ścieżkach ma: w przykładzie samego Google reguła disallow: /file.asp „ma zastosowanie” do /file.asp, ale do /FILE.asp „już nie”. Wiersz Sitemap: musi być pełnym adresem z protokołem i hostem; ten generator odrzuca każdy inny i mówi dlaczego.
User-agent: *Zaczyna grupę dla każdego robota bez własnej grupyDisallow: /cart/Ścieżka, której te roboty nie mogą pobieraćAllow: /cart/helpWyjątek: dłuższy niż Disallow, więc wygrywa User-agent: GPTBotZaczyna grupę z nazwami dwóch robotówUser-agent: ClaudeBotDisallow: /Oba mają zablokowaną całą witrynę Sitemap: https://www.example.org/sitemap.xmlPoza wszystkimi grupami: pełny adres* i $: jak reguła dopasowuje adresGdy do adresu URL pasuje kilka reguł, wygrywa ta z najdłuższą ścieżką, bez względu na jej rodzaj, a przy remisie wygrywa Allow. * oznacza dowolny ciąg znaków, a $ koniec adresu URL; nic innego w ścieżce nie ma specjalnego znaczenia.
RFC 9309: „Najbardziej szczegółowe znalezione dopasowanie MUSI zostać użyte. Najbardziej szczegółowe dopasowanie to to, które ma najwięcej oktetów” oraz „jeśli reguła allow i reguła disallow są równoważne, POWINNA zostać użyta reguła allow”. Tak działa plik samego WordPress: Disallow: /wp-admin/ zamyka katalog, a dłuższe Allow: /wp-admin/admin-ajax.php otwiera w nim jeden plik.
Reguła bez $ jest prefiksem, więc Disallow: /admin blokuje też /administrator; dodaj ukośnik (/admin/), gdy chodzi ci o katalog. Pod każdą regułą edytor powyżej pokazuje ścieżki, które obejmuje, i niektóre z tych, których nie obejmuje, z mechanizmu dopasowania, który wydaje każdy werdykt, i oznacza regułę, z którą zawsze wygrywa inna.
* i $ oraz to, co naprawdę obejmuje każdy wzorzec/admin/admin/ · /administrator · /admin-tools/wp-admin/admin//admin/users/administrator/*.pdf$/files/report.pdf/report.pdf?v=2/*?/search?q=x/search?, ., [ i + to zwykłe znaki. W robots.txt nie ma wyrażeń regularnych.
/admin/report.pdfWygrywa Allow: dopasowuje większą część ścieżki.
Disallow: /files/7 znakówAllow: /files/7 znakówTa sama długość, więc wygrywa Allow: Google stosuje „regułę najmniej restrykcyjną”.
Wszystkie trzy już go udostępniają, a szablony powyżej piszą to, co opisuje dokumentacja każdej platformy: WordPress blokuje obszar administracyjny, ale zezwala na admin-ajax.php, Shopify blokuje koszyki, realizację zakupu oraz filtrowane lub sortowane kolekcje, a Next.js udostępnia plik, który umieścisz w app/robots.txt.
WordPress pisze swój plik w kodzie, w do_robots(): User-agent: *, Disallow dla ścieżki panelu administracyjnego i Allow dla admin-ajax.php, a do tego, w publicznej witrynie od WordPress 5.5, wiersz Sitemap: dla /wp-sitemap.xml. Gdy włączona jest opcja „Proś wyszukiwarki o nieindeksowanie witryny”, WordPress 5.3 i nowsze nie piszą już Disallow: /; zamiast tego używają metatagu robots.
Shopify mówi, że jego domyślny plik „sprawdza się w większości sklepów”. Nie ma pliku do wgrania: zmiana oznacza edycję pliku robots.txt.liquid motywu, co Shopify nazywa „nieobsługiwanym dostosowaniem”. Next.js udostępnia app/robots.txt w takiej postaci, w jakiej go zapisano, albo buduje plik z app/robots.ts.
 WordPress
User-agent: *Allow: /wp-admin/admin-ajax.phpDisallow: /wp-admin/ Sitemap: https://example.com/wp-sitemap.xmlPisze go sam WordPress. Zmienisz go wtyczką albo filtrem robots_txt.
 Shopify
User-agent: *Allow: /Disallow: /adminDisallow: /cart/Disallow: /checkoutDisallow: /checkouts/Disallow: /accountDisallow: /ordersDisallow: /collections/*+*Disallow: /collections/*sort_by* Sitemap: https://example.com/sitemap.xmlDomyślny plik Shopify. Zmienisz go w pliku robots.txt.liquid motywu.
 Next.js
User-agent: *Allow: / Sitemap: https://example.com/sitemap.xmlTwój własny plik w app/robots.txt albo app/robots.ts, udostępniany pod /robots.txt.
Grupa wymieniająca robota, a pod nią Disallow: /, działa na każdego robota, którego operator mówi, że przestrzega robots.txt, i tylko na takie. To prośba, którą robot respektuje, a nie zamek: robot, który ignoruje plik, nadal może pobrać każdą stronę.
Większość firm AI ma więcej niż jednego robota, więc decyduj osobno dla każdego zadania. Blokując robota trenującego, takiego jak GPTBot czy ClaudeBot, blokujesz tego, który zbiera strony dla modeli; blokując robota od odpowiedzi, takiego jak OAI-SearchBot czy PerplexityBot, znikasz też z linków w odpowiedziach tych asystentów. Token Google do trenowania to nie Googlebot: „Google-Extended nie ma wpływu na uwzględnienie witryny w wyszukiwarce Google ani nie jest używany jako czynnik decydujący o pozycji w rankingu w wyszukiwarce Google”.
Trzeci rodzaj jest inny. ChatGPT-User, Claude-User, Perplexity-User i Amzn-User pobierają jedną stronę, bo ktoś poprosił asystenta o jej otwarcie, więc blokując je, odmawiasz tej osobie, a niektórzy ich operatorzy mówią, że te roboty i tak mogą ignorować robots.txt. Dlatego lista robotów powyżej trzyma je w osobnej sekcji.
GPTBotPrzestrzegaOAI-SearchBotPrzestrzegaChatGPT-UserMoże ignorowaćClaudeBotPrzestrzegaClaude-SearchBotPrzestrzegaClaude-UserPrzestrzegaPerplexityBotPrzestrzegaPerplexity-UserMoże ignorowaćGoogle-ExtendedTylko tokenBrak takiego robotaBrak takiego robotaApplebot-ExtendedTylko tokenBrak takiego robotaBrak takiego robotameta-externalagentPrzestrzegameta-webindexerPrzestrzegameta-externalfetcherMoże ignorowaćAmazonbotPrzestrzegaBrak takiego robotaAmzn-UserMoże ignorowaćProsi roboty, żeby nie pobierały strony; nie prosi wyszukiwarki, żeby jej nie wyświetlała. O zablokowanych stronach Google mówi, że „nadal może indeksować ich adresy URL i wyświetlać je w wynikach wyszukiwania bez fragmentu treści”, gdy linkują do nich inne strony. Żeby strona nie trafiła do indeksu, użyj noindex i zostaw stronę dostępną dla robotów, tak żeby tag mógł zostać odczytany.
Search Console nazywa to „Strona zindeksowana, ale zablokowana przez plik robots.txt”. A Google mówi wprost, że „aby reguła noindex działała poprawnie, nie możesz blokować strony lub zasobu w pliku robots.txt”: noindex zablokowanej strony nigdy nie zostaje odczytany, bo robot w ogóle tej strony nie pobiera.
Dlatego każdy szablon powyżej mówi, czego nie robi. Disallow: / w szablonie wersji testowej trzyma z daleka uprzejme roboty, ale adres URL wersji testowej, do którego prowadzi link z dowolnego miejsca, nadal może trafić do wyników: ukryj wersję testową za hasłem i nigdy nie przenoś tego wiersza do działającej witryny.
<meta name="robots" content="noindex">Nigdy nie zostaje odczytanyŻeby strona nie trafiła do indeksu: wpuść robota i użyj noindex albo wymagaj logowania.
W katalogu głównym hosta, którego dotyczy, jako /robots.txt, jeden plik na host i protokół. https://example.com/robots.txt nic nie mówi o https://www.example.com ani o https://shop.example.com: każdy z nich potrzebuje własnego pliku, a robots.txt w podkatalogu nigdy nie jest czytany.
Google: „Plik robots.txt musi się znajdować w katalogu głównym witryny i musi być dostępny za pomocą obsługiwanego protokołu”. Raport dotyczący pliku robots.txt w Search Console wymienia osobno pliki 20 głównych hostów w usłudze, a HTTP i HTTPS liczy oddzielnie.
Wpisz swoją witrynę na górze generatora, a poda on dokładny adres, pod którym plik musi odpowiadać, wypełni wiersz Sitemap: dla tego hosta i podlinkuje tester robots.txt, który odczyta opublikowany plik, gdy tylko będzie dostępny.
https://example.com/robots.txtKażdego adresu URL w https://example.comhttps://www.example.com/robots.txtTylko www.example.com: to osobny hosthttp://example.com/robots.txtTylko witryny http://: to osobny protokółhttps://shop.example.com/robots.txtTylko shop.example.comhttps://example.com/blog/robots.txtNiczego: robots.txt w podkatalogu nigdy nie jest czytanyGoogle nie czyta żadnej z nich. Crawl-delay czyta Bing, Clean-param Yandex, Host nie ma ani w standardzie, ani na liście Google, a Content-Signal od Cloudflare deklaruje, do czego wolno używać twoich treści, a nie co wolno skanować.
Google wymienia swoje cztery pola i dodaje, że „inne pola, np. crawl-delay, nie są obsługiwane”. Własny blog Bing mówi, że „dyrektywa crawl-delay przyjmuje jako wartości tylko dodatnie liczby całkowite”, więc edytor odrzuca ułamek, zamiast go zapisać. Aktualnej strony pomocy Bing nie udało się odczytać, żeby potwierdzić zakres lub jednostkę, więc ta strona nie podaje ani jednego, ani drugiego.
Żadna z nich nie psuje pliku: RFC 9309 stanowi, że parsowanie innych rekordów „NIE MOŻE zakłócać parsowania rekordów zdefiniowanych wprost”. Z tych czterech generator zapisuje tylko Crawl-delay, z opisem, kto ją czyta.
User-agentCzytaCzytaCzytaAllowCzytaCzytaCzytaDisallowCzytaCzytaCzytaSitemapCzytaCzytaCzytaCrawl-delayIgnorujeCzytaNiepotwierdzoneClean-paramIgnorujeIgnorujeCzytaHostIgnorujeIgnorujeNiepotwierdzonenoindexIgnorujeNiepotwierdzoneNiepotwierdzoneContent-SignalIgnorujeNiepotwierdzoneNiepotwierdzoneDwa razy. Przed publikacją w sekcji Przetestuj, zanim opublikujesz powyżej: wybierz robota i ścieżkę i zobacz regułę, która o tym decyduje. Po wgraniu uruchom tester robots.txt na opublikowanym pliku, bo to, co odpowiada serwer, liczy się tak samo jak to, co mówi plik.
Plik, który odpowiada 404, jest traktowany tak, jakby go w ogóle nie było, więc każdy robot może pobrać wszystko; plik, który odpowiada 500 lub 503, oznacza, że robot zgodny ze standardem nie może pobrać niczego. RFC 9309 §2.3.1.4: robot „MUSI przyjąć całkowity zakaz”. Google łagodzi to własną drabiną, pokazaną na rysunku.
Tester robots.txt od Google już nie istnieje: Search Central ogłosił jego wycofanie 15 listopada 2023 roku, a raport dotyczący pliku robots.txt, który go zastąpił, pokazuje plik pobrany przez Google, ale nie testuje adresu URL względem reguły. Ten test wykonują sekcja Przetestuj, zanim opublikujesz w generatorze powyżej oraz tester robots.txt.
200Przestrzega reguł z pliku.301, 302Podąża za co najmniej pięcioma skokami, potem przerywa. Google traktuje wtedy plik jak 404.403, 404Skanuje wszystko, jakby pliku nie było.429Nie skanuje niczego. Google zalicza ten kod do odpowiedzi 5xx, a nie 4xx.500, 503Według standardu nie skanuje zupełnie niczego.Nie ma takiej nazwyNie ma witryny do odczytania, więc nie ma werdyktu.Każdy z kosztownych błędów to jeden krótki wiersz: Disallow: / pozostawione po wersji testowej, prefiks sięgający dalej, niż chciałeś, wiersz Sitemap: zapisany jako ścieżka, ścieżka bez ukośnika na początku i wiersz noindex, którego Google przestał czytać w 2019 roku.
Każdy z nich zostaje tu wychwycony, zanim skopiujesz plik. Audyt testera działa w trakcie pisania, a jego uwagi są pod plikiem; wiersz, który robot by odrzucił, w ogóle nie trafia do pliku, a edytor przy danym polu mówi, dlaczego go pominięto.
Jeden błąd to para, a nie pojedynczy wiersz: adres URL zablokowany tutaj, który na stronie ma też noindex. Robot nigdy nie pobiera strony, więc nigdy nie widzi noindex, a adres URL może zostać w wynikach wyszukiwania. Wybierz jedno: zablokuj skanowanie albo wpuść robota i powiedz mu, żeby nie indeksował.
Disallow: /Pozostałość po wersji testowej: cała działająca witryna jest zamknięta dla każdego robota.Disallow: /adminBlokuje też /administrator i /admin-tools. Dodaj ukośnik na końcu.Allow: / pod User-agent: *Robot, który ma własną grupę w dowolnym miejscu pliku, nigdy tego nie czyta.Sitemap: /sitemap.xmlWiersz Sitemap musi być pełnym adresem z hostem.Disallow: adminŚcieżka zaczyna się od /. Ta reguła niczego nie dopasowuje.noindex: /private/Martwe od 2019 roku. Strona nadal może być skanowana i indeksowana.*, w której stoi twoje Allow. Edytor powyżej oznacza regułę, z którą zawsze wygrywa inna, a Przetestuj, zanim opublikujesz wskazuje decydującą regułę i grupę, którą przeczytał robot.Pobierz robots.txt dowolnej witryny, sprawdź, czy URL jest zablokowany dla Googlebot lub crawlerów AI, i znajdź błędy składni
Przeskanuj swoją stronę i pobierz sitemap XML, mapę strony HTML oraz wizualne drzewo witryny
Znajdź i zwaliduj sitemap XML witryny: składnia, limity URL, daty lastmod, konflikty z robots.txt oraz uszkodzone lub przekierowane adresy URL
Sprawdź title, meta description, canonical, hreflang oraz tagi Open Graph i X card strony, z podglądem w Google i mediach społecznościowych
Analizuj nagłówki odpowiedzi HTTP i ocenę nagłówków bezpieczeństwa
Wykryj przeglądarkę, system operacyjny, typ urządzenia, silnik renderowania i architekturę CPU z ciągu User Agent