











Dekodowanie i kodowanie Base64: na PDF, obraz lub plik
Wklej Base64 i odzyskaj plik: PDF, obraz, tekst albo JWT. Możesz też upuścić plik, żeby dostać jego Base64. Wszystko dzieje się w tej karcie.
Trzy bajty to 24 bity. Base64 tnie te same 24 bity na cztery grupy po sześć, a każda grupa wskazuje jeden z 64 znaków. Białe linie pokazują, gdzie kończą się bajty: nie pokrywają się z granicami grup i na tym polega cały trik.
16 + 2 + 1 = 19 T
Indeks 19 w alfabecie standardowym.
Jak używać dekodera i kodera Base64 online
Wklej cokolwiek do jednego pola (tekst, Base64, cały data: URI albo JWT), kliknij Wybierz plik albo upuść plik na panel. Narzędzie samo ustala, w którą stronę zamieniać, pokazuje to na etykiecie, a drugie odczytanie zostawia o jedno kliknięcie dalej.
Przy dekodowaniu pliku dostajesz typ odczytany z samych bajtów, rozmiar, rozmiar obrazu w pikselach, kartę Podgląd dla obrazu lub PDF-a i pobieranie z właściwym rozszerzeniem. Przy kodowaniu dostajesz Base64, gotowy data: URI i informację, ile kodowanie kosztowało w rozmiarze. Opcje Alfabet, Dopełnienie i Podziały wierszy pod wynikiem zmieniają dane wyjściowe.
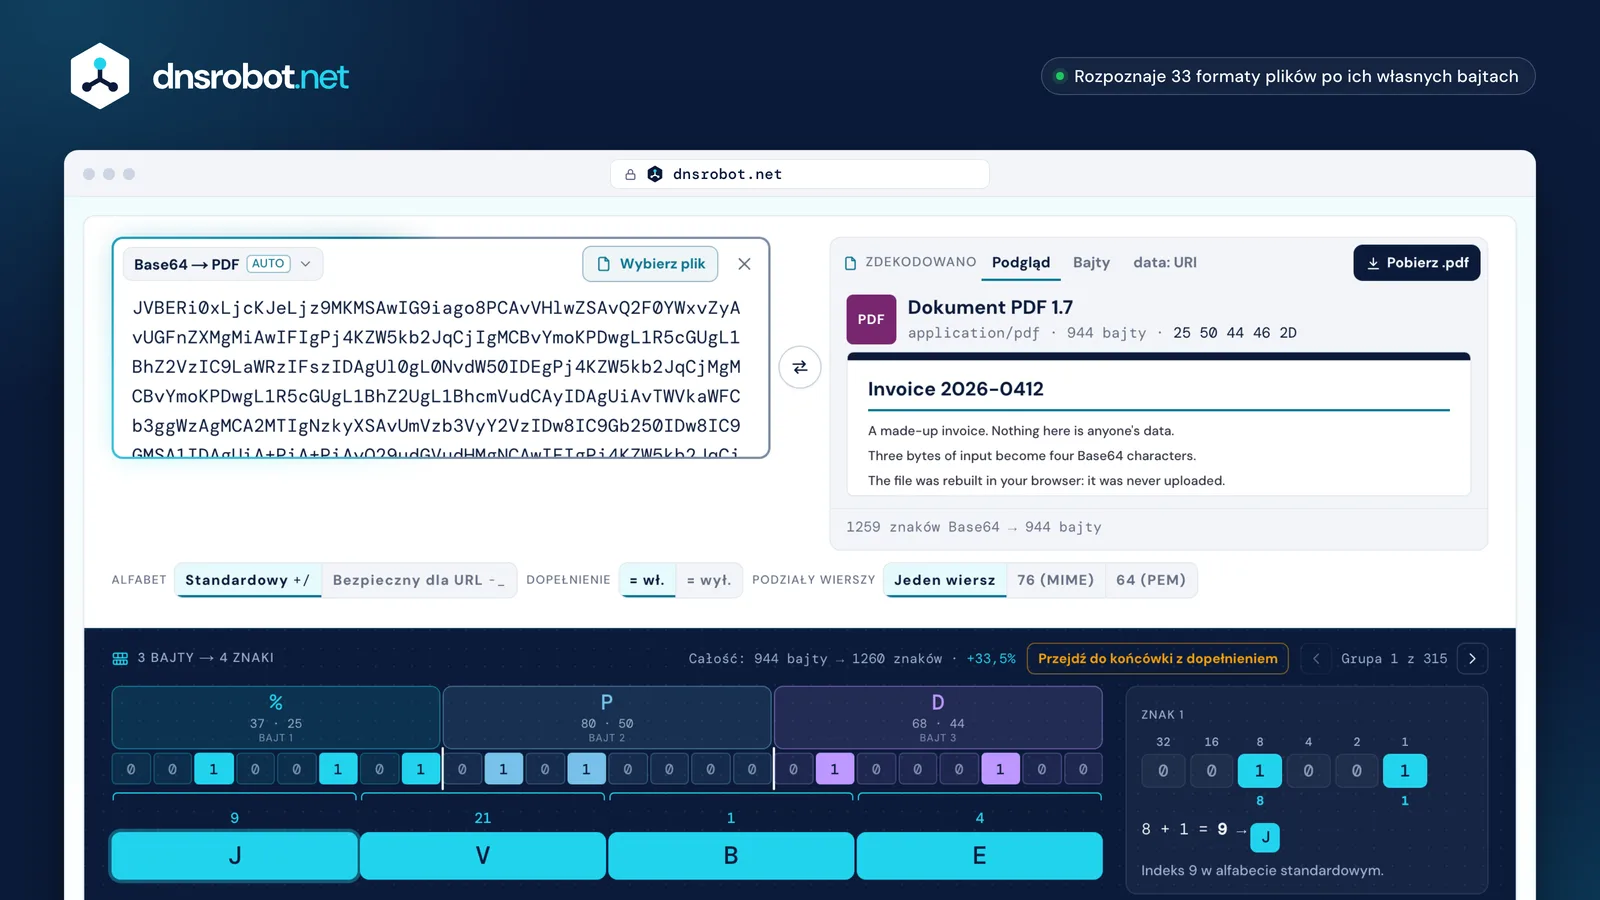
 Jedno pole w obie stronyWklej tekst, Base64, data: URI albo JWT. Etykieta pokazuje, jak to odczytano, a menu to zmienia.Wybierz plikAlbo upuść go w dowolnym miejscu panelu: stanie się Base64 i data: URI bez opuszczania karty.Czym są te bajtyPrzy dekodowaniu wynik zaczyna się od typu pliku, rozmiaru i sygnatury, a potem są podgląd i pobieranie.Opcje wynikuAlfabet standardowy lub bezpieczny dla URL, dopełnienie włączone lub wyłączone i wiersze łamane dla MIME lub PEM.3 bajty → 4 znakiTwoje własne bajty pocięte na nowo na grupy po sześć. Wskaż znak, aby zobaczyć, jak sumują się jego bity.
Czym jest Base64 i po co istnieje?
Base64 zapisuje dowolne bajty za pomocą 64 znaków, które wszędzie przechodzą bez szwanku: A–Z, a–z, 0–9, + i /. Istnieje, bo e-mail, adresy URL, JSON i XML zbudowano z myślą o tekście, a surowy bajt może być znakiem sterującym, cudzysłowem albo bajtem zerowym i je zepsuć.
Bierze po trzy bajty naraz, układa ich 24 bity w rząd i tnie ten rząd na cztery grupy po sześć. Sześć bitów mieści 64 wartości, więc każda grupa wskazuje dokładnie jeden znak. Trzy bajty na wejściu, cztery znaki na wyjściu, zawsze: dlatego Base64 jest mniej więcej o jedną trzecią większy niż dane wejściowe.
Trzy bajty to 24 bity. Base64 tnie je na nowo na cztery grupy po sześć, a każda grupa wskazuje jeden z 64 drukowalnych znaków, więc trzy bajty zawsze kosztują cztery znaki. Stąd bierze się wzrost o 33%.
Dwa bajty to 16 bitów. Base64 dodaje 2 bity zerowe, aby dokończyć trzecią grupę, a jeden = stoi w miejscu czwartego znaku.
Jeden bajt to 8 bitów. Base64 dodaje 4 bity zerowe, aby dokończyć drugą grupę, a dwa = stoją w miejscu trzeciego i czwartego znaku. = nie niesie żadnych bitów.
Jak zdekodować Base64 na PDF?
Wklej ciąg, a narzędzie odtworzy PDF: pokaże wersję i rozmiar, otworzy dokument we wbudowanym czytniku PDF twojej przeglądarki i pozwoli go pobrać. Nie musisz mówić, że to PDF, ani najpierw usuwać prefiksu data:.
PDF rozpoznaje się po pierwszych pięciu bajtach, %PDF-, więc plik zostaje zidentyfikowany nawet wtedy, gdy jego nazwa, typ podany przez nadawcę albo pole, w którym przyszedł, mówią co innego. Jeśli bajty nie są PDF-em, strona powie, czym są, zamiast bezskutecznie otwierać dokument, którego nigdy nie było.
Plik jest odtwarzany w twojej przeglądarce. Nic nie jest wysyłane, co ma znaczenie, gdy PDF to pasek wypłaty, umowa albo faktura.
"document": "JVBERi0xLjcKJeLjz9MKMS…"Pole w odpowiedzi. Cudzysłowy nie należą do Base64.Content-Transfer-Encoding: base64MIME łamie treść co 76 znaków. Wklej ją razem z podziałami wierszy: są pomijane.data:application/pdf;base64,JVBERi0x…Wklej całość. Prefiks zostanie odczytany, nie musisz go usuwać ręcznie.- 25%
- 50P
- 44D
- 46F
- 2D-
- 311
- 2E.
- 377
Pierwszych 5 bajtów, %PDF-, to cała sygnatura. Bajty od 6 do 8 to wersja: 1.7. Rozszerzenie pliku nie ma tu znaczenia, więc PDF, który ktoś nazwał .txt, i tak wraca jako PDF.
Jak zamienić obraz na Base64 i kiedy warto to robić?
Upuść obraz, a dostaniesz jego Base64 i gotowy data: URI do wklejenia w HTML lub CSS. Trudniejsze pytanie brzmi, czy warto: Base64 zawsze kosztuje mniej więcej o jedną trzecią więcej, a osadzonego obrazu nie da się buforować osobno.
W drugą stronę, z Base64 na obraz, dostajesz format, rozmiar i prawdziwy rozmiar w pikselach odczytany z nagłówka samego pliku, a nie z obrazka na ekranie, oraz pobieranie z właściwym rozszerzeniem.
- Plik na dysku12,9 kB 100%
- Jako Base6417,3 kB +33,4%
- Łamany co 76 znaków (MIME)17,5 kB +35,1%
- Plik po gzip11,7 kB -9,5%
- Base64 po gzip12,5 kB -3,2%
- pobierany raz
- buforowany przez przeglądarkę i CDN
- pobierany obok strony, a nie w jej środku
- o jedną trzecią większy przed kompresją
- buforowany tylko jako część pliku, który go zawiera
- parsowany jako część arkusza stylów lub HTML
Kompresja odzyskuje większość: po gzip Base64 jest tylko o 7% większy od spakowanego pliku. Nie odzyska jednak osobnego wpisu obrazu w pamięci podręcznej: osadzony w stronie HTML obraz jest pobierany od nowa z każdą stroną, która go zawiera.
Praktyczna zasada: osadzaj kilkaset bajtów (ikonę, odstęp, logo w e-mailu), a wszystko większe linkuj. Ten obraz PNG (12,9 kB) jest już za tą granicą.
Base64 a Base64 bezpieczny dla URL: czym się różnią?
Base64 bezpieczny dla URL (RFC 4648 §5) to to samo kodowanie z dwoma zamienionymi znakami: + zmienia się w -, a / w _. Często pomija się też dopełnienie.
Używaj go wszędzie tam, gdzie wynik trafia do adresu URL, nazwy pliku lub ciasteczka. JSON Web Token używa go we wszystkich częściach, dlatego części tokenu nigdy nie kończą się na =. To narzędzie czyta oba alfabety i mówi ci, gdy jeden ciąg zawiera znaki z obu.
+/8=-_8=-_8+→-Indeks 62. W ciągu zapytania dekoder formularzy czyta+jako spację, więc dane wracają błędne./→_Indeks 63. W ścieżce/zaczyna nowy segment, więc wartość zostaje rozcięta na dwie.=pominiętyW URL znak=zwykle koduje się procentowo jako%3D(RFC 4648 §5). JWT całkowicie go pomija (RFC 7515 §2): sama długość mówi, gdzie kończą się bajty.
Pierwsze 62 znaki obu alfabetów są identyczne, dlatego narzędzie, które czyta oba alfabety, zdekoduje każdy z nich, a ta strona mówi ci, gdy ciąg zawiera znaki z obu.
Czy Base64 to szyfrowanie? Nie.
Base64 niczego nie ukrywa. Nie ma klucza ani sekretu, a odwrócenie go nie wymaga żadnego wysiłku: dekoder taki jak ten robi to w trakcie pisania.
Najbardziej liczy się to przy uwierzytelnianiu HTTP Basic: nagłówek niesie nazwę użytkownika i hasło jako jeden ciąg Base64, czytelny dla każdego, kto go zobaczy, dlatego RFC 7617 uznaje je za bezpieczne tylko przez szyfrowane połączenie, takie jak TLS. Jeśli coś ma pozostać nieczytelne, potrzebuje szyfrowania. Base64 tylko bezpiecznie przeprowadza bajty przez kanał zbudowany dla tekstu.
Nagłówek Authorization zbudowany tak, jak opisuje RFC 7617 §2
Authorization: Basic dXNlcjpwYXNzd29yZA==user:passwordRFC 7617 buduje nagłówek krok po kroku, a ostatni krok to cała jego „ochrona”: klient „uzyskuje basic-credentials, kodując tę sekwencję oktetów za pomocą Base64”. Jego §1 mówi, co to oznacza: jeśli połączenia nie chroni TLS lub podobny system, „identyfikator użytkownika i hasło są przesyłane przez sieć jako tekst jawny”. Base64 nie ma klucza, więc nie ma czego łamać: kto ma ten ciąg, ten ma hasło.
Dlaczego zdekodowany tekst wygląda jak krzaki?
Bo Base64 przenosi bajty, a bajty stają się literami dopiero wtedy, gdy coś wybierze kodowanie znaków. Odczytaj tekst w UTF-8 tak, jakby był w ISO-8859-1, a é zamieni się w é; odczytaj ISO-8859-1 jako UTF-8, a pojawi się znak zastępczy.
data: URI może deklarować swój zestaw znaków, a ta strona czyta tekst właśnie w nim, zamiast przepuszczać wszystko przez UTF-8. Gdy twoja przeglądarka nie ma dekodera dla zadeklarowanego zestawu, strona mówi o tym wprost, zamiast po cichu pokazywać złe litery.
W UTF-8 é to 2 bajty, a w ISO-8859-1 to 1 bajt. Base64 przenosi bajty, nie litery, więc sam ciąg nie powie dekoderowi, o które kodowanie chodziło.
Base64 w Pythonie, JavaScripcie, Javie, C#, Go, PowerShellu i w terminalu
Każdy język ma Base64 wbudowane. Pułapki są wszędzie te same: koduj bajty, a nie napis, i podawaj, w jakim kodowaniu znaków jest tekst.
Najostrzejszą krawędzią jest btoa() w JavaScripcie: przyjmuje tylko znaki do U+00FF, więc wszystko spoza Latin-1 trzeba najpierw zamienić na bajty UTF-8 za pomocą TextEncoder. Każdy przykład poniżej koduje i dekoduje „Man” i został uruchomiony, żeby sprawdzić jego wynik.
import base64

b64 = base64.b64encode("Man".encode("utf-8")).decode("ascii")
print(b64)                                    # TWFu
print(base64.b64decode(b64).decode("utf-8"))  # Man
Uruchomiono 26 października 2026: Python 3.14.4 wypisuje to, co pokazują komentarze.
const bytes = new TextEncoder().encode("Man");
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);                                   // TWFu
const back = Uint8Array.from(atob(b64), (c) => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));        // Man
Uruchomiono 26 października 2026: Node.js 22.23.2 wypisuje to, co pokazują komentarze.
import java.util.Base64;
import static java.nio.charset.StandardCharsets.UTF_8;

public class Main {
    public static void main(String[] args) {
        String b64 = Base64.getEncoder().encodeToString("Man".getBytes(UTF_8));
        System.out.println(b64);                      // TWFu
        byte[] back = Base64.getDecoder().decode(b64);
        System.out.println(new String(back, UTF_8));  // Man
    }
}
Uruchomiono 26 października 2026: OpenJDK 25.0.2 wypisuje to, co pokazują komentarze.
using System.Text;

var b64 = Convert.ToBase64String(Encoding.UTF8.GetBytes("Man"));
Console.WriteLine(b64);                            // TWFu
var back = Convert.FromBase64String(b64);
Console.WriteLine(Encoding.UTF8.GetString(back));  // Man
Uruchomiono 26 października 2026: .NET 10.0.103 wypisuje to, co pokazują komentarze.
package main

import (
	"encoding/base64"
	"fmt"
)

func main() {
	b64 := base64.StdEncoding.EncodeToString([]byte("Man"))
	fmt.Println(b64) // TWFu
	back, _ := base64.StdEncoding.DecodeString(b64)
	fmt.Println(string(back)) // Man
}
Uruchomiono 26 października 2026: Go 1.25.5 wypisuje to, co pokazują komentarze.
$b64 = [Convert]::ToBase64String([Text.Encoding]::UTF8.GetBytes('Man'))
$b64                                                                # TWFu
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($b64))  # Man
Uruchomiono 26 października 2026: PowerShell 7.5.5 wypisuje to, co pokazują komentarze.
printf 'Man' | base64        # TWFu
printf 'TWFu' | base64 -d    # Man
echo 'Man' | base64          # TWFuCg== (echo adds a newline)
Uruchomiono 26 października 2026: polecenie base64 w macOS 26.6 (bash) wypisuje to, co pokazują komentarze.
base64 -d jest -D. Źródło: gnu.org, developer.mozilla.orgAlfabet Base64 od 0 do 63
Każda grupa sześciu bitów to liczba od 0 do 63, a to jest tabela, w której się ją wyszukuje. Base64 rozróżnia wielkość liter: A to 0, a a to 26, więc zmiana wielkości litery psuje ciąg.
Warto rozpoznawać go na oko: ciąg samych A to ciąg zerowych bajtów, a ciąg Base64 zaczynający się od JVBER to PDF, od iVBOR PNG, a od /9j/ JPEG.
- A0
- B1
- C2
- D3
- E4
- F5
- G6
- H7
- I8
- J9
- K10
- L11
- M12
- N13
- O14
- P15
- Q16
- R17
- S18
- T19
- U20
- V21
- W22
- X23
- Y24
- Z25
- a26
- b27
- c28
- d29
- e30
- f31
- g32
- h33
- i34
- j35
- k36
- l37
- m38
- n39
- o40
- p41
- q42
- r43
- s44
- t45
- u46
- v47
- w48
- x49
- y50
- z51
- 052
- 153
- 254
- 355
- 456
- 557
- 658
- 759
- 860
- 961
- +Bezpieczny dla URL: -62
- /Bezpieczny dla URL: _63
0–25 to A–Z, 26–51 to a–z, 52–61 to 0–9. Oba alfabety różnią się tylko dwoma ostatnimi znakami tabeli, oznaczonymi powyżej. = w ogóle nie ma w tabeli: to nie wartość, tylko znak, że ostatnia grupa trzech bajtów była niepełna.
Base64: pytania i odpowiedzi
Czym jest dekodowanie Base64?
Jak zdekodować plik Base64?
Do czego służy Base64?
data: URI w HTML i CSS, pola binarne w JSON i XML, JSON Web Token, uwierzytelnianie HTTP Basic oraz certyfikaty i klucze w plikach PEM. W każdym z tych przypadków dane muszą przejść przez kanał, który mógłby zmienić lub zgubić surowe bajty, więc podróżują jako zwykłe litery i cyfry.Czy Base64 to szyfrowanie?
Czy dekodowanie Base64 online jest bezpieczne?
Dlaczego Base64 jest o 33% większy od oryginału?
=, a łamanie wierszy co 76 znaków na potrzeby poczty dodaje podział do każdego wiersza, więc długi ciąg jest często mniej więcej o 35% większy od bajtów, które niesie. Kompresja, na przykład gzip, odzyskuje większość tej różnicy.Czym jest Base64 bezpieczny dla URL?
+ zastąpiono znakiem -, a / znakiem _, zgodnie z definicją w RFC 4648 §5, aby wynik mógł trafić do adresu URL, nazwy pliku lub ciasteczka bez escapowania. Dopełnienie zwykle też się pomija, jak w JSON Web Token. To narzędzie czyta oba alfabety, nawet wymieszane w jednym ciągu, i potrafi zapisać każdy z nich.Dlaczego dekodowanie Base64 się nie udaje?
Czy mogę zamienić Base64 na obraz?
data:image/png;base64, albo bez niego, a obraz pojawi się z formatem, rozmiarem i prawdziwym rozmiarem w pikselach odczytanym z nagłówka samego pliku. Potem pobierz go z właściwym rozszerzeniem. PNG, JPEG, GIF, WebP, BMP, ICO i AVIF mają podgląd; SVG jest najpierw pokazywany jako tekst, bo SVG może zawierać skrypt.Co oznacza = na końcu Base64?
=, a jeden pozostały bajt dwoma znakami i ==. Dopełnienie nie niesie żadnych danych: mówi tylko dekoderowi, gdzie kończą się bajty. Wiele dekoderów, w tym ten, czyta też Base64, w którym dopełnienie pominięto.Czy jest limit rozmiaru?
Czy mogę tu zdekodować JWT?
iat i exp oraz podpisem pokazanym jako bajty. Ta strona tylko dekoduje trzy części base64url: nie weryfikuje podpisu i nigdy nie mówi, że token jest ważny, więc nie używaj jej, by zdecydować, czy mu ufać.Czegoś brakuje?Zaproponuj funkcję lub nowe narzędzie
Podobne narzędzia
Tłumacz Binarny
Zamieniaj tekst na kod binarny i kod binarny na tekst: autowykrywanie, hex, system dziesiętny i ósemkowy
Generator UUID
Generuj masowo UUID v4, v7, v1, v5 i v3 lub GUID w dowolnym formacie i dekoduj wersję oraz znacznik czasu UUID
Dekoder CSR i Certyfikatów
Dekoduj CSR lub certyfikat SSL: podmiot, SAN, rozmiar klucza, ważność, wystawca, odcisk palca, weryfikacja podpisu i zgodność CSR z certyfikatem
Niewidzialny Znak
Kopiuj i wklejaj niewidzialny znak lub pustą spację oraz znajduj i usuwaj ukryte znaki w tekście
Konwerter Timestamp
Zamieniaj Unix timestamp na datę i datę na czas epoch w dowolnej strefie czasowej, także wsadowo