











사이트맵 검사기
도메인이나 sitemap.xml, sitemap_index.xml 같은 사이트맵 URL을 붙여 넣으면 전체 그림을 보여 줍니다. 인덱스 안의 모든 파일, 프로토콜이 정한 모든 규칙, 검색엔진이 거부할 URL과 그 이유, 그리고 날짜에 의미가 있는지까지 확인합니다.
도메인만 입력해도 됩니다. robots.txt를 읽고 일반적인 위치를 찾아봅니다. example.com/sitemap.xml처럼 파일 주소를 입력해도 됩니다.
- robots.txt가장 먼저 읽고, 그 의미까지
- 사이트맵robots.txt, 그다음 일반적인 경로
- 읽은 파일인덱스와 그 안의 파일 10개
- 검사모든 규칙, robots.txt와 대조
XML 사이트맵을 확인하는 방법
위에 도메인을 입력하고 “사이트맵 검사”를 선택하세요. robots.txt를 읽고, 거기에 적힌 파일을 찾아 그 파일과, 그 안의 파일 중 최대 10개를 읽은 뒤, URL을 고르게 골라 가져와서, 검색엔진이 이 모든 것을 어떻게 받아들일지 보여 줍니다.
도메인만 입력해도 되고, 파일 자체의 주소를 입력해도 됩니다. 도메인이면 먼저 robots.txt의 Sitemap: 줄을 읽고, 그다음 일반적인 경로를 시도합니다. 주소면 입력한 그대로를 읽습니다. 어느 쪽이든 처음 100개 URL이 아니라 파일 전체를 읽으며, 사이트맵 인덱스라면 그 안의 파일도 최대 10개까지 함께 읽습니다.
사이트맵이 제 역할을 하는지는 네 가지로 결정됩니다. 파일이 파싱되는지, 프로토콜의 한도 안에 있는지, robots.txt나 페이지 자체의 noindex와 모순되는 것이 없는지, 그리고 날짜에 의미가 있는지입니다. 위의 보기가 이를 다룹니다. 형식과 한도는 파일과 문제, 모순은 robots.txt와 샘플 페이지, 날짜는 URL에서 확인하세요.
200sitemap_index.xml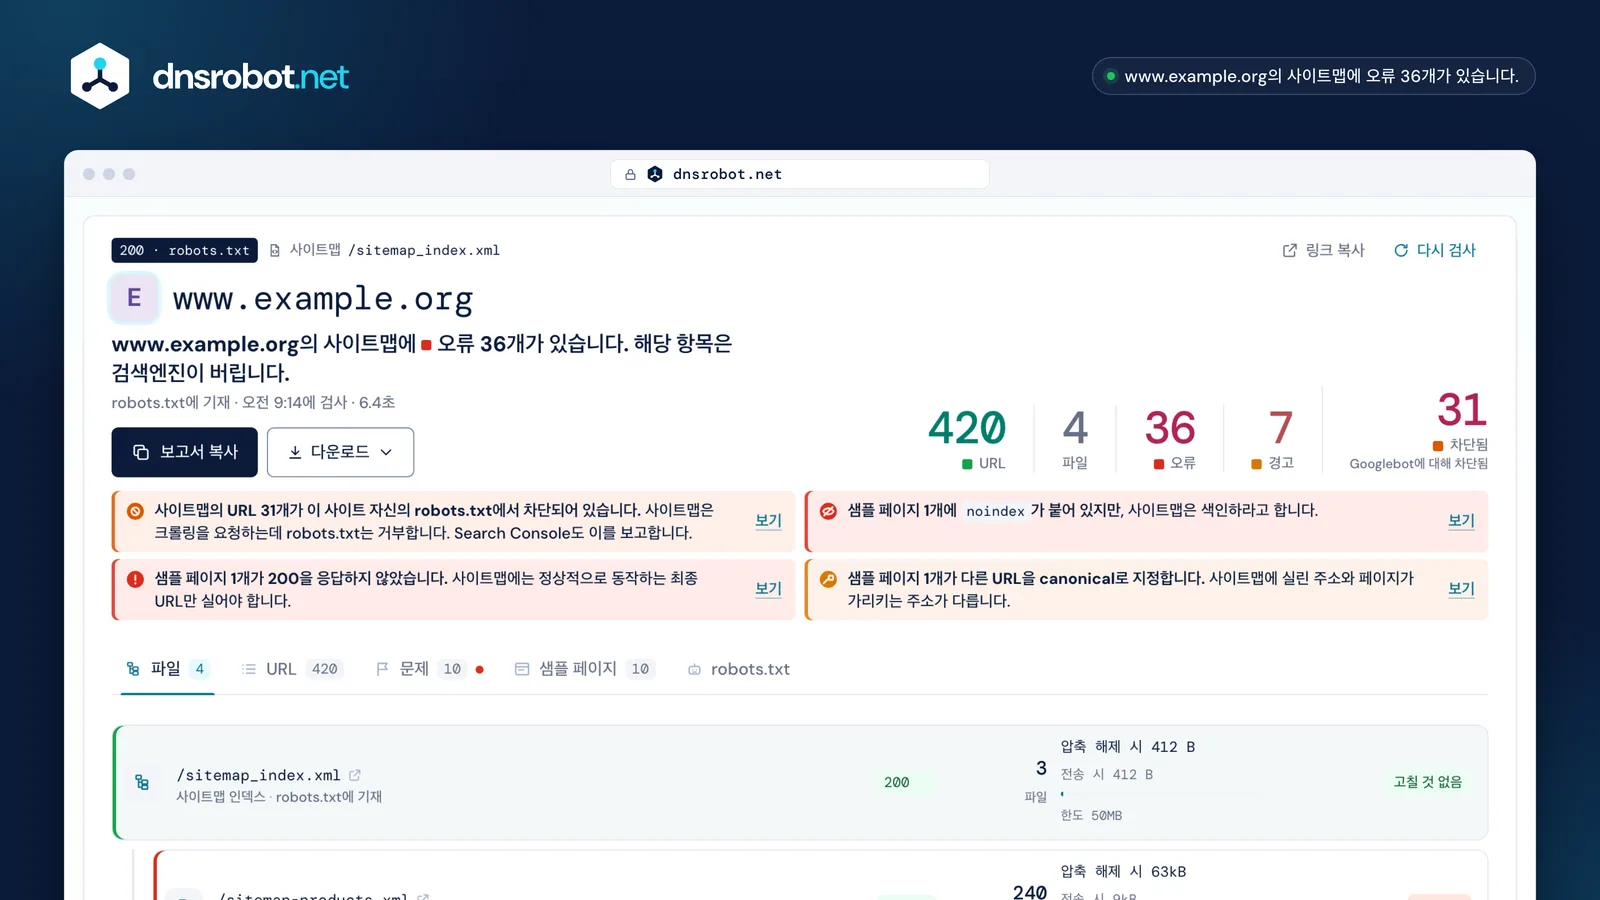
 판정이 사이트맵의 문제를 한 문장으로 보여 주고, 그것을 뒷받침하는 다섯 숫자를 붙입니다. URL, 파일, 오류, 경고, 그리고 robots.txt가 거부하는 URL입니다.robots.txt와 그 결과상태 코드만이 아니라, 그것이 사이트 전체에 뜻하는 바를 보여 줍니다. 4xx면 모든 것을 크롤링할 수 있고, 5xx면 아무것도 크롤링해서는 안 됩니다.인덱스의 모든 파일각 파일에 담긴 URL 수, 50 MB 한도와 비교한 압축 해제 후 크기, 그 옆의 전송 크기, 그리고 파일 자체의 지적 사항입니다.모순사이트맵이 검색엔진에 크롤링을 요청하는데 robots.txt가 거부하는 URL, 그리고 noindex가 붙어 있거나 다른 URL을 canonical로 지정한 샘플 페이지입니다.
사이트맵이 무효가 되는 원인
파서가 읽을 수 없을 때 사이트맵은 무효가 됩니다. 이스케이프되지 않은 &, 잘못된 루트 요소, 빠진 네임스페이스, 상대 URL, XML 선언 앞에 출력된 공백 같은 것들입니다. 그 밖의 것은 경고일 뿐, 거부되지는 않습니다.
가장 흔한 것은 이스케이프되지 않은 앰퍼샌드입니다. XML은 &를 문자 참조의 시작으로 읽으므로, 이스케이프되지 않은 것이 하나만 있어도 파서에게는 거기서 파일이 끝나고 그 뒤는 읽히지 않습니다. &로 쓰고, <, >, ", '도 같은 방식으로 이스케이프하세요(sitemaps.org). <loc>은 프로토콜로 시작하고 2,048자 미만인 전체 URL이어야 합니다.
네임스페이스는 정확히 http://www.sitemaps.org/schemas/sitemap/0.9여야 하며, https 사이트에서도 http:// 그대로입니다. 파서를 위한 이름일 뿐, 누가 가져가는 주소가 아니기 때문입니다. 파일은 UTF-8이어야 하고, <?xml 앞에는 빈 줄 하나라도 와서는 안 됩니다. 그 자리에 허용되는 것은 UTF-8 바이트 순서 표시(BOM) 하나뿐입니다.
- 1
1 - 2
<?xml version="1.0" encoding="UTF-8"?> - 3
<urlset xmlns="http://sitemaps.org/schemas/sitemap/0.9">2 - 4
<url> - 5
<loc>https://www.example.org/shop/?size=l&colour=blue</loc>3 - 6
</url> - 7
<url> - 8
<loc>/guides/raised-beds/</loc>4 - 9
<lastmod>2026-09-14T08:30:00</lastmod>5 - 10
</url> - 11
</urlset>
- 1선언 앞의 빈 줄
- 2네임스페이스는 정확히 이 문자열, http://로
- 3이스케이프되지 않은 &는 파서에게 파일의 끝
- 4경로는 URL이 아님: 프로토콜로 시작해야 함
- 5시각에는 시간대가 필요하며, 아니면 시각을 빼기
Search Console 사이트맵 오류: ‘가져올 수 없음’ 등 각 메시지의 의미
Google Search Console은 사이트맵에 성공, 오류 발생, 가져올 수 없음의 세 가지 상태 중 하나를 표시합니다. 다만 소유 확인을 마친 속성에서만 볼 수 있고, 어느 줄이 잘못되었는지는 알려 주지 않습니다. 이 페이지는 공개된 사이트맵이라면 무엇이든 검사하고, 해당 줄을 짚어 줍니다.
가져올 수 없음은 Google의 요청에 읽을 수 있는 파일이 돌아오지 않았다는 뜻입니다. 4xx나 5xx, 리다이렉트 체인, 시간 초과, Google을 거부하는 방화벽, 또는 사이트맵 자체의 경로를 차단하는 robots.txt 규칙 때문입니다. 오류 발생은 파일은 읽혔지만 그 안의 무언가가 규칙을 어겼다는 뜻입니다. 옆의 그림에 가장 자주 보게 될 메시지와 각 메시지의 원인이 되는 줄을 정리했습니다.
그중 두 가지는 형식이 아니라 크기에 관한 것입니다. URL을 50,000개 넘게 실은 사이트맵(“URL이 너무 많음”)과, 사이트맵을 50,000개 넘게 실은 사이트맵 인덱스(“사이트맵이 너무 많음”)입니다(Google). 너무 큰 사이트맵은 인덱스에 실은 여러 파일로 나누고, 너무 큰 인덱스는 여러 인덱스로 나눠 각각 따로 제출하세요. robots.txt가 차단한 URL이 실린 사이트맵도 보고되는데, 이것은 형식 오류가 아니라 내 파일들 사이의 모순입니다.
세 가지 상태
가장 자주 보게 될 메시지
- 가져올 수 없음4xx나 5xx, 리다이렉트 체인, 방화벽, 또는 사이트맵 자체의 경로를 차단하는 robots.txt.
- URL이 너무 많음사이트맵 하나에 URL이 50,000개 넘게 있음: 경고가 아니라 오류입니다. 인덱스 아래로 나누세요.
- 구문분석 오류URL 안의 이스케이프되지 않은 &가 원인인 경우가 많습니다. &로 쓰세요.
- 날짜가 잘못되었습니다W3C Datetime 형식이 아닌 lastmod, 또는 시간대가 없는 시각.
- 잘못된 URL공백, 따옴표처럼 URL에 넣을 수 없는 문자, 또는 htp:// 같은 잘못된 스킴.
- 사이트맵에 robots.txt에 의해 차단된 URL이 포함되어 있음두 파일이 서로 모순됩니다. 어느 쪽이 맞는지 정하세요.
소유 확인을 마친 속성만Search Console은 내가 소유한 속성의 사이트맵만 보고합니다. 이 페이지는 공개된 사이트맵이라면 무엇이든 검사하고, 해당 줄을 짚어 줍니다.
lastmod는 정확해야 하나요?
네. Google은 <lastmod> 값을 “일관되고 정확성을 검증할 수 있는 경우”에 사용합니다. 그래서 모든 URL에서 같은 날짜나, 파일을 쓸 때마다 바뀌는 날짜는 날짜가 없는 것보다 나쁩니다. Google에 이 태그를 무시하라고 가르치는 셈이기 때문입니다.
다른 사이트맵 검사기는 날짜의 형식만 봅니다. W3C Datetime인지, 시각에 시간대가 붙었는지입니다. 형식은 쉬운 절반입니다. 태그가 효과를 낼지를 결정하는 질문은 그 값이 주장하는 바를 정말로 뜻하는지이며, 이를 드러내는 두 가지 신호는 모든 항목에 반복되는 같은 타임스탬프와 늘 오늘인 날짜입니다. Bing도 lastmod로 크롤링 일정을 잡으며, 늘 현재인 날짜는 무시할 수 있습니다.
그래서 이 검사기는 날짜가 어떻게 적혔는지뿐 아니라 실제로 어떤지를 보고합니다. 날짜가 있는 항목 수, 가장 오래된 날짜와 가장 최근 날짜, 그리고 같은 값의 반복인지입니다. <lastmod>를 빼는 것은 유효하며 잃는 것이 없습니다. 날짜를 지어내면 사이트 전체에서 이 태그의 신뢰를 잃습니다. 저작권 연도를 새로 적은 것이 아니라 본문, 구조화된 데이터, 링크 같은 마지막 중요한 변경을 표시하세요(Google).
lastmod가 전혀 없음유효합니다. 일정을 잡을 근거도 없고, 의심받을 날짜도 없습니다.
URL 50,000개와 50 MB: sitemap_index.xml로 나눠야 할 때
사이트맵 하나에는 URL 50,000개, 압축하지 않은 상태로 50 MB까지 담을 수 있습니다. 둘 중 먼저 닿는 한도를 넘으면 URL을 여러 파일로 나누고, 그 파일들을 사이트맵 인덱스에 실은 뒤, 인덱스를 제출하세요.
크기 한도는 .xml.gz로 제공하더라도 압축을 푼 파일을 기준으로 합니다. 그래서 이 검사기는 압축 해제 후 크기와 전송 크기를 나란히 보여 줍니다. gzip으로 제공되는 30 KB 사이트맵은 전송 시 1.6 KB로 보일 수 있지만, 그 숫자는 한도에 대해 아무것도 알려 주지 않습니다. Naver Search Advisor는 10 MB가 넘는 파일을 받지 않으므로, 한국 사이트는 프로토콜보다 낮은 한도를 적용받습니다.
인덱스에는 사이트맵을 최대 50,000개까지, 같은 사이트의 파일만 실을 수 있으며, 다른 인덱스는 절대 실을 수 없습니다. 중첩된 인덱스는 읽히지 않습니다. xhtml:link로 적은 언어 대체 URL은 50,000개에 포함되지 않습니다. 이 검사기는 한 번에 인덱스와 그 안의 파일을 최대 10개까지 읽고, 파일마다 URL 수, 크기, 지적 사항을 보여 줍니다.
6.2MB전송 시812kBgzip으로 보내면 파일이 작아지지만, 한도는 압축을 푼 뒤의 크기로 셉니다.sitemap_index.xml인덱스에 다른 인덱스는 실을 수 없음robots.txt와 사이트맵: 페이지를 잃게 만드는 모순
사이트맵은 검색엔진에 URL 목록을 크롤링해 달라고 요청하고, robots.txt는 크롤링해서는 안 되는 것을 알려 줍니다. 둘이 어긋나면 robots.txt가 이기고 사이트맵 항목은 헛것이 됩니다. 그리고 Search Console이 이를 보고합니다.
가장 먼저 읽어야 할 것은 robots.txt 자체의 상태이지만, 그것이 무엇을 뜻하는지 알려 주는 도구는 거의 없습니다. 4xx는 “사용할 수 없음”입니다. 규칙이 없으므로 모든 것을 크롤링할 수 있습니다. 5xx나 아예 응답이 없는 것은 “도달할 수 없음”이며, RFC 9309를 따르는 크롤러는 그때 사이트에서 아무것도 크롤링해서는 안 됩니다. Google은 429도 같은 방식으로 읽습니다. 같은 고장 난 파일이 정반대의 결과를 낳으므로, 읽을 수 없는 robots.txt 위에 “차단된 URL 없음”이라고 표시하는 도구는 파일이 5xx나 429를 응답했거나 아예 응답하지 않았을 때마다 틀린 것입니다.
그다음은 정상적인 파일 안의 모순입니다. 사이트맵에 실렸지만 robots.txt가 차단한 URL, 그리고 놓치기 쉬운 것으로, 사이트맵 자체의 경로가 차단된 경우입니다. 이는 어떤 크롤러도 읽을 수 없는 파일을 공개하는 셈입니다. 반대 방향은 손쉽고 해 둘 만합니다. robots.txt의 Sitemap: 줄은 어디에도 계정이 필요 없고, 모든 크롤러가 읽습니다.
상태 코드와 그 결과
모순
/search/?q=pepperDisallow: /search/그 항목은 아무 역할도 하지 않고, Search Console이 이를 보고함
게다가 사이트맵 자체의 경로가 차단되면: 어떤 크롤러도 읽을 수 없는 파일을 공개한 셈입니다.
사이트맵에 넣으면 안 되는 URL
검색 결과에 내보내고 싶은 정규 URL만, 페이지당 하나씩 넣습니다. 200을 응답하고, 색인 가능하며, robots.txt에 차단되지 않은 최종 주소입니다. 리다이렉트, noindex 페이지, 다른 곳을 canonical로 지정한 URL, 오류, 파라미터 변형은 모두 사이트맵 밖에 두어야 합니다.
리다이렉트하는 URL을 실은 사이트맵은 크롤러가 가지 않아도 될 한 단계를 더 가게 만들며, Google은 대신 리다이렉트가 끝나는 URL을 실으라고 합니다. 사이트맵에 있는 noindex 페이지는 명백한 모순입니다. 파일은 “색인해 달라”고 하고, 페이지는 “하지 말라”고 합니다. 페이지가 이기고, 그 항목은 아무 역할도 하지 않습니다.
어느 것도 치명적이지는 않습니다. 사이트맵의 모든 URL은 제안일 뿐이고, 무엇을 색인할지는 여전히 Google이 정합니다. 하지만 잘못된 항목 하나하나가 검색엔진이 낮춰 보게 되는 항목입니다. 그래서 이 검사기는 파일을 파싱하는 데 그치지 않고 URL을 고르게 골라 가져옵니다. 파싱만으로는 목록에 있는 페이지가 지금 404를 응답한다는 것을 알 수 없습니다.
/shop/raised-beds/유효실린 그대로 색인/shop/raised-bed/리다이렉트헛됨/shop/?sort=pricecanonical이 다른 URL헛됨/tags/autumn/noindex헛됨/shop/old-kit/404헛됨/search/?q=pepper차단됨헛됨이미지, 동영상, hreflang 항목
<url> 항목에는 주소 말고도 더 담을 수 있습니다. 페이지의 이미지, 다른 언어 버전, 동영상이나 뉴스 메타데이터이며, 각각 그 항목 안에서 고유한 네임스페이스를 씁니다.
이미지는 Google의 이미지 네임스페이스를 쓰며, 페이지당 최대 1,000개입니다. 지금도 의미가 있는 것은 <image:image>와 <image:loc>뿐이고, caption, title, license, geo_location은 2022년에 폐지되었습니다. 이 검사기는 찾은 이미지 항목을 세고, URL마다 보여 줍니다.
언어 버전은 hreflang 코드와 함께 xhtml:link로 적습니다. 코드는 ISO 639-1 언어에 ISO 3166-1 지역을 선택적으로 붙인 것이며, 지역만 적을 수는 없습니다. 각 버전은 자기 자신을 포함한 모든 버전을 실어야 하며, 그렇지 않으면 Google이 그 묶음을 무시합니다. 대체 URL은 URL 50,000개 한도에 포함되지 않으므로, 항목마다 12개 언어 버전을 적어도 개수가 12배로 늘지 않습니다.
https://www.example.org/guides/raised-beds/2026-09-143페이지당 최대 1,000개en · de · fr모든 버전이 자신을 포함한 모든 버전을 실음대체 URL은 50,000개에 포함되지 않음
검색엔진은 사이트맵을 얼마나 자주 읽나요?
Google은 공개하지 않은 자체 일정에 따라 사이트맵을 읽습니다. 제출은 힌트이지 명령이 아닙니다. Bing은 사이트맵을 찾는 즉시 읽고, 그 뒤로는 보통 하루에 한 번 이상 읽습니다. 둘 다 요청한다고 해서 파일을 더 자주 다시 읽지는 않습니다.
예전의 익명 ping은 사라졌습니다. Bing은 2022년 5월 13일에 bing.com/ping을 껐고, Google은 2023년 6월에 자사 ping이 더는 동작하지 않을 것이라고 발표했습니다. 지금은 404를 응답합니다. 아직도 “Google에 ping 보내기”를 내세우는 도구는 아무 일도 하지 않습니다.
바뀐 페이지의 다음 크롤링을 앞당기는 것은 정확한 lastmod입니다. 이 태그의 정직성이 중요한 이유가 바로 이것입니다. 그리고 바뀐 개별 URL에는 IndexNow가 있습니다. 한 번 보내면 Bing, Yandex, 네이버, Seznam 등에 닿지만, Google에는 닿지 않습니다. 바뀌지 않은 사이트맵을 손으로 다시 제출해도 아무것도 달라지지 않습니다.
정확한 lastmod는 바뀐 페이지의 다음 크롤링을 앞당김
사이트맵이 꼭 필요한가요?
모든 페이지가 서로 링크된 작은 사이트라면 없어도 될 수 있습니다. Google은 그 기준을 약 500페이지 이하로 봅니다. 큰 사이트, 외부 링크가 적은 새 사이트, 이미지나 동영상이 많은 사이트가 가장 큰 도움을 받습니다.
Google의 SEO 기본 가이드도 사이트맵을 선택 사항이라고 하며, 제출은 지시가 아니라 힌트입니다. 페이지 순위를 올려 주지도, 색인을 보장하지도 않습니다. 사이트맵이 하는 일은 크롤러가 URL의 존재를 확실히 알게 하는 것이며, 이는 내 사이트의 링크가 닿지 않는 페이지에서 가장 중요합니다.
사이트맵이 있다면 정확하게 만들어 둘 가치가 있습니다. 리다이렉트, noindex 페이지, robots.txt가 차단한 URL로 가득한 사이트맵은 중립적이지 않습니다. 검색엔진이 점점 덜 신뢰하게 되는 목록입니다. 검사는 1분이면 되고, 내 사이트로 새 사이트맵을 만드는 것은 크롤링 한 번이면 됩니다.
출처
- sitemaps.org 프로토콜과 FAQ: 형식, 필수 태그와 선택 태그, 50,000개 / 50 MB 한도, 인덱스, 위치 규칙
- Google 검색 센터: 사이트맵 만들기, 대규모 사이트맵, 사이트맵 보고서와 그 오류, 현지화된 버전, lastmod와 폐지된 ping
- Bing: lastmod 태그(2023년), AI 검색 시대의 사이트맵(2025년), 폐지된 ping(2022년)
- RFC 9309, robots.txt 표준: 4xx와 5xx가 크롤러에게 뜻하는 것
- Naver Search Advisor: 피드와 IndexNow
- 큰 사이트
- 외부 링크가 적은 새 사이트
- 이미지나 동영상이 많음
- 내부 링크가 닿지 않는 페이지
사이트맵 검사기 자주 묻는 질문
XML 사이트맵이 유효한지 어떻게 확인하나요?
가장 흔한 사이트맵 오류는 무엇인가요?
Search Console에서 사이트맵을 “가져올 수 없음”이라고 표시하는 이유는 무엇인가요?
사이트맵의 URL이 robots.txt에서 차단되어 있으면 문제가 되나요?
lastmod는 정확해야 하나요?
사이트맵 하나에 URL을 몇 개까지 넣을 수 있나요?
Google은 priority와 changefreq를 사용하나요?
이 사이트맵 검사기는 무료인가요? URL 제한이 있나요?
Google Search Console과 무엇이 다른가요?
사이트맵 인덱스란 무엇이고, 다른 인덱스를 실을 수 있나요?
사이트맵을 robots.txt에 꼭 적어야 하나요?
사이트맵이 있으면 페이지가 색인되나요?
부족한 점이 있습니까?기능 또는 새 도구 제안하기
더 많은 크롤링·SEO 도구
Robots.txt 검사기
사이트의 robots.txt를 가져와 URL이 Googlebot이나 AI 크롤러에 차단되는지 테스트하고 구문 오류 찾기
사이트맵 생성기
웹사이트를 크롤링하여 XML 사이트맵, HTML 사이트맵, 사이트 구조도 생성
링크 분석
dofollow/nofollow 감지 및 HTTP 상태 확인으로 페이지 내 링크 분석
리다이렉트 확인
SEO를 위한 URL 리다이렉트, 리다이렉트 체인, HTTP 상태 코드 확인
HTTP 헤더 검사
HTTP 응답 헤더 분석 및 보안 헤더 등급 평가
사이트 접속 확인
모두에게 다운됐나요, 나만 안 되나요? 11개 지역과 내 연결에서 사이트를 확인하고 실시간 스크린샷을 봅니다
CMS 확인 도구
웹사이트가 쓰는 CMS·테마·플러그인·기술을 각각의 근거와 함께 확인