











바이너리 번역기
텍스트와 바이너리 코드를 입력하는 대로 변환하고, 글자마다 비트를 보여 줍니다.
자릿값
64 + 8 = 72 → H
- 1
- 0
- UTF-8 표시 비트
글자를 가리키거나 커서를 옮기면 아래에서 그 비트가 더해집니다.글자를 누르면 그 비트가 더해지는 모습을 볼 수 있습니다.
브라우저 안에서 변환하므로 입력한 내용은 어디에도 전송되지 않습니다.
바이너리 번역기 사용법
텍스트를 입력하면 바이너리 코드로, 바이너리 코드를 붙여넣으면 다시 텍스트로 바뀝니다. 이 바이너리 변환기는 입력하는 대로 바로 변환하며, 결과 위의 표시가 입력을 어떻게 읽었는지 알려 줍니다.
바이너리는 공백이 있든 없든, 7비트 묶음이든 앞에 0b가 붙어 있든 붙여넣을 수 있고, 48 69 같은 16진수, 72 105 같은 10진수 바이트, U+0048 같은 코드 포인트도 읽습니다. 출력은 이진수, 16진수, 10진수, 8진수 중에서 고르고, 구분자와 바이트당 8비트 또는 7비트를 정한 뒤 복사하거나 다운로드하세요. 아래 바이트 줄은 모든 글자의 바이트를 보여 주며, 하나를 선택하면 그 비트를 더해 볼 수 있습니다.
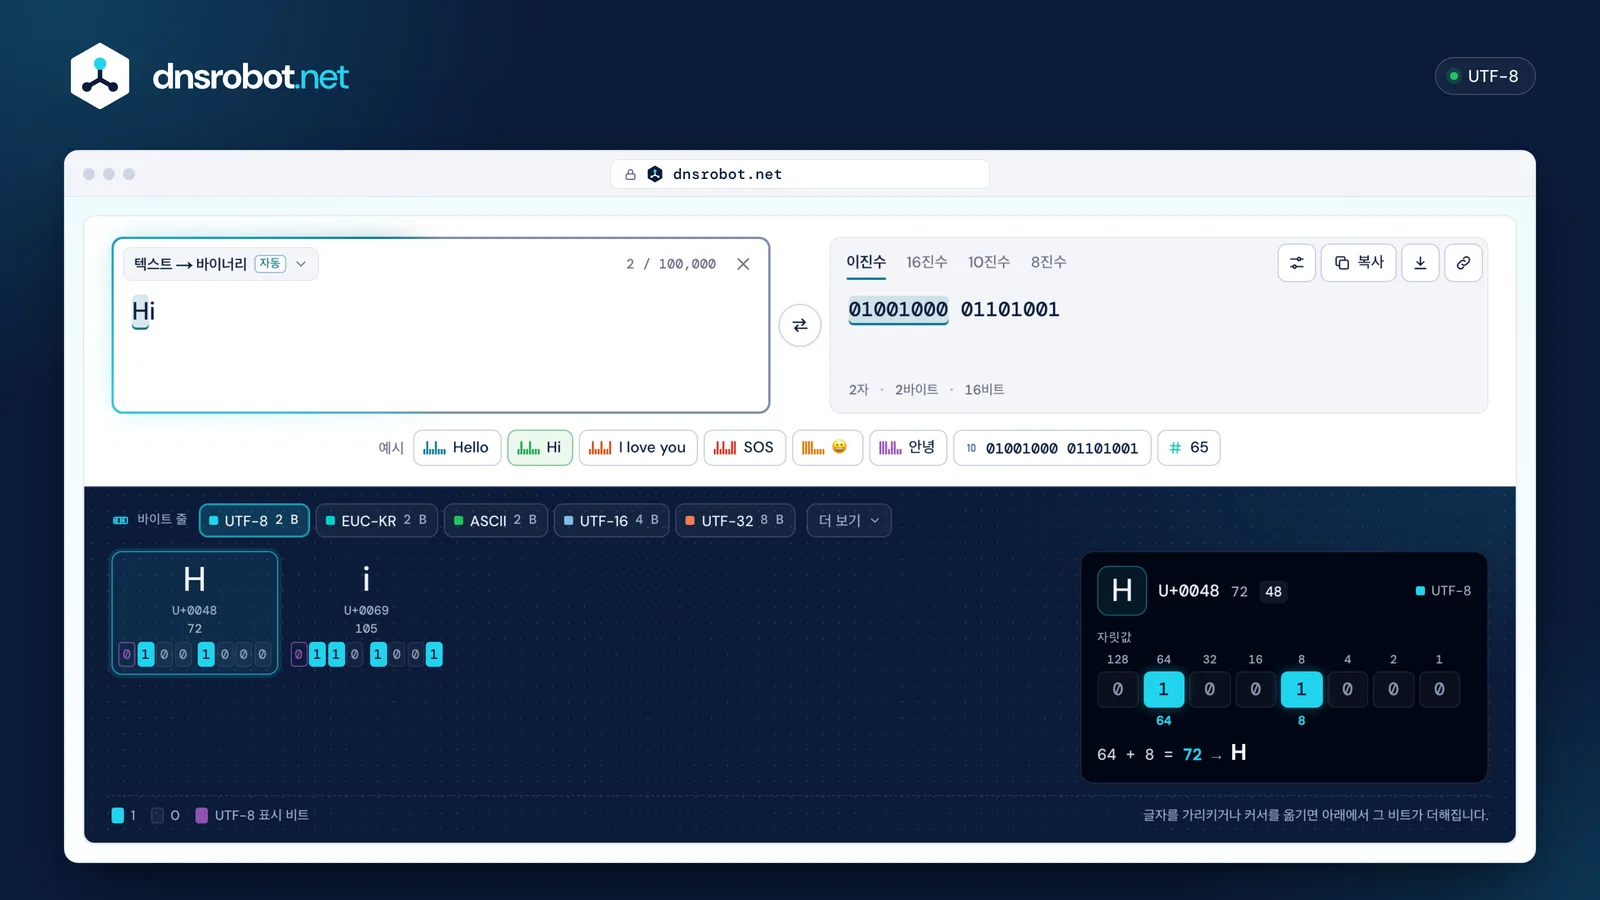
 텍스트 또는 바이너리텍스트를 입력하거나 바이너리, 16진수, 10진수를 붙여넣으세요. 위쪽 표시가 어떻게 읽었는지 알려 주며, 직접 고를 수도 있습니다.결과이진수, 16진수, 10진수, 8진수 중 원하는 형식으로 보고, 복사하거나 다운로드하거나 링크로 공유합니다.인코딩기본은 UTF-8입니다. ASCII, UTF-16, 옛 코드 페이지에서는 같은 텍스트도 다른 바이트가 됩니다.바이트 줄모든 글자를 코드 포인트와 바이트로 보여 주며, UTF-8의 표시 비트는 따로 색을 입힙니다.비트 더하기바이트를 선택하면 자릿값이 보입니다. 64 + 8 = 72, 글자 H입니다.
텍스트를 바이너리 코드로 변환하는 방법은?
글자마다 번호를 찾아 그 번호를 여덟 자리 이진수로 쓰고, 바이트를 이어 붙입니다. H는 72, 곧 01001000이므로 ‘Hi’는 01001000 01101001입니다.
컴퓨터는 텍스트를 공통의 표에 정해진 번호로 저장합니다. ASCII와 UTF-8에서 영어 알파벳, 숫자, 흔한 기호는 모두 1바이트, 즉 8비트로 쓴 0~255의 수입니다. 수를 이진수로 쓰려면 2의 거듭제곱으로 나눕니다. 72 = 64 + 8이므로 64와 8 자리의 비트는 1, 나머지는 0입니다. 영어 알파벳이 아닌 글자는 UTF-8에서 2~4바이트를 차지합니다.
- HU+0048= 720x481바이트01001000
- iU+0069= 1050x691바이트01101001
- éU+00E9= 2330xC30xA92바이트1100001110101001
Hi01001000 01101001
바이너리 코드는 어떻게 읽나요? 바이너리 텍스트 변환 단계
비트를 8개씩 끊고, 1인 자리의 자릿값(128, 64, 32, 16, 8, 4, 2, 1)을 더한 뒤 그 번호의 글자를 찾습니다. 01001000은 64 + 8 = 72, 글자 H입니다.
바이트의 맨 왼쪽 비트는 128, 맨 오른쪽 비트는 1의 값을 가집니다. 0으로 시작하는 바이트는 평범한 ASCII이고, 11로 시작하는 바이트는 더 긴 UTF-8 글자의 시작, 10으로 시작하는 바이트는 그 뒷부분입니다. 앞자리 0을 빼고 쓰면 1001000 같은 7비트 묶음이 되는데, 이 번역기는 0을 알아서 채우고, 온전한 바이트가 될 수 없는 묶음이 있으면 알려 줍니다.
64 + 8 = 72 → H
64 + 32 + 8 + 1 = 105 → i
01001000 01101001Hi
바이너리 알파벳: A부터 Z까지 이진수로
대문자는 A = 01000001부터 Z = 01011010까지, 소문자는 a = 01100001부터 z = 01111010까지입니다.
대문자와 소문자는 비트 하나, 곧 32 자리의 비트만 다릅니다. A는 01000001, a는 01100001입니다. 숫자는 0 = 00110000부터 9 = 00111001까지여서 마지막 네 비트가 곧 그 숫자이고, 공백은 00100000입니다. 이 부호들은 1963년에 처음 발표된 ASCII의 것이며(소문자는 1967년에 들어왔습니다), UTF-8도 그대로 이어받았습니다.
- A01000001a01100001
- B01000010b01100010
- C01000011c01100011
- D01000100d01100100
- E01000101e01100101
- F01000110f01100110
- G01000111g01100111
- H01001000h01101000
- I01001001i01101001
- J01001010j01101010
- K01001011k01101011
- L01001100l01101100
- M01001101m01101101
- N01001110n01101110
- O01001111o01101111
- P01010000p01110000
- Q01010001q01110001
- R01010010r01110010
- S01010011s01110011
- T01010100t01110100
- U01010101u01110101
- V01010110v01110110
- W01010111w01110111
- X01011000x01111000
- Y01011001y01111001
- Z01011010z01111010
- 32 자리 비트: 대문자는 0, 소문자는 1
- 첫 비트: 언제나 0(ASCII는 7비트)
- 1
Hello, Hi, I love you를 바이너리 코드로
‘Hello’를 바이너리로 쓰면 01001000 01100101 01101100 01101100 01101111, ‘Hi’는 01001000 01101001, ‘I love you’는 공백을 포함해 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101입니다.
ASCII와 UTF-8에서 영어 알파벳은 한 글자가 1바이트이므로 영어 단어의 바이트 수는 글자 수와 같고, 대문자, 소문자, 공백은 각각 고유한 부호를 가집니다. ‘SOS’는 01010011 01001111 01010011입니다. 맨 위에 아무 단어나 이름을 입력하면 바이너리가 나오고, 입력란 아래의 예시를 골라도 됩니다.
| 단어 | 바이너리(ASCII와 UTF-8) | 비트 |
|---|---|---|
| Hi | 01001000 01101001 | 16 |
| Hello | 01001000 01100101 01101100 01101100 01101111 | 40 |
| Hello World | 01001000 01100101 01101100 01101100 01101111 00100000 01010111 01101111 01110010 01101100 01100100 | 88 |
| I love you | 01001001 00100000 01101100 01101111 01110110 01100101 00100000 01111001 01101111 01110101 | 80 |
| SOS | 01010011 01001111 01010011 | 24 |
| Yes | 01011001 01100101 01110011 | 24 |
| No | 01001110 01101111 | 16 |
| OK | 01001111 01001011 | 16 |
| Love | 01001100 01101111 01110110 01100101 | 32 |
| Thank you | 01010100 01101000 01100001 01101110 01101011 00100000 01111001 01101111 01110101 | 72 |
어떤 글자는 왜 16, 24, 32비트일까요? UTF-8 설명
UTF-8은 영어를 글자당 1바이트로, 나머지는 2~4바이트로 씁니다. é는 2바이트, €와 대부분의 한국어·중국어·일본어 글자는 3바이트, 이모지는 4바이트입니다.
첫 바이트가 글자의 길이를 알려 줍니다. 110으로 시작하면 2바이트, 1110이면 3바이트, 11110이면 4바이트 글자이고, 그 뒤의 바이트는 모두 10으로 시작합니다. 나머지 비트를 이어 붙인 것이 그 글자의 코드 포인트로, é는 U+00E9입니다. 하나로 보이는 이모지도 폭 없는 접합자(ZWJ)로 이은 여러 코드 포인트일 수 있어서, 가족 이모지 👨👩👧는 18바이트입니다. 맨 위의 바이트 줄은 표시 비트를 코드 포인트 자체의 비트와 다른 색으로 보여 줍니다.
- 1바이트8비트AU+004141001000001U+0000 – U+007FASCII: 영어 알파벳, 숫자, 문장 부호
- 2바이트16비트éU+00E9C3 A9110110000111010101001U+0080 – U+07FF악센트가 붙은 라틴 문자, 키릴·그리스·히브리·아랍 문자
- 3바이트24비트한U+D55CED 95 9C11101110110110100101011010011100U+0800 – U+FFFF대부분의 한국어·중국어·일본어, 인도계 문자, €
- 4바이트32비트😀U+1F600F0 9F 98 801111011110000101001111110100110001010000000U+10000 – U+10FFFF이모지와 U+FFFF 위의 다른 글자
- 표시 비트: 바이트 수, 또는 ‘이어짐’
- 글자 자체의 비트
- x: 글자의 비트가 들어갈 자리
ASCII, UTF-8, UTF-16 비교: 어떤 인코딩을 써야 할까요?
UTF-8을 쓰세요. 웹의 표준이며 웹사이트의 약 99%가 사용합니다(W3Techs, 2026년 10월). ASCII는 그중 7비트로 된 영어 전용 부분이고, UTF-16은 대부분의 글자에 2바이트를 씁니다.
같은 단어도 인코딩마다 비트가 다릅니다. ‘Hello’는 UTF-8과 ASCII에서 5바이트, UTF-16에서 10바이트, UTF-32에서 20바이트입니다. 글자당 16비트로 세는 문제라면 UTF-16을 뜻합니다. 오래된 파일은 러시아어의 KOI8-R과 Windows-1251, 서유럽의 Windows-1252, 일본어의 Shift_JIS 같은 옛 코드 페이지를 씁니다. 바이너리가 이상한 기호로 깨진다면 대개 인코딩 때문이니, 도구에서 다른 인코딩을 고르세요.
“Hello” 5자
- UTF-85바이트 · 40비트
- UTF-16BE10바이트 · 80비트
- UTF-32BE20바이트 · 160비트
- ASCII5바이트 · 40비트
- EUC-KR5바이트 · 40비트
“안녕” 2자
- UTF-86바이트 · 48비트
- UTF-16BE4바이트 · 32비트
- UTF-32BE8바이트 · 64비트
- ASCII2자를 쓸 수 없음
- EUC-KR4바이트 · 32비트
글자 하나의 바이트: 한 U+D55C
- UTF-8ED 95 9C
- UTF-16BED5 5C
- UTF-32BE00 00 D5 5C
- EUC-KRC7 D1
65는 숫자일까, 텍스트일까? 10진수 이진수 변환
숫자로서 65는 이진수로 1000001입니다. 텍스트로 입력하면 6과 5라는 두 글자이고, 바이너리로는 00110110 00110101입니다.
수를 이진수로 바꾸려면 2로 거듭 나누고 나머지를 마지막부터 처음까지 거꾸로 읽습니다. 65를 나누면 나머지가 1, 0, 0, 0, 0, 0, 1이므로 1000001입니다. 한 바이트로 채우면 01000001이고, 이것은 대문자 A의 부호이기도 합니다. 맨 위에 숫자만 입력하면 그 값의 이진수와 각 자릿수 글자의 바이너리를 모두 보여 줍니다.
숫자로 본 65
| 수 | 몫 | 나머지 | |
|---|---|---|---|
| 65 | ÷ 2 = | 32 | 1 |
| 32 | ÷ 2 = | 16 | 0 |
| 16 | ÷ 2 = | 8 | 0 |
| 8 | ÷ 2 = | 4 | 0 |
| 4 | ÷ 2 = | 2 | 0 |
| 2 | ÷ 2 = | 1 | 0 |
| 1 | ÷ 2 = | 0 | 1 |
나머지를 아래에서 위로 읽습니다: 1000001
64 + 1 = 65 · 한 바이트로는 01000001 = A
텍스트로 본 ‘65’
- 6U+0036 = 5400110110
- 5U+0035 = 5300110101
두 글자, 두 바이트: 00110110 00110101
ASCII에서 숫자 0부터 9까지는 48부터 57까지이므로 ‘6’은 54입니다.
Python, JavaScript 등으로 텍스트를 바이너리로 변환하는 법
텍스트를 UTF-8 바이트로 인코딩한 뒤 각 바이트를 여덟 자리 이진수로 씁니다. 어느 언어든 짧게 쓰는 방법이 있습니다.
여기 있는 예제는 모두 ‘Hi’를 01001000 01101001로 바꾸고 다시 읽어 들이며, 하나하나 실행해 출력을 확인했습니다. 모두 UTF-8을 쓰므로 이 번역기와 비트가 같습니다. 다른 인코딩으로 쓴 바이트는 비트가 달라지므로, 바꾸는 쪽과 되돌리는 쪽에서 같은 인코딩을 쓰세요.
 Python
text = "Hi"
bits = " ".join(f"{b:08b}" for b in text.encode("utf-8"))
print(bits)
print(bytes(int(b, 2) for b in bits.split()).decode("utf-8"))
Python 3.14, 2026년 10월 25일에서 실행: 위의 줄이 출력됩니다.
 JavaScript
const bits = [...new TextEncoder().encode("Hi")]
  .map((b) => b.toString(2).padStart(8, "0")).join(" ");
console.log(bits);
console.log(new TextDecoder().decode(
  Uint8Array.from(bits.split(" "), (b) => parseInt(b, 2))));
Node.js 22, 2026년 10월 25일에서 실행: 위의 줄이 출력됩니다.
 Java
StringBuilder sb = new StringBuilder();
for (byte b : "Hi".getBytes(StandardCharsets.UTF_8))
    sb.append(String.format("%8s", Integer.toBinaryString(b & 0xFF))
        .replace(' ', '0')).append(' ');
String bits = sb.toString().trim();
System.out.println(bits);
String[] parts = bits.split(" ");
byte[] back = new byte[parts.length];
for (int i = 0; i < parts.length; i++) back[i] = (byte) Integer.parseInt(parts[i], 2);
System.out.println(new String(back, StandardCharsets.UTF_8));
Java 25, 2026년 10월 25일에서 실행: 위의 줄이 출력됩니다.
 C# · .NET
using System.Text;

var bits = string.Join(" ", Encoding.UTF8.GetBytes("Hi")
    .Select(b => Convert.ToString(b, 2).PadLeft(8, '0')));
Console.WriteLine(bits);
Console.WriteLine(Encoding.UTF8.GetString(
    bits.Split(' ').Select(b => Convert.ToByte(b, 2)).ToArray()));
.NET 10, 2026년 10월 25일에서 실행: 위의 줄이 출력됩니다.
 Go
var parts []string
for _, b := range []byte("Hi") {
	parts = append(parts, fmt.Sprintf("%08b", b))
}
bits := strings.Join(parts, " ")
fmt.Println(bits)

var back []byte
for _, p := range strings.Fields(bits) {
	n, _ := strconv.ParseUint(p, 2, 8)
	back = append(back, byte(n))
}
fmt.Println(string(back))
Go 1.25, 2026년 10월 25일에서 실행: 위의 줄이 출력됩니다.
바이너리 코드는 누가 발명했나요?
고트프리트 라이프니츠(Gottfried Leibniz)는 1703년 파리 과학 아카데미에 낸 논문에서 이진수를 설명했지만, 그보다 앞선 1623년에 프랜시스 베이컨(Francis Bacon)이 두 종류의 기호 다섯 개로 글자를 쓰는 방법을 발표했습니다. 컴퓨터가 쓰는 8비트 텍스트 부호는 ASCII(1963년)와 UTF-8(1992년)에서 발전했습니다.
1870년대 에밀 보도(Émile Baudot)의 전신 부호는 글자 하나를 켜짐·꺼짐 다섯 단위로 나타냈습니다. 1974년에는 아레시보(Arecibo) 전파 망원경이 1,679비트로 된 그림을 우주로 보냈고, 2021년 2월에는 NASA의 탐사 로버 퍼서비어런스(Perseverance)가 ‘Dare mighty things’(과감히 도전하라)를 바이너리로 새긴 낙하산을 펴고 화성에 착륙했습니다. 각 글자는 알파벳에서의 순서로 나타냈습니다.
1623
베이컨의 두 글자 알파벳
프랜시스 베이컨(Francis Bacon)은 a와 b 두 종류의 기호 다섯 개로 모든 글자를 썼습니다. 32가지 조합으로 당시 24자 알파벳을 모두 담았습니다. 1605년에 넌지시 알렸고 1623년에 전부 발표했습니다.
aaaaa · aaaab · aaaba · aaabb … 2⁵ = 32
출처: archive.org
1703
라이프니츠의 이진 산술
고트프리트 라이프니츠(Gottfried Leibniz)는 1703년 파리 과학 아카데미에 낸 논문에서 0과 1만으로 세는 법을 설명했습니다.
1 · 10 · 11 · 100 · 101 · 110 · 111
출처: gallica.bnf.fr
1870년대
보도의 5단위 부호
에밀 보도(Émile Baudot)의 인쇄 전신기는 글자 하나를 켜짐·꺼짐 다섯 단위로 보냈습니다. 그 후신인 ITA2는 지금도 ITU-T 권고(S.1)입니다.
5 → 2⁵ = 32
출처: itu.int
1948
‘비트’
클로드 섀넌(Claude Shannon)의 A Mathematical Theory of Communication은 binary digit을 줄인 비트를 정보의 단위로 쓰며, 이 말은 John W. Tukey가 지었다고 밝힙니다.
bit = binary digit
1956
‘바이트’
베르너 부흐홀츠(Werner Buchholz)가 1956년 6월 IBM에서 1~6비트 묶음을 가리키려고 이 말을 만들었고, IBM의 System/360(1964년)이 8비트로 굳혔습니다.
1–6 bits → 8 bits
1963
ASCII
미국규격협회(American Standards Association)가 1963년 6월 17일 ASCII를 승인했습니다. 7비트에 담은 128개 부호입니다.
A = 1000001
1974
아레시보 메시지
1974년 11월 16일 아레시보(Arecibo) 전파 망원경이 1,679비트를 우주로 보냈습니다. 1,679 = 73 × 23, 곧 소수 둘의 곱이라서 비트를 배열할 격자는 하나뿐이고, 그것이 그림이 됩니다.
1,679 = 73 × 23
23 × 73출처: news.cornell.edu
1992
UTF-8
켄 톰프슨(Ken Thompson)이 1992년 9월 롭 파이크(Rob Pike)가 세운 조건에 맞춰 벨 연구소의 Plan 9를 위해 UTF-8을 설계했습니다. ASCII는 1바이트로 두고 어떤 글자든 최대 4바이트로 씁니다.
é = 11000011 10101001
출처: cl.cam.ac.uk
2021
화성에 남긴 메시지
2021년 2월 18일 퍼서비어런스(Perseverance)의 낙하산은 주황색과 흰색 조각으로 ‘DARE MIGHTY THINGS’(과감히 도전하라)를 보여 주었습니다. 글자마다 알파벳에서의 순서를 바이너리로 나타낸 것입니다(A = 1).
DARE → 4 1 18 5 → 100 1 10010 101
바이너리 코드: 자주 묻는 질문
바이너리 코드란 무엇인가요?
바이너리를 영어 텍스트로 번역하려면 어떻게 하나요?
‘hello’는 바이너리로 어떻게 쓰나요?
‘I love you’를 바이너리로 쓰면 어떻게 되나요?
글자 하나는 몇 비트인가요?
01001000 01101001은 무슨 뜻인가요?
공백 없이 바이너리를 붙여넣어도 되나요?
이진수 10101은 무슨 뜻인가요?
바이너리가 �처럼 이상한 기호로 깨지는 이유는 무엇인가요?
ASCII는 7비트인가요, 8비트인가요?
65는 이진수로 무엇인가요?
입력한 텍스트가 서버로 전송되나요?
부족한 점이 있습니까?기능 또는 새 도구 제안하기
관련 도구
모스부호 변환기
글자와 모스부호를 서로 변환하고 소리·빛·진동으로 재생, 녹음이나 사진에서 해독
작은 텍스트 생성기
텍스트를 44가지 Unicode 폰트 스타일로 변환 — 작은 텍스트, 굵게, 기울임, 필기체 등
공백문자
보이지 않는 공백문자를 복사해 붙여넣고, 텍스트에 숨은 문자를 찾아 제거
IP를 10진수로 변환
IP 주소와 10진수·16진수·2진수·8진수 상호 변환, 옥텟별 자릿값 표시
서브넷 계산기
IPv4·IPv6 블록의 네트워크, 브로드캐스트, 사용 가능한 호스트, 마스크 계산과 VLSM, 분할, 클라우드 서브넷
UUID 생성기
UUID v4, v7, v1, v5, v3 또는 GUID를 원하는 형식으로 대량 생성하고, UUID의 버전과 타임스탬프를 디코딩