











メタタグチェッカー
数えるのではなく測るメタタグチェッカーです。ページのタイトルとメタディスクリプションをピクセルで測り、Googleの検索結果でどこが切れるかを示したうえで、ページがインデックス可能か、シェアしたときにリンクがどう見えるかを確認します。
Googleがheadを読むのと同じように当サイトのサーバーからページを読み、タイトルとディスクリプションをピクセルで測定します。
メタディスクリプションの文字数はどのくらいにすべき?
ページを説明するのに必要なだけです。Googleは上限を設けておらず、スニペットは文字数ではなく画面の幅に合わせて切られます。第三者の測定では、その表示幅はパソコンで約920ピクセル、スマートフォンで約680ピクセルです。全角の文字は英字のおよそ2倍の幅があるため、当ツールの測定では、日本語の文ならおよそ70文字と55文字で埋まります。英文の約半分の文字数です。
Googleの言葉では、「メタディスクリプションの長さに制限はありませんが、Google検索の結果では、スニペットは必要に応じて、通常はデバイスの幅に合わせて切り詰められます」(Google)。単位が幅なので、決め手は文字の形です。Arialの14 pxで測ると、iiiiiiは幅19 px、WWWWWWは79 pxです。日本語の文字は全角なので、同じ表示幅に入る文字数は英文のおよそ半分になります。分かち書きをする韓国語では、およそ3分の2です。
よく言われる「155〜160文字」が上限ではなく目安にすぎないのはそのためで、文字数を数えるメタディスクリプションチェッカーは、どちらの方向にも間違えることがあります。下の図の架空のディスクリプションは59文字で、14 pxでの幅は826 pxです。パソコンの約920 pxには余裕をもって収まりますが、スマートフォンの約680 pxからは146 pxはみ出します。「155〜160文字」よりずっと短いのに、スマートフォンでは切れるのです。「50〜60文字、つまり580ピクセル」のような助言は、2つの単位を置き換え可能なものとして扱っていますが、そうではありません。
長さはランキングに影響しません。Googleは2009年に、ディスクリプションをランキングに使っていないと述べており、ドキュメントにも、ディスクリプションが長いことや、ないことへのペナルティは書かれていません。また、Googleは多くの場合、ページから独自のスニペットを作ります。第三者による2つの調査では、約3件に2件の検索結果でディスクリプションが置き換えられていました。読み手のために書きましょう。そのページ固有の、内容を本当に要約したもので、キーワードの羅列にはせず、大事な語を先に置いてください。
Googleが文字数を数える唯一の場所は、robotsルールのmax-snippetです。その数値は文字数で、0はスニペットなし、-1は長さをGoogleに任せることを意味します(Google)。
登山靴はすべて返品無料です。防水レザーとすべりにくいソールで、2年保証付き。午後3時までのご注文で翌日にお届けします。
登山靴はすべて返品無料です。防水レザーとすべりにくいソールで、2年保証付き。午後3時までのご注文で翌日にお届けします。
表示幅は第三者による観測値です。Googleは公表していません。
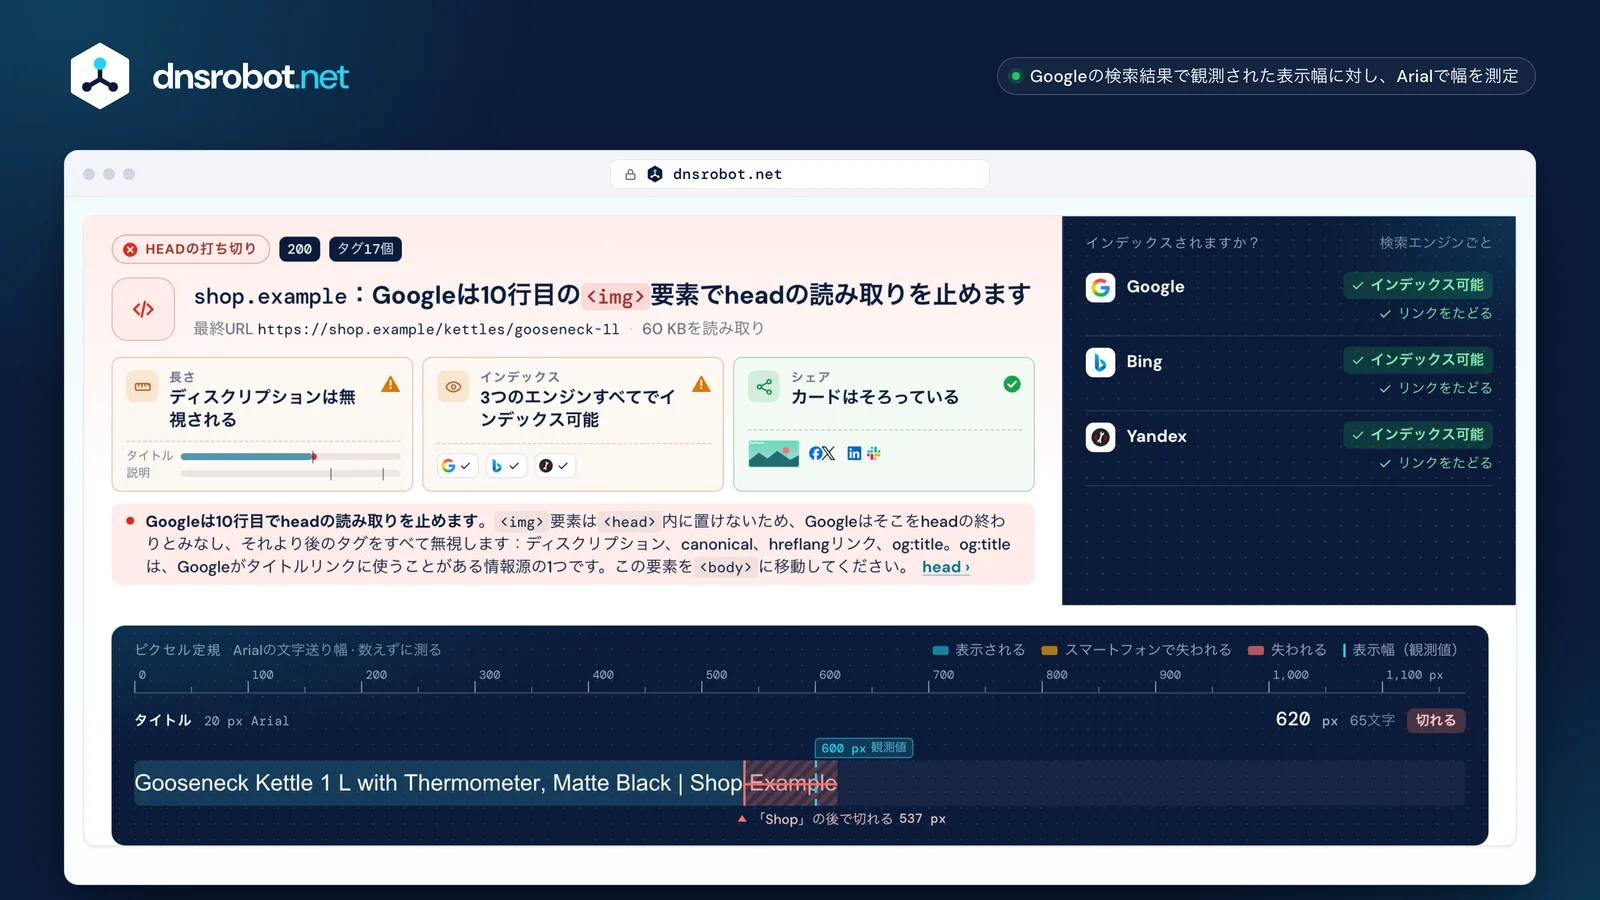
 数えずに測る検索結果のページが描くサイズのタイトルとディスクリプションです。定規が、パソコンとスマートフォンでそれぞれどこで切れるかを示します。検索エンジンごとのインデックス判定robots metaタグとX-Robots-Tagヘッダーを、Google、Bing、Yandexそれぞれの読み方で判定します。Googleが読まないものheadを早く終わらせてしまう要素、その行、それが隠すすべてのタグです。シェアしたときの見え方FacebookとXがタグから作るカードと、ファイルから読み取った画像の実際のサイズです。
titleタグの文字数はどのくらいが適切?
ページを言い表せるだけの長さで、約600ピクセルに収まる短さです。これは第三者がパソコンのタイトルリンクについて測った表示幅で、第三者の目安では一般的な英文でおよそ50〜60文字、当ツールの測定では日本語で約30〜35文字です。Google自身は上限を設けておらず、タイトルリンクを「デバイスの幅に合わせて」切ります。
Googleのタイトルリンクのガイドには「<title>要素の長さに制限はありません」とありますが、「不必要に長い、または冗長な」テキストは避けるよう求めています。2,370サイトの80,959件のタイトルの調査では、70文字を超えるタイトルはほぼ毎回、51〜55文字のタイトルも約40%の割合で、Googleに書き換えられていました。
<title>は入力の1つであり、出力ではありません。Googleはタイトルリンクを、title要素、ページ上で目立つメインのタイトル、<h1>などの見出し、og:title、そのほかの目立つテキスト、アンカーテキスト、ページを指すリンクのテキスト、WebSiteの構造化データから自動的に作ります。タイトルがない、定型文である、キーワードを詰め込んでいる、ページと別の言語や文字体系で書かれている場合は、置き換えられます。
ですから、ページごとに説明的な独自のタイトルを付け、サイト名は先頭か末尾に1回だけ入れてパイプなどの区切り文字で区切り、「ホーム」のようなあいまいなタイトルは避けてください。Googleはどちらからもタイトルリンクを取ることがあるため、上のチェッカーはページの最初の<h1>も読み取ります。
- 1title要素
- 2ページ上に表示されるメインのタイトル
- 3h1などの見出し
- 4og:titleタグ
- 5そのほかの大きく目立つテキスト
- 6ページ上のそのほかのテキスト
- 7ページ上のアンカーテキスト
- 8ページを指すリンクのテキスト
- 9WebSiteの構造化データ
noindexチェッカー:ページがnoindexかどうかを確認するには?
2か所を確認します。HTML内のrobots metaタグと、HTTPヘッダーのX-Robots-Tagです。ヘッダーはページのソースには表示されないため、HTMLだけを読むnoindexチェッカーは、インデックスされないページをインデックス可能と判定してしまうことがあります。このツールは両方を、Google、Bing、Yandexのそれぞれについて読み取ります。
noindexタグとヘッダーには同じルールを書くことができ、Googleはそれらを合算します。ヘッダーにnoindex、タグにallがある場合、「より制限の厳しいルールが適用される」ため、ページはnoindexになります(Google)。noneはnoindex, nofollowを意味し、Google自身のnoindexのページはnofollowをヒントと呼んでいます。タグがまったくなければ、デフォルトはindex, followです。HTTPヘッダーチェッカーでは、ページが送るすべてのヘッダーを確認できます。
Yandexは競合を逆の方向で解決します。「許可する指示は、禁止する指示と組み合わされた場合に優先されます」。そのため、noindex, followの横にallがあれば、Yandexではインデックスされたままです(Yandex)。上の判定がすべてのエンジンにまとめて1回ではなく、エンジンごとに出るのはそのためです。
落とし穴はrobots.txtです。そこでブロックされたURLは取得されないため、そのnoindexも読まれず、ほかのページからリンクされていれば検索結果に表示されることもあります(Google)。ページを除外するには、クロールを許可したうえでnoindexを付けてください。robots.txtに書いたnoindexはまったくサポートされていません。また、新しいnoindexが効くのはGoogleがページを再クロールしてからで、それには数か月かかることがあります。
X-Robots-Tag: noindex| 検索エンジン | 競合の解決方法 | このページ |
|---|---|---|
| 最も制限の厳しいルールが優先 | 除外 | |
| Bing | 最も制限の厳しいルールが優先ルールの公表なし:Googleと同じに解釈 | 除外 |
| Yandex | 許可するルールが優先 | インデックス可能 |

robots.txtでブロック:ページは取得されないため、そのnoindexも読まれません。
Googleが一部のメタタグを無視するのはなぜ?
多くの場合、<img>や<iframe>のように<head>に属さない要素が、それらより上にあるためです。Googleはその要素をheadの終わりとみなし、それより後の要素をすべて無視します(Google)。
headで有効な要素は、title、meta、link、script、style、base、noscript、templateの8つだけです。タグのスニペットと一緒に貼り付けたトラッキングピクセル、紛れ込んだ<div>、埋め込みの<iframe>はheadを早く終わらせ、その下にあるcanonical、hreflangリンク、ディスクリプションは、どこにもエラーが出ないまま失われます。ファイル内のタグを集めるだけのメタタグ分析ツールは、それでもすべてを「あり」と報告します。
すべてが失われるわけではありません。Googleはbody内のrobots metaタグにも従うため、打ち切り以降のnoindexは引き続き有効です。canonicalはそうではありません。Googleはhead内でしか受け付けません(Google)。上のチェッカーは、その要素と行を示し、Googleが読まなくなったタグを一覧にします。
JavaScriptが追加・変更するタグも、もう1つの死角です。Googleはできるだけそれを避け、canonicalはHTMLのソースで設定するよう勧めているため(Google)、このチェッカーはサーバーが送るHTMLを読みます。
<meta charset="utf-8"><title>防水トレッキングシューズ メンズ・レディース 返品無料|サンプルストア</title><link rel="stylesheet" href="/theme.css"><img src="https://px.example/p.gif" alt="">Googleはここで止まる<meta name="description" content="登山靴はすべて返品無料です。防水レザーとすべ…">Googleは無視<link rel="canonical" href="https://store.example/boots">Googleは無視<link rel="alternate" hreflang="de" href="https://store.example/de/stiefel">Googleは無視<meta name="robots" content="max-snippet:160">引き続き有効:robotsタグはbody内でも有効canonicalタグの役割は?
同じ内容を持つ複数のURLのうち、どれを表示してほしいかを検索エンジンに伝えるもので、ルールではなくヒントです。「Googleは、あなたとは別のページを正規ページとして選ぶことがあります」(Google)。
Googleはこれをほかのシグナルと合わせて判断します。リダイレクトが最も強く、rel=canonicalは強いシグナル、サイトマップは弱いシグナルで、どれも必須ではありません(Google)。表示したいページには自己参照のcanonicalを付け、絶対URLで書き、<head>に置き、hreflang、lang、media、typeを付けないでください。付けると、Googleはcanonicalの選択にそれを使いません。リダイレクトチェッカーは、リダイレクトをすべてのホップまでたどります。
避けたい競合が2つあります。noindexのページのcanonicalは互いに矛盾する合図を送り、Googleはそもそもcanonicalを選ぶためにnoindexを使わないよう勧めています。また、こちらで誰も設定していない別サイトへのcanonicalは確認が必要です。Googleは、挿入された別ドメインのcanonicalをハッキングされたサイトの兆候に挙げています。
言語版どうしは、代わりにhreflangで対応づけます。各版が自分自身とほかのすべての版を完全なURLで挙げ、互いを指していない2つのページは無視されます。コードはISO 639-1の言語に任意でISO 3166-1の地域を添えたもので、en-UKではなくen-GBと書き、es-419はサポートされていません(Google)。各言語版のcanonicalは、同じ言語のURLを指すようにしてください。
同じ内容、複数のURL
http://store.example/bootshttps://store.example/boots?utm_source=mailhttps://www.store.example/bootshttps://store.example/boots/https://store.example/bootsヒント:Googleは別のものを選ぶことがあるシグナル(強い順)
rel=canonicalサイトマップhreflangのペア
/en/boots/de/stiefel相互にリンク:使われる
/en/boots/fr/bottes片方向だけ:無視される
Googleが実際に使うメタタグは?
ごく一部です。description、robotsとgooglebot、notranslate、nopagereadaloud、google-site-verification、Content-Typeとcharsetの宣言、refresh、viewport、ratingだけです。Googleはサポートしていないメタタグを単に無視します(Google)。
Googleが無視するもので最もよく知られているのは、meta keywordsタグです。Googleのドキュメントには、このタグは「Google検索では使用されておらず、インデックス登録やランキングにはまったく影響しません」とあり、Googleは2009年に、このタグの使用をやめたと発表しました。Googleはページの言語の判定にもlang属性を使いません。また、rel=nextとrel=prevはもう何の効果もありません。Open Graphタグのうち、Googleが文書化しているのは、タイトルリンクの情報源の1つとしてのog:titleだけです。
Googleが考慮しない場面でも意味のあるタグがあります。スクリーンリーダーとブラウザはlangを使います。viewportタグがないと、スマートフォンはページを幅約980 CSSピクセルでレイアウトしてから縮小するため、狭い画面向けのスタイルが適用されません(MDN)。Googleは、このタグがあることで、ページがモバイルフレンドリーだとわかると述べています。そして<meta charset>は、ブラウザが探す唯一の範囲である、ファイルの最初の1,024バイト以内に置く必要があります(HTML)。
あと2つ、確認する価値があります。refreshはリダイレクトとして機能しますが、Googleは代わりにサーバー側の301を勧めています。そしてGoogleでは廃止されたnoarchiveは、Bingでは今も、コンテンツをチャットの回答に表示してよいかを決めています(Bing)。
Googleが使う
<meta name="description">スニペットになることがあるrobots · googlebotインデックスとスニペットのルール<title>タイトルリンクの情報源の1つog:titleタイトルリンクのもう1つの情報源viewportモバイルフレンドリーなページの合図として読むcharset最初の1,024バイト内でしか見つからないrefresh機能するが、301のほうがよいGoogleは無視
keywordsインデックスにもランキングにも影響なしrel=next · rel=prevもう使われていないGoogle向けではないが重要
<html lang>言語の判定には使わない。スクリーンリーダーが使うog:imageFacebookとXが使う

noarchiveGoogleでは廃止、Bingが使う情報源
- Google 検索セントラル:スニペット、タイトルリンク、robots metaタグとX-Robots-Tag、noindex、Googleがサポートするメタタグ、有効なページのメタデータ、正規URL、各言語版のページ
- HTML Living Standard(title、description、文字エンコーディング)とviewport metaタグに関するMDNの解説
- The Open Graph protocolと、Meta for Developersのシェア画像の解説
- 最後に公開されたXのカードのドキュメント(Internet Archiveから参照):マークアップとsummary_large_image
- robots metaの指示に関するYandexの解説とBing Webmaster Blog
- Googleの公表値ではない観測値:Zyppyのタイトル調査などの第三者の調査による表示幅と書き換え率。このページの幅は、当ツールがArialで測定したものです
メタタグチェッカーのよくある質問
メタディスクリプションの文字数の上限は?
titleタグは何文字までにすべき?
ページがnoindexかどうかを確認するには?
noindex, nofollowとはどういう意味?
robots.txtでブロックするのとnoindexを使うのは、どちらがよい?
robots metaタグとX-Robots-Tagの違いは?
Googleが自分の設定と違うメタタイトルやディスクリプションを表示するのはなぜ?
Facebook向けのOGP(Open Graphタグ)を確認するには?
Twitter Card Validatorは今も使えますか?
Googleは今もmeta keywordsタグを使いますか?
viewportメタタグは必要ですか?
このメタタグチェッカーはJavaScriptを実行しますか?
足りないものはありますか?機能や新しいツールを提案する
OGP(Open Graphタグ)とTwitterカードとは?
リンクがシェアされたときに表示されるタイトル、テキスト、画像を決めるメタタグです。Open Graphには
og:title、og:type、og:image、og:urlの4つの必須プロパティがあります(OGP)。Xは独自のtwitter:タグを読み、足りない分はこれらのogタグで補います。Facebookは、1200 × 630 px以上で、1.91:1に近く、8 MB以下の画像を求めています。リンク投稿の最小サイズは600 × 315 pxで、200 × 200 px未満のものは受け付けません(Facebook)。
og:image:widthとog:image:heightを追加してください。これらがないと、クローラーは先に画像をダウンロードする必要があるため、最初にリンクをシェアした人には画像が表示されません。OGPチェッカーとして、このページは画像の実際のサイズをファイルそのものから読み取ります。Xが最後に公開したカードのドキュメント(2023年12月にアーカイブ)は、
summary_large_imageには300 × 157 px以上の2:1の画像、summaryには144 × 144 px以上の正方形を求め、いずれも5 MB未満で、SVGは不可としていました(X、アーカイブ)。twitter:タグがなければ、Xはog:title、og:description、og:imageを使いますが、twitter:cardで大きなカードを指定するまでは、小さなsummaryカードしか表示しないことがあります。どちらのSNSも読み取った内容をキャッシュします。Facebookは画像のURLが変わるまで画像を保持します。そのSharing Debuggerはページを再スクレイピングでき、Facebookへのログインが必要です。Xには、今は誰でも使えるCard Validatorがありません。2026年10月26日の時点で、そのアドレスはログイン画面に移り、その後エラーになりました。残る現実的な確認方法は、新しい投稿にリンクを貼り付け、公開せずに確認することです。
summary_large_imagesummarytwitter:タグがない場合、Xはog:title、og:description、og:imageで代用します。